Subiect: #TTS
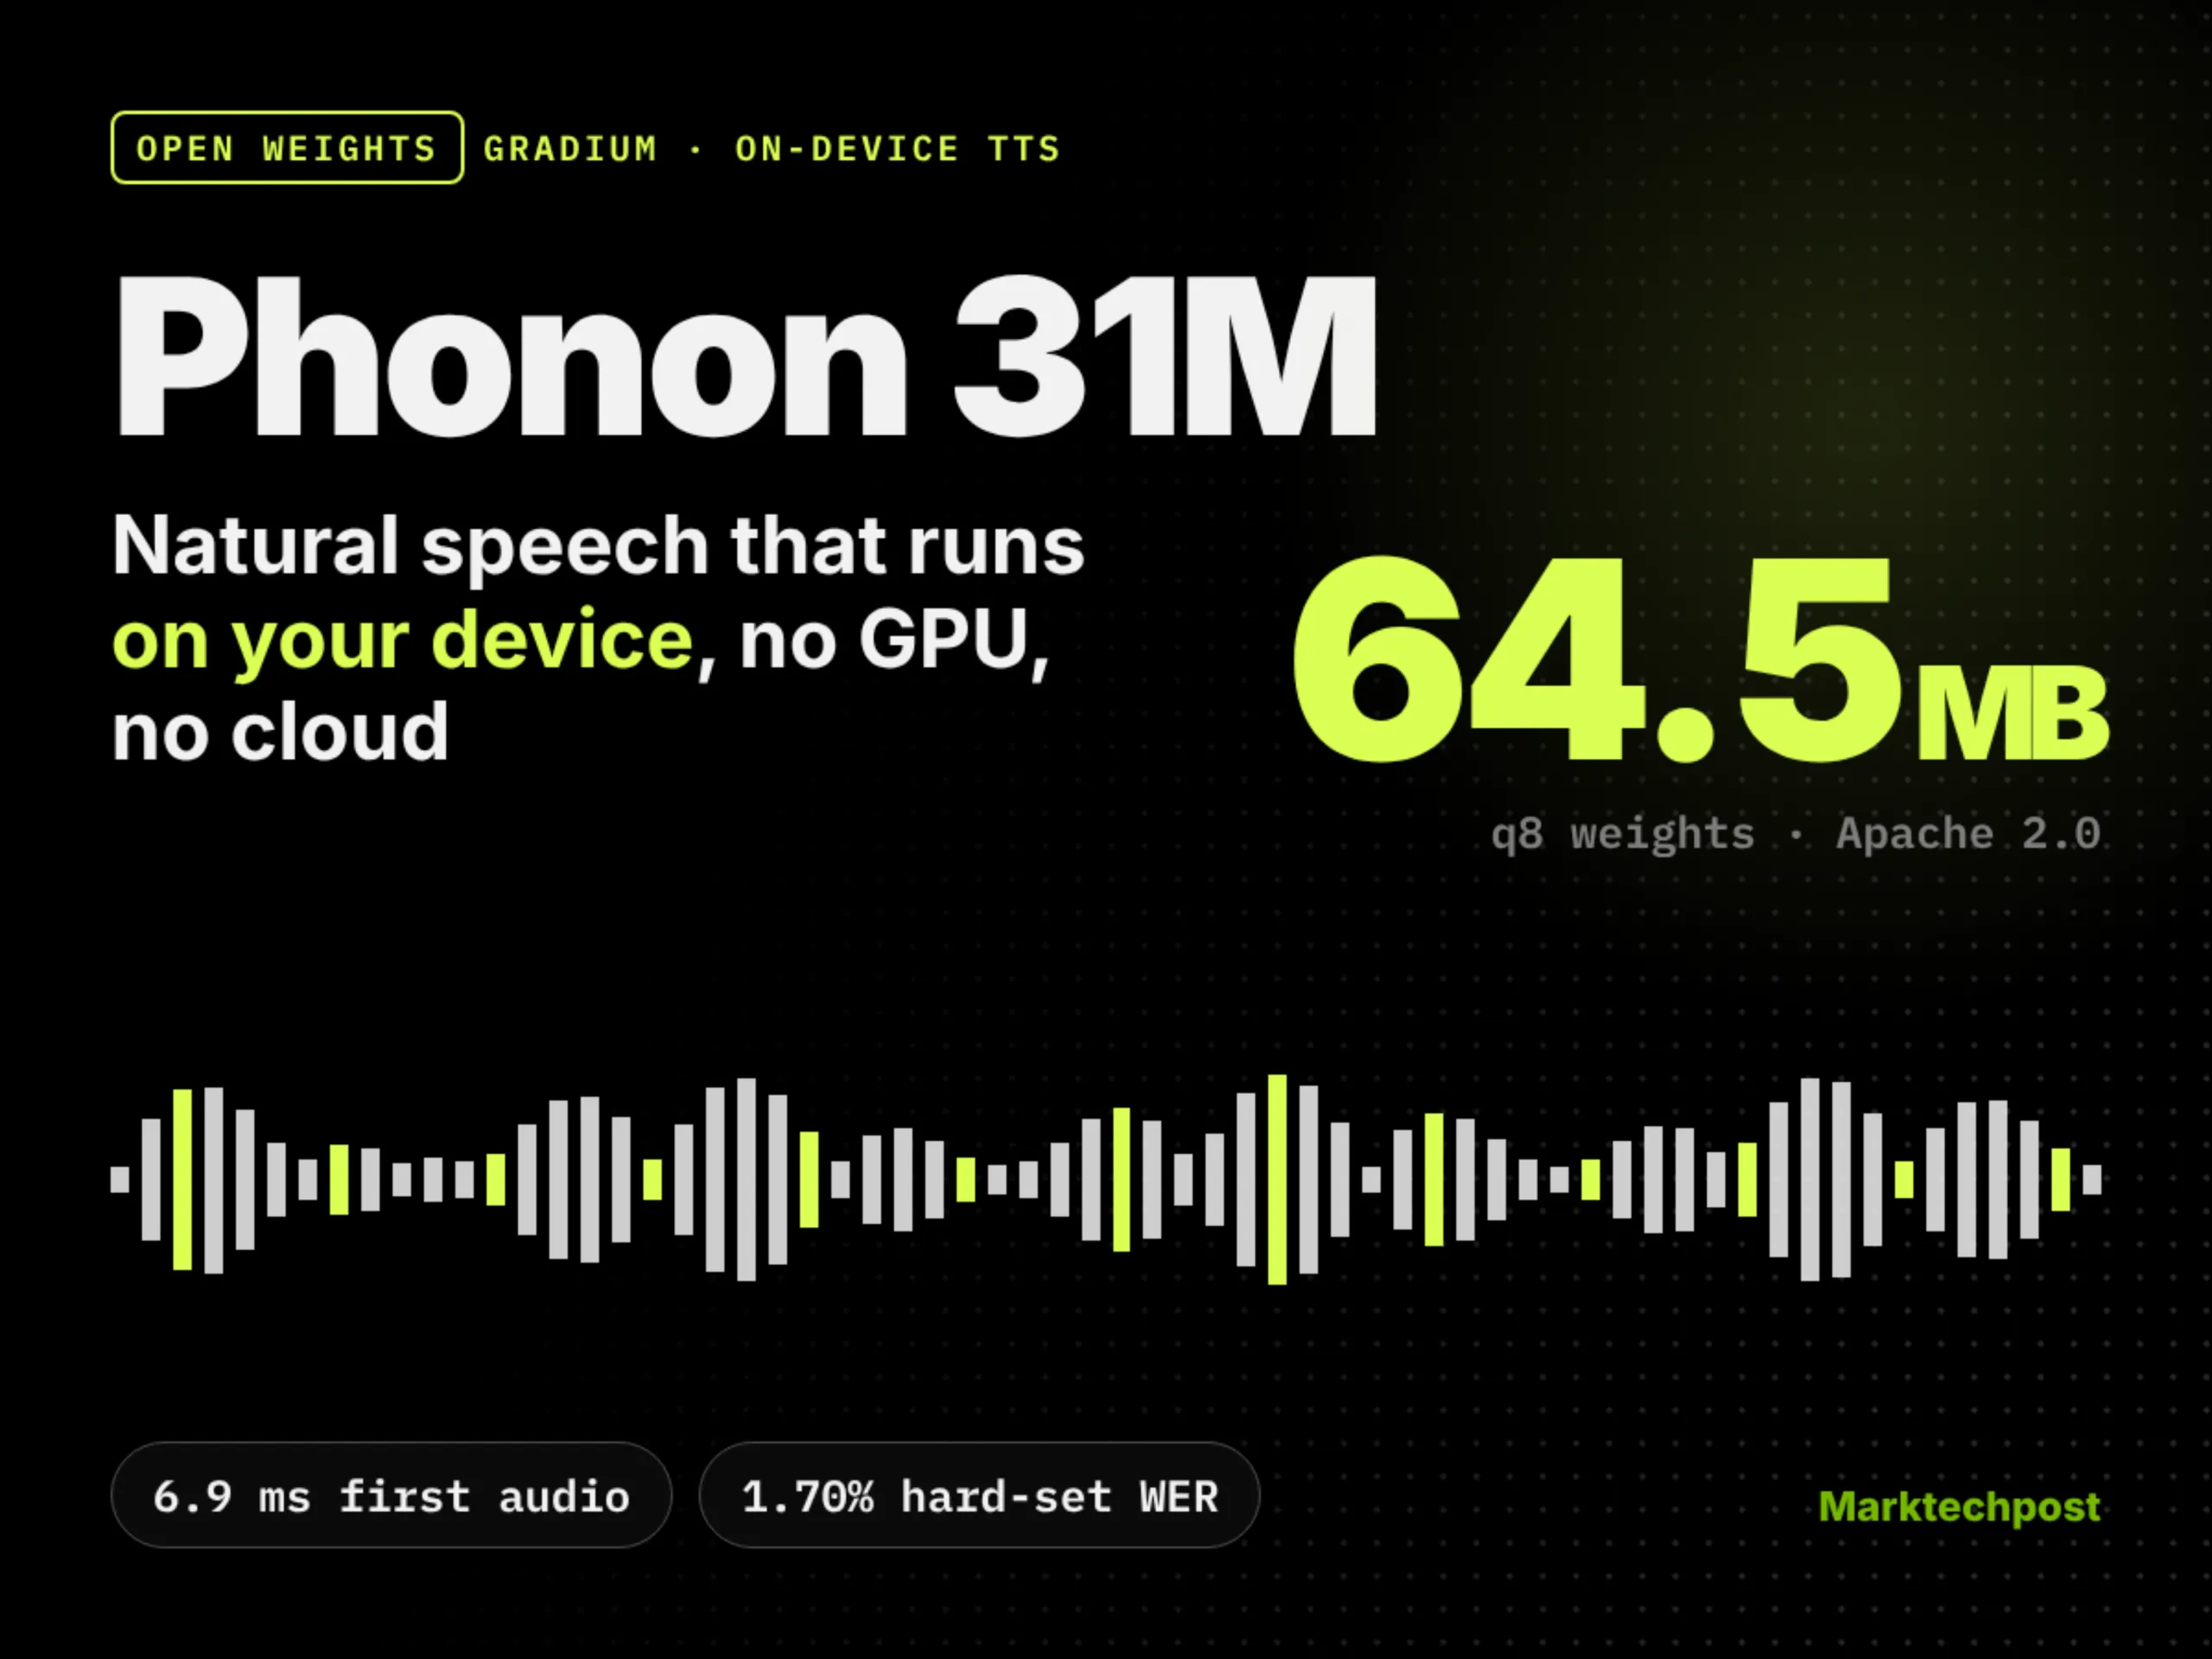
Gradium deschide sursa Phonon: un model TTS de 31M parametri pentru dispozitive, sub licență Apache 2.0
Gradium lansează Phonon, un model TTS de 31M parametri optimizat pentru rulare locală pe dispozitive (mobile, embedded, browser), sub licența permissivă Apache 2.0. Articolul analizează arhitectura, performanțele, avantajele licenței, compromisurile de calitate și impactul pe ecosistemul de voice AI.
Fish Audio lansează Drama 3: modelul TTS cu 35 de miliarde de parametri care zguduie piața de voce artificială
Fish Audio lansează Drama 3, un model TTS cu 35 de miliarde de parametri, arhitectură MoE și greutăți deschise publicului. Calitate de nivel ElevenLabs, suport pentru limba română și oportunități majore pentru dezvoltatorii independenți.
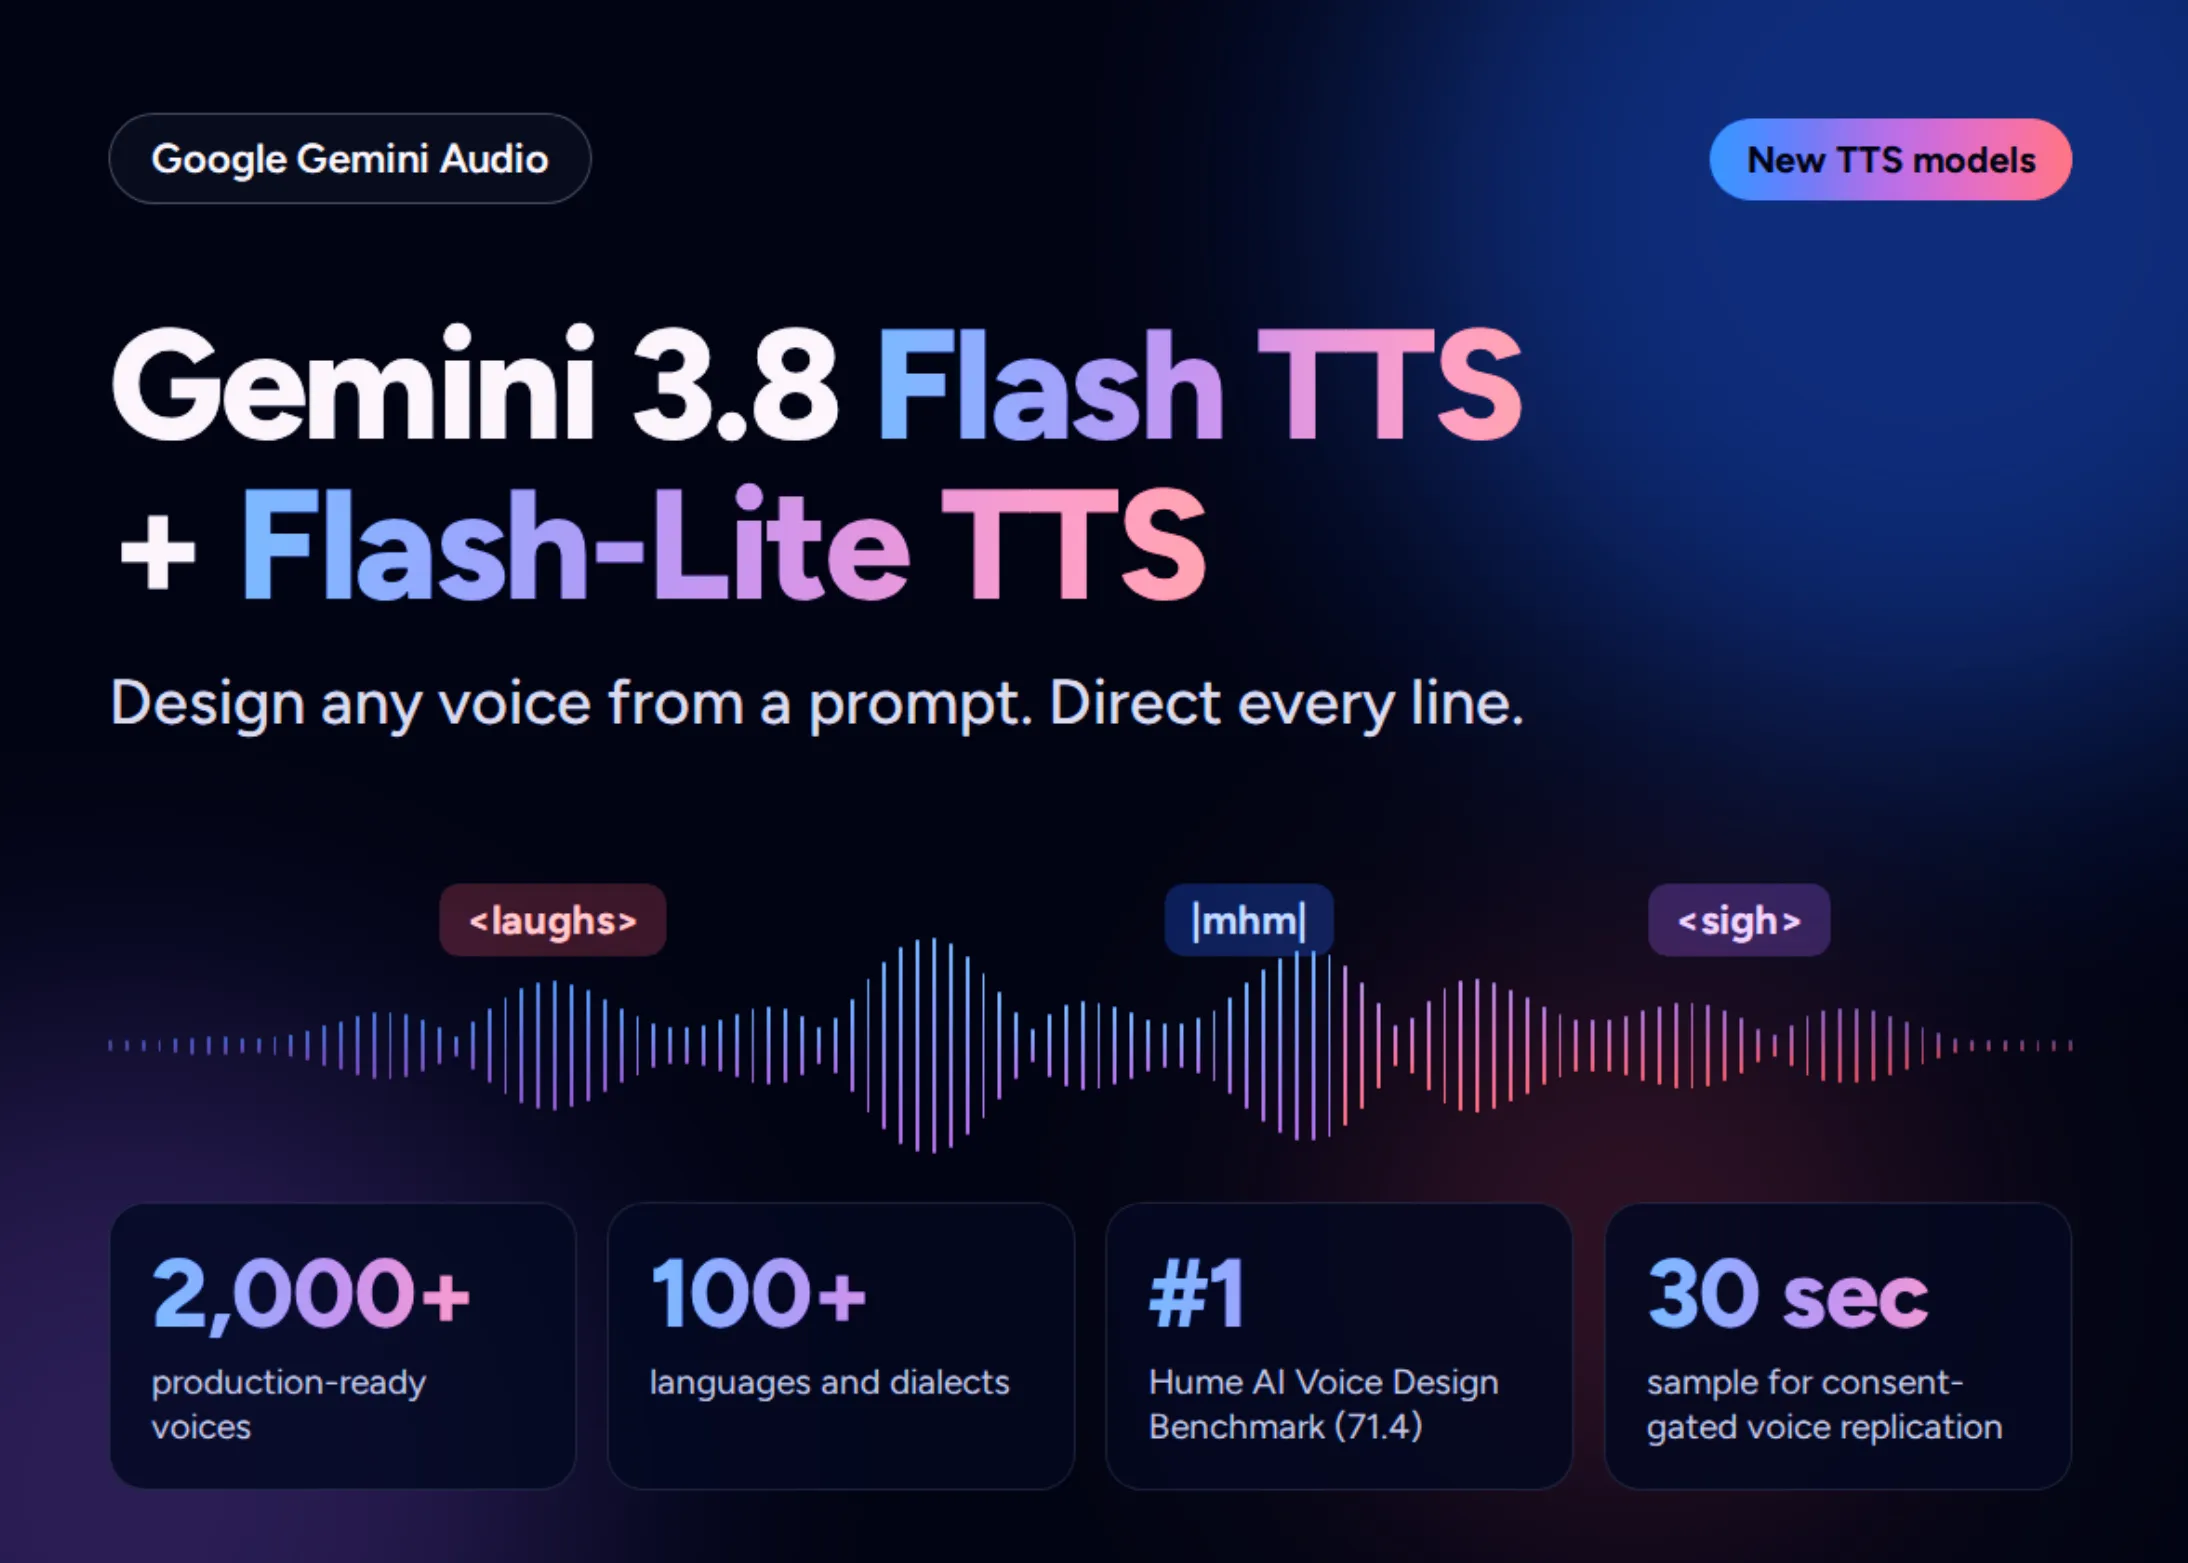
Google lansează Gemini 3.8 Flash TTS și Flash-Lite TTS: vocea se proiectează acum prin prompt, nu prin studio
Google a lansat Gemini 3.8 Flash TTS și Flash-Lite TTS, două modele de sinteză vocală care permit proiectarea vocii direct prin prompt. Anunțul promite să democratizeze producția audio, dar ridică și întrebări serioase despre consimțământ, identitate și viitorul actorilor vocali.
Gradium AI revoluționează sinteza vocală: noul model TTS atinge 81% succes pe cazuri dificile în doar 216 milisecunde
Gradium AI lansează un nou model TTS cu o rată de succes de 81% pe cazuri dificile și o latență de doar 216 ms până la primul audio. Descoperă cum această inovație redefinește standardele sintezei vocale și ce înseamnă pentru dezvoltatori și utilizatori.

Cartesia lansează Sonic-3.6: modelul TTS streaming care domină ambele arene de vorbire de la Artificial Analysis
Cartesia a lansat Sonic-3.6, un model TTS streaming care a urcat pe primul loc în ambele arene de vorbire de la Artificial Analysis, combinând calitate vocală excepțională cu latență redusă. Descoperă ce înseamnă această performanță pentru industria AI și pentru utilizatori.
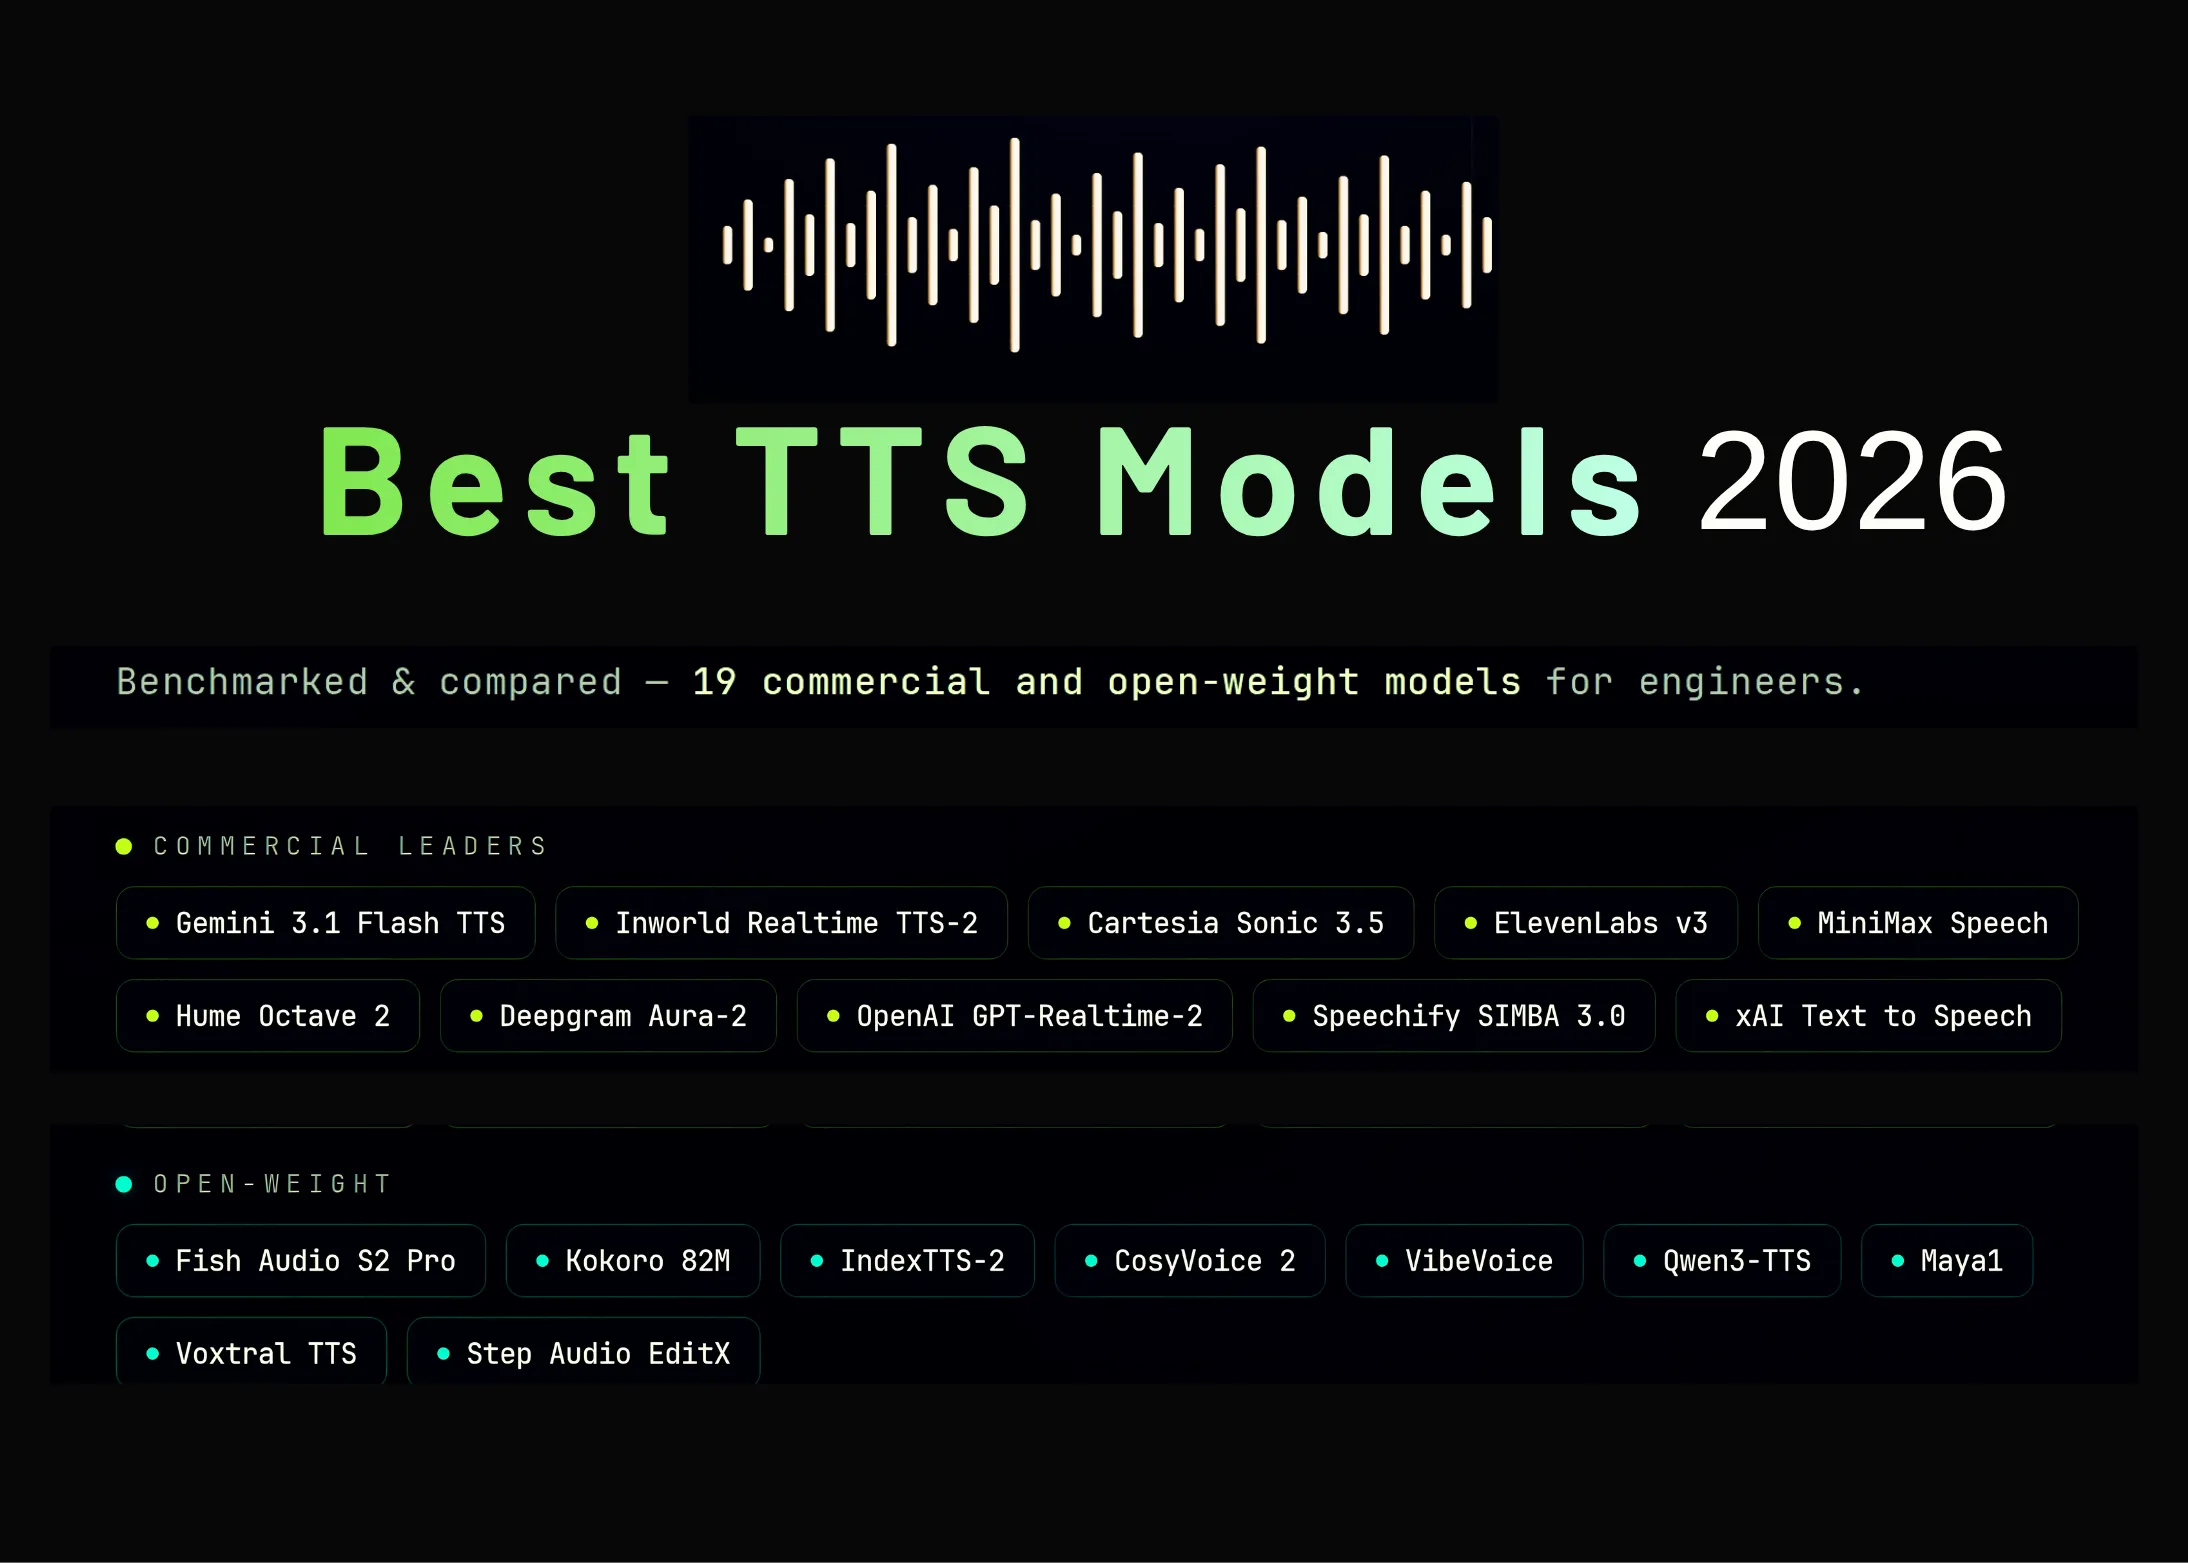
Cele mai bune modele Text-to-Speech (TTS) în 2026: O comparație bazată pe benchmark-uri
Descoperă cele mai bune modele Text-to-Speech din 2026, analizate pe baza benchmark-urilor de naturalete, viteză și suport multilingv. De la ElevenLabs la Google și Microsoft, află care se potrivește nevoilor tale.
Tutorial Practic de Programare pentru Microsoft VibeVoice: ASR cu Detectare a Vorbitorului, TTS în Timp Real și Pipeline-uri Speech-to-Speech
Un ghid complet și practic pentru dezvoltatori care doresc să implementeze Microsoft VibeVoice, acoperind recunoașterea vocală cu identificarea vorbitorului, sinteza vocală în timp real și construirea pipeline-urilor speech-to-speech complete.