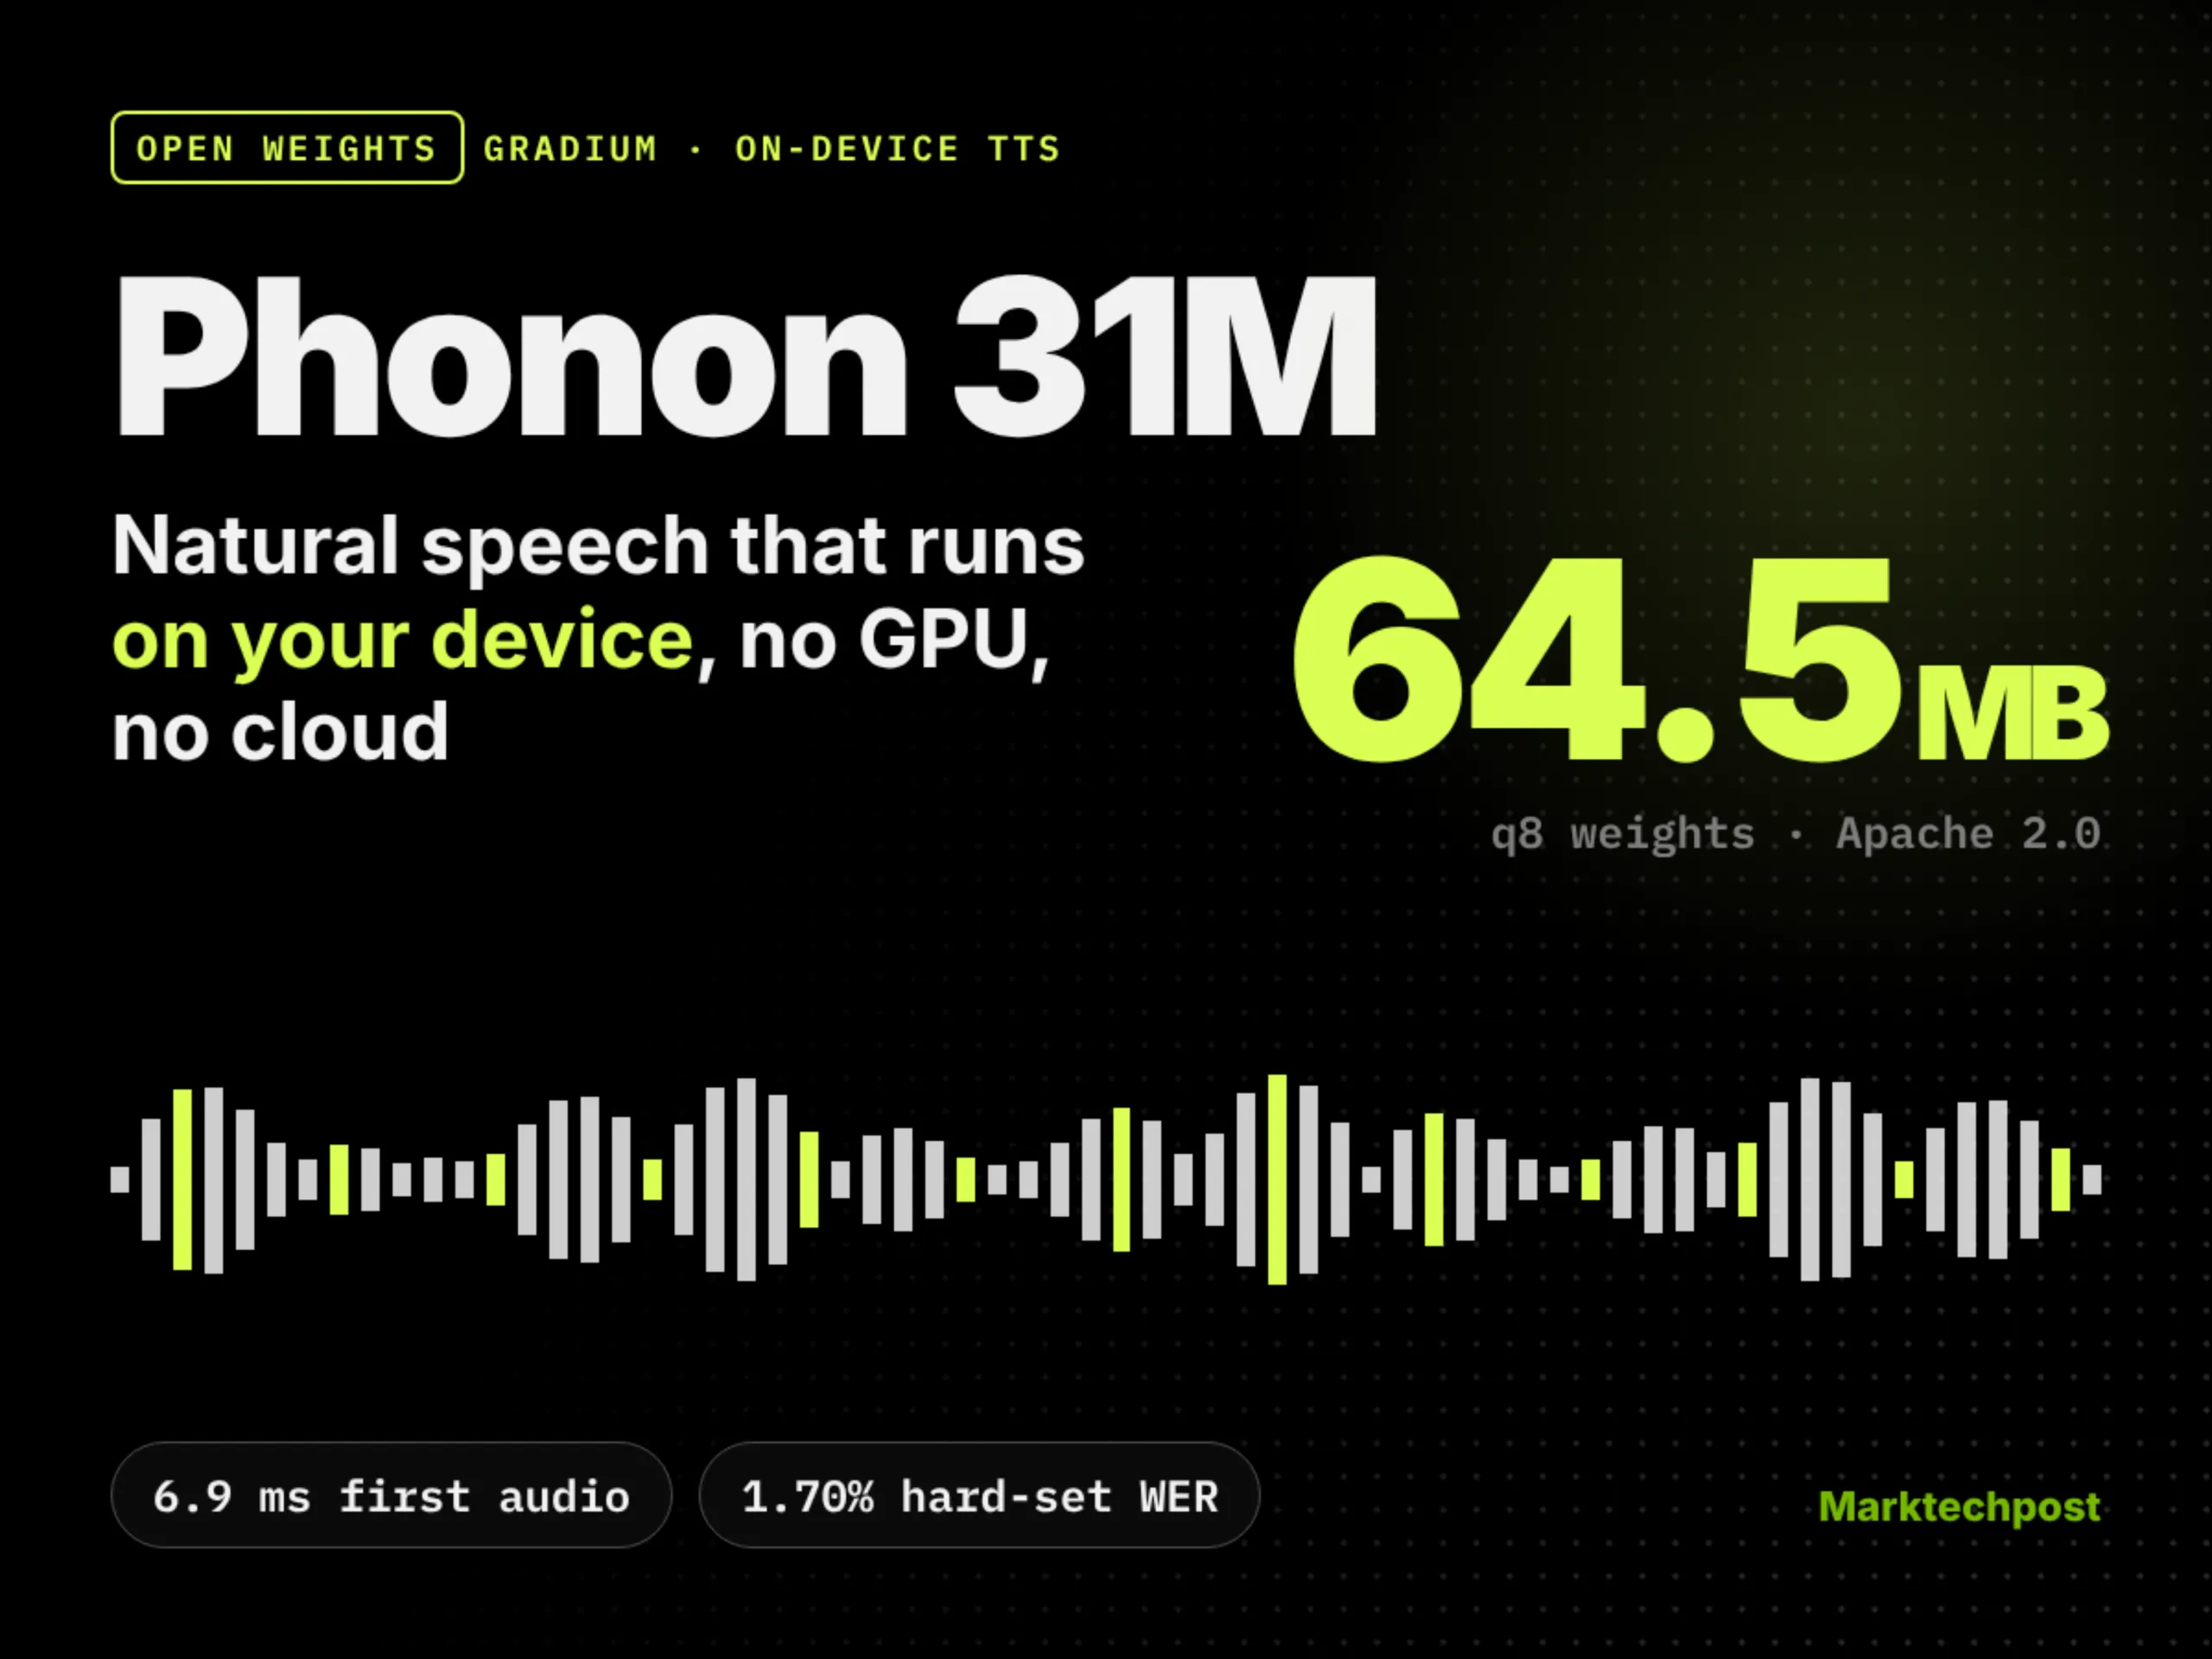
Pentru ani de zile, sinteza vocii de înaltă calitate a fost dominată de modele masive care rulează pe servere puternice — gândiți-vă la cele de la ElevenLabs, OpenAI (TTS-1/HD) sau Google Cloud Text-to-Speech. Acestea oferă o naturalitate impresionantă, dar aduc cu ele costuri recurente, latență de rețea, dependență de conectivitate și, nu în ultimul rând, probleme de confidențialitate a datelor. Phonon vine să rupă acest paradigă.
O arhitectură gândită pentru edge
Cu doar 31 de milioane de parametri, Phonon este mic suficient pentru a încapă pe un smartphone, o Raspberry Pi, un microcontroler puternic sau chiar într-o extensie de browser, dar suficient de capabil pentru a produce o vorbire coerentă, naturală și expresivă. Echipa Gradium a optimizat arhitectura — o variantă simplificată a arhitecturilor de tip transformer/decoder-only cu atenție multi-head și convoluții de tip depthwise-separable — pentru inferență rapidă pe CPU și GPU-uri integrate, folosind cuantizare INT8 și INT4 fără degradare semnificativă a calității.
În benchmark-uri interne, modelul atinge un RTF (Real-Time Factor) sub 0,15 pe un iPhone 14 (Neural Engine) și sub 0,3 pe un Raspberry Pi 4 Cortex-A72, ceea ce înseamnă generare de audio în timp real cu consum redus de baterie și fără încălzire. Latenta de prima fragment (time-to-first-audio) este de ordinul sutelor de milisecunde, esențială pentru aplicații conversaționale (asistenți vocali, navigare, accesibilitate).
De ce Apache 2.0 schimbă jocul
Majoritatea modelelor TTS "open source" lansate recent (VITS, Bark, StyleTTS2, XTTS-v2) vin sub licențe restrictive: CC-BY-NC (non-comercial), Coqui Public Model License (care interzice utilizarea în servicii concurente) sau licențe proprietare mascarate ca open source. Apache 2.0 elimină aceste bariere:
Aceasta este o bucată de știre uriașă pentru startup-uri mici, pentru companii enterprise care nu pot trimite date text sensibile (medicale, juridice, financiare) la API-uri externe, și pentru comunitatea de cercetare care vrea să experimenteze liber.
Calitate vs. mărime: compromisele reale
Să fim honești: un model de 31M parametri nu va suna identic cu un model de 1,6B parametri antrenat pe 100.000 de ore de audio. Phonon are o prosodie puțin mai plană pe fraze lungi, uneori ratează accentul pe cuvinte rare sau nume proprii, și timbrul vocii este fix (single-speaker, voce feminină neutruă, engleză SU). Dar pentru majoritatea cazurilor de uz — citire notificări, navigație turn-by-turn, răspunsuri scurte ale unui asistent, accesibilitate screen-reader — calitatea este de ajuns.
Gradium a furnizat și un pipeline de fine-tuning (scripts PyTorch + ONNX export) care permite adaptarea vocii cu câteva minute de audio (5–10 min) pe un singur GPU consumer (RTX 3080/4080), reducând drastic bariera de intrare pentru voci personalizate.
Ecosistem și integrare
Lansarea include:
Comunitatea a început deja să contribuie: un fork adaugă suport pentru limba română (fine-tune pe 2 ore de date Common Voice), un altul implementează control de prosodie prin embeddings de stil (global style tokens), iar un terț a portat modelul pe ESP32-S3 cu PSRAM extern (generare ~1,2x real-time).
Impactul pe piața TTS
Lansarea Phonon presionează marii jucători să revizuiească strategiile de pricing și să ofere opții on-premise/edge reale. De asemenea, validează tendința de fond: small language models (SLM) specializați pe task-uri specifice (TTS, ASR, NLU) vor domina edge-ul, în timp ce modelele masive rămân în cloud pentru task-uri generative complexe.
Pentru dezvoltatori români, oportunitatea este imediată: puteți construi aplicații de accesibilitate pentru persoanele cu deficiențe vizuale, asistenți vocali în limba română care rulează offline pe telefoanele beneficiarelor, sau sisteme de navigare pentru zone cu acoperire de rețea slabă — totul fără costuri de API și cu control total pe date.
De ce este important:
Phonon nu este doar un alt model TTS open source — este primul model production-ready, on-device, single-file, Apache 2.0 care atinge o calitate comercială acceptabilă sub 50M parametri. El democratizează sinteza vocii la fel cum Stable Diffusion a democratizat generarea imaginilor: punând puterea în mâinile dezvoltatorilor, nu a platformelor. Dacă lucrezi la orice produs care ar beneficia de voce (educație, sănătate, automotive, IoT, gaming), acum ai o alternativă credibilă la abonamentele lunare și la lock-in-ul vendorilor. Descarcă-l, rulează-l local, sparge-l, îmbunătățește-l — și construiește ceva ce nu a fost posibil până azi.