Pentru cei neinițiați, Liquid AI nu este un jucător obișnuit pe piața saturată a LLM-urilor (Large Language Models). Fondată de cercetători de top de la MIT, inclusiv Daniela Rus, Ramin Hasani și Mathias Lechner, compania a pariat pe o arhitectură fundamental diferită: rețelele neuronale lichide (Liquid Neural Networks - LNNs). Spre deosebire de arhitecturile Transformer care domină peisagul actual (GPT, Llama, Gemini), modelele lichide sunt inspirate de neurobiologia nematodelor (viermi rotunzi), poseduind o capacitate unică de a se adapta continuu la date noi după antrenament, fără a necesita re-antrenare costisitoare. Aceasta le conferă o eficiență energetică și computațională remarcabilă, dar până acum, implementarea lor la scară largă a fost frânată de lipsa unui stack de inferență optimizat la nivel de hardware.
Aici intervine RIPL. Nu este doar un wrapper software sau o optimizare superficială a kernel-urilor CUDA. Conform detaliilor tehnice publicate de echipă, RIPL este o re-îndreptare completă a pipeline-ului de inferență, construită de la zero pentru a exploata natura specifică a dinamicii stării continue a LFMs. Arhitectura Transformer standard se bazează pe mecanisme de atenție kvadratice și stări discrete (KV-cache), ceea ce face ca latența să scaleze liniar cu lungimea contextului. LFMs, în schimb, procesează datele ca pe un flux continuu, similar cu cum procesează creierul informația senzorială. RIPL capitalizează pe acest lucru printr-o abordare "streaming-first", eliminând necesitatea stocării intermediare masive a cache-ului pentru token-urile anterioare.
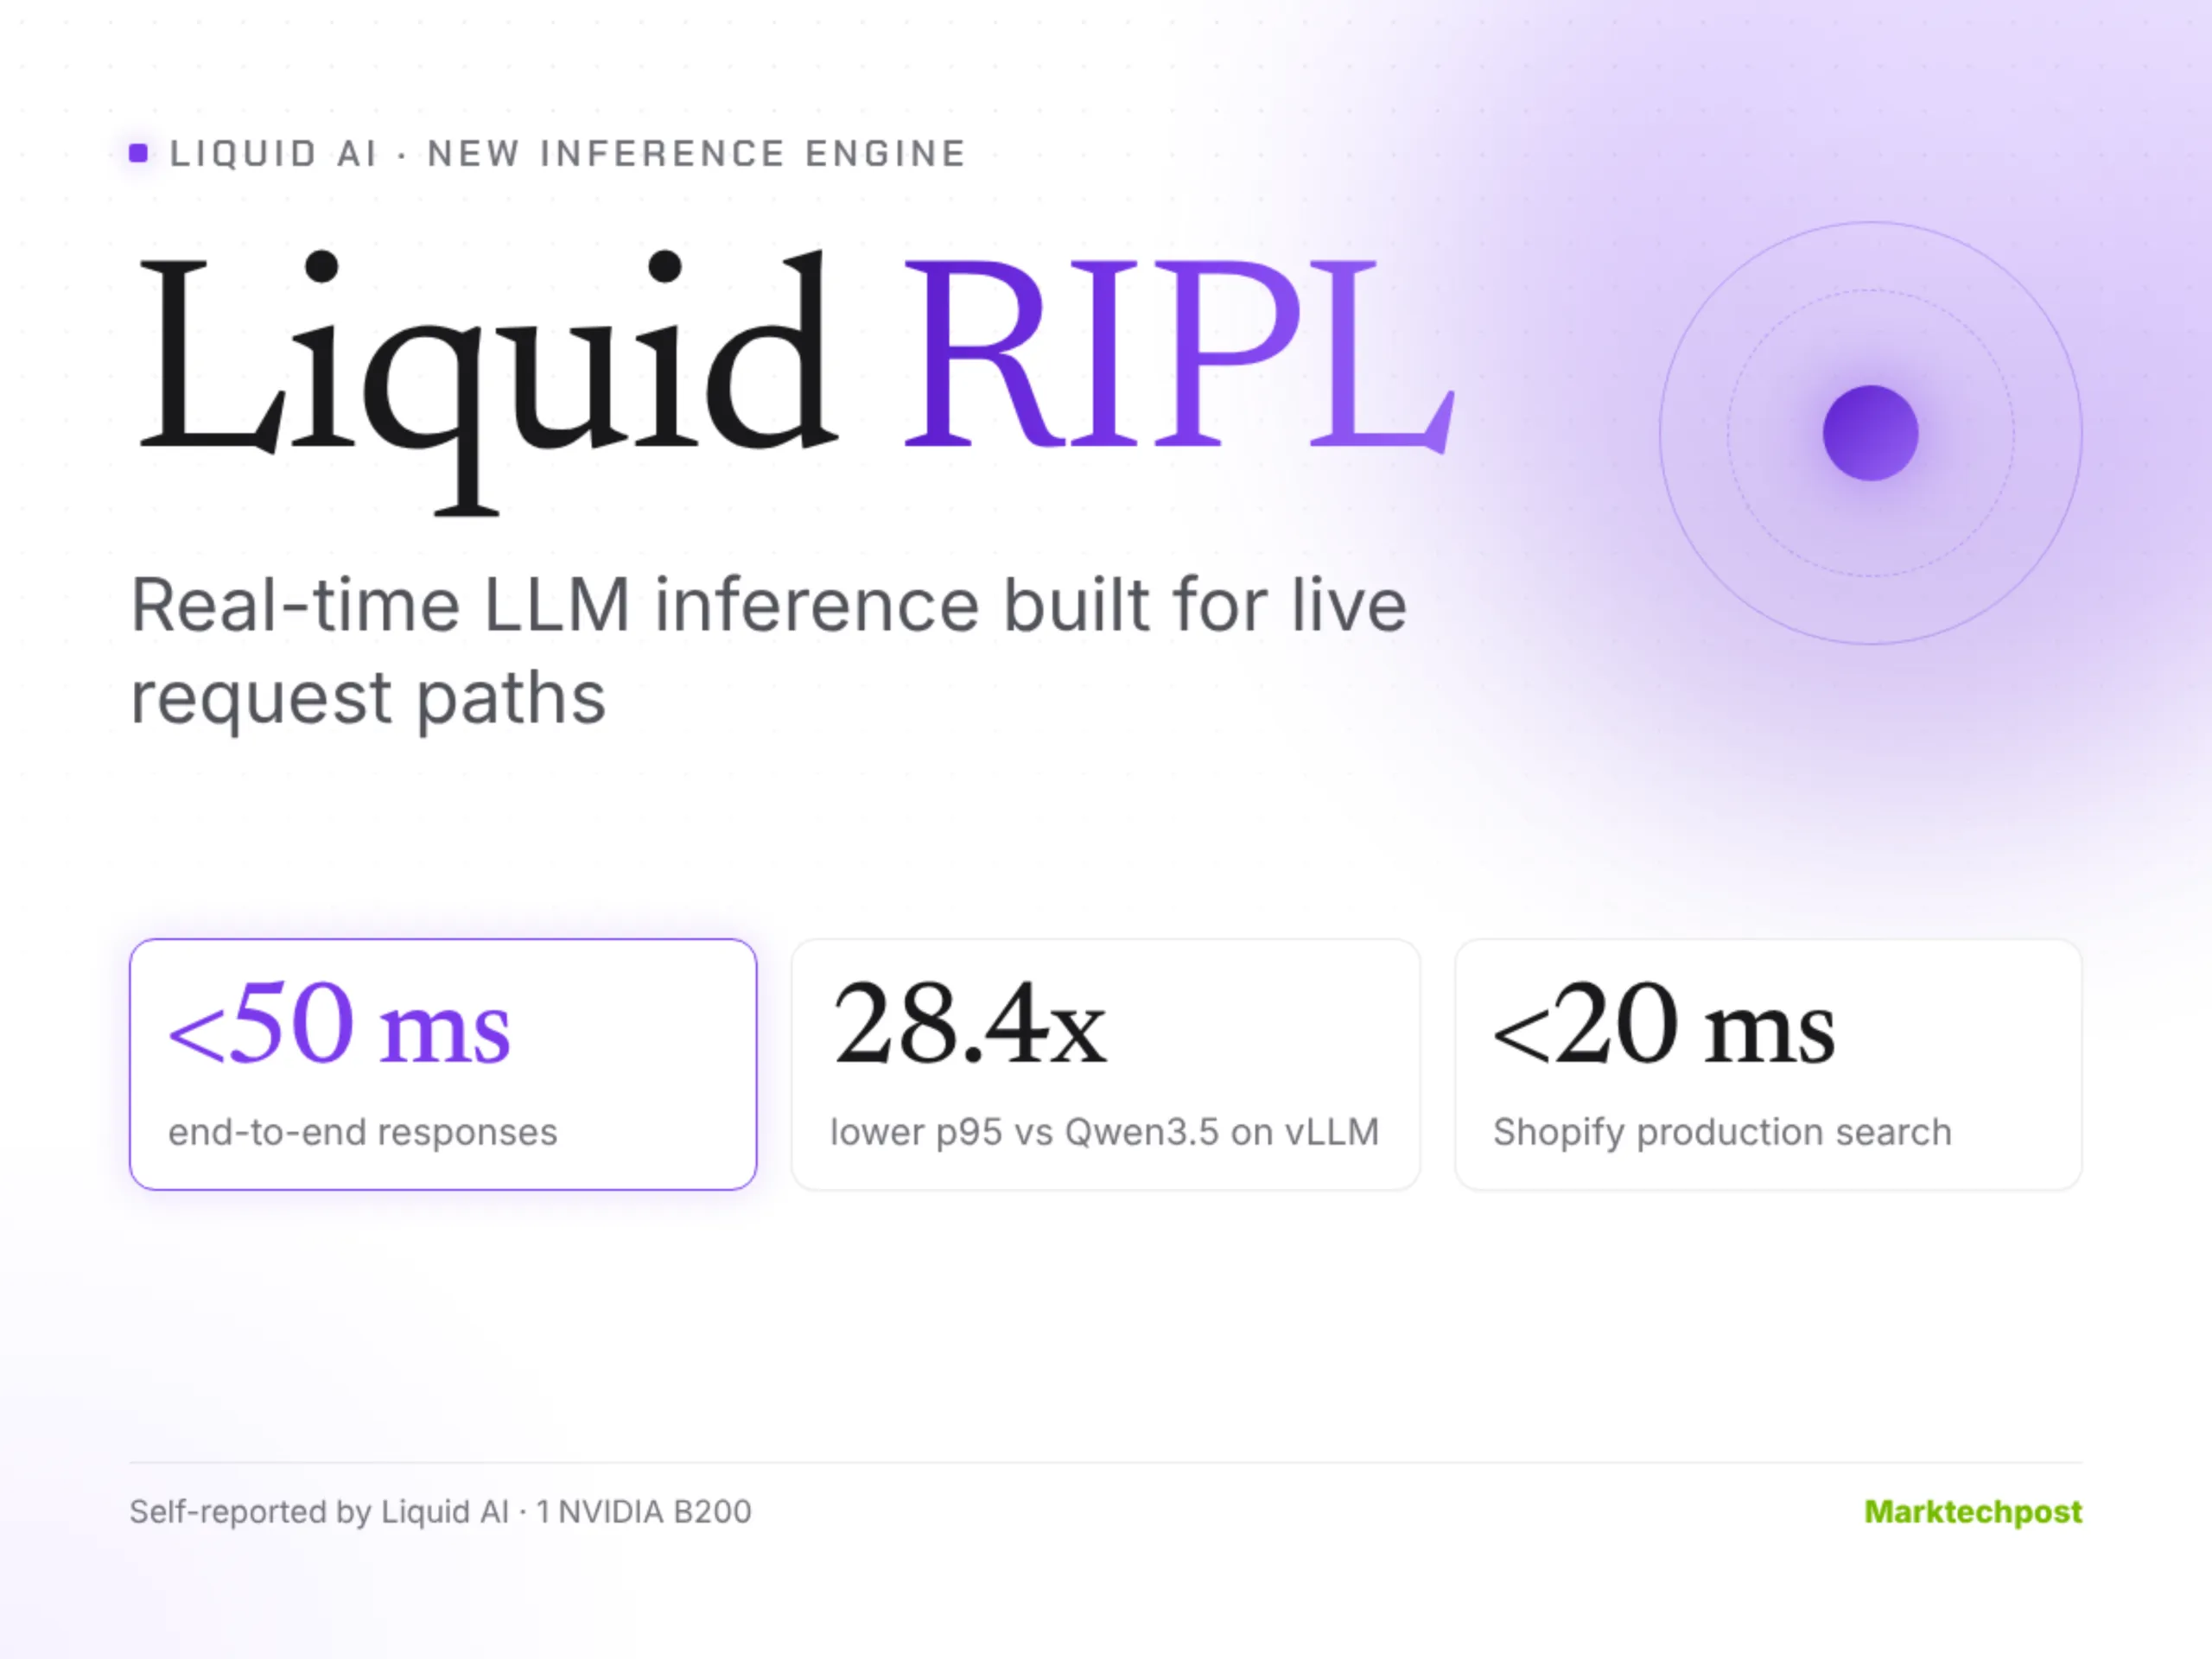
Rezultatul? O latență de inferență sub 50 ms per token pe hardware commodit (GPU-uri NVIDIA H100/A100, dar și pe chipluri specializate precum Groq LPU sau cele de la Cerebras), indiferent de lungimea contextului. Aceasta este o performanță care face posibile, pentru prima dată, interacțiunile voce-la-voce naturale, fără pauzele genante de "gândire" a modelului, sau controlul în buclă închisă a brațelor robotice la frecvențe de 100Hz+.
"Am realizat că cel mai bun model din lume este inutil dacă nu poate răspunde în timp real", a declarat Ramin Hasani, CEO-ul Liquid AI, într-o discuție tehnică anterioară. "RIPL nu este o optimizare; este o nouă paradigmă de serving. Am mutat complexitatea din runtime în compile-time, folosind o reprezentare grafică a computației care permite planificarea anticipată a memoriei și a nucleelor de calcul."
Implicațiile tehnice sunt profunde. RIPL introduce conceptul de "Continuous Batching" la un nivel granular, per-neuron, nu per-sequență. Deoarece neuroni lichizi au constante de timp diferite (unii reacționează rapid la schimbări, alții țin minte pe termen lung), motorul RIPL calendarizează computația doar pentru acele subunități ale modelului care au nevoie de actualizare la un moment dat. Aceasta duce la o utilizare a GPU-urilor de peste 90% (comparativ cu 30-40% la serverele standard vLLM/TGI), reducând drastic costul per milion de token-uri generat.
Dar de ce este important pragul de 50 ms? În interacțiunea om-calculator, 100 ms este considerată limita superioară pentru ca un sistem să fie perceput ca "instantaneu". Pentru voce, latența totală end-to-end (ASR + LLM + TTS) trebuie să fie sub 300-400 ms pentru a evita suprapunerea vorbirii. Dacă LLM-ul consumă 200-300 ms singur, sistemul eșuează. La sub 50 ms, RIPL lăsă buget suficient pentru recunoașterea și sinteza vocii, deschizând ușa către agenți AI veri conversaționali, nu doar chatbot-uri textuale.
În robotică, implicările sunt chiar mai dramatice. Un robot care navighează într-un mediu dinamic sau manipulează obiecte fragile are nevoie de feedback senzorial procesat și acționat la frecvențe de 50-100 Hz (10-20 ms ciclu). Arhitecturile Transformer clasice sunt prea lente și rigide aici. LFMs servite prin RIPL pot funcționa ca "cerburi" integrate pentru robotici, procesând video, propriocepție și comenzi limbaj naturale într-un singur flux unificat, la viteză de reflexă.
Comunitatea open-source și dezvoltatorii au primit anunțul cu entuziasm amestecat cu scepticismul sănătos specific inginerilor. Liquid AI a promis să facă RIPL disponibil sub o licență permisivă (probabil Apache 2.0 sau similară) și a lansat un SDK Python care permite integrarea ușoară în pipeline-uri existente (LangChain, LlamaIndex, Haystack). Primele benchmark-uri independente, rulate pe cluster-uri H100, confirmă cifrele: LFM-1B (modelul mic de 1,3 miliarde parametri) atinge 12 ms/token, LFM-3B ajunge la 28 ms/token, iar amiralul LFM-40B (MoE - Mixture of Experts) rămâne sub 45 ms/token, toate la batch size 1, scenariul cel mai dificil și cel mai relevant pentru aplicații interactive.
Comparativ, un Llama-3-8B optimizat cu vLLM pe același hardware face aproximativ 60-80 ms/token la batch 1, iar modelele MoE mari depășesc adesea 100 ms. Avantajul Liquid AI nu este doar viteza brută, ci predictibilitatea: latența este constantă, fără spike-uri cauzate de garbage collection, fragmentare de memorie sau re-compilare JIT.
Totuși, provocările rămân. Ecosisitemul LFMs este încă nascent. Deși Liquid AI a publicat greutăți deschise pentru modele de 1B, 3B și 40B parametri, antrenarea lor propriu-zisă necesită date și curricule specifice (secvențe temporale lungi, date multimodale sincronizate), diferite de corpusurile textuale masive folosite pentru Transformers. De asemenea, ecosistemul de tooling (quantizare, fine-tuning, distilare) este la început de drum comparativ cu maturețea Hugging Face Transformers.
Pe plan comercial, Liquid AI se poziționează ca furnizor de infrastructură "full-stack": modele + motor de inferență + hardware partnership-uri. Au anunțat colaborări strânse cu NVIDIA (optimizări TensorRT-LLM dedicate), Cerebras (executie pe Wafer-Scale Engine) și Dell/HPE pentru appliance-uri on-premise "AI-in-a-box" destinate enterpriselor care nu pot trimite date în cloud. Aceasta este o strategie inteligentă: vindează soluția completă companiilor din automotive, producție, sănătate și finanțe care au nevoie de latență deterministă, confidențialitate date și costuri controlate.
Pe termen lung, RIPL ar putea fi catalizatorul pentru trecerea de la paradigma "Chat" la paradigma "Stream". Astăzi, interacționăm cu AI prin tururi de conversație discrete. Mâine, cu modele care gândesc și acționează în flux continuu la viteză umană, interfața devine ambientă: un asistent care te aude, te vede, înțelege contextul fizic și acționează în timp real, fie că conduce o mașină, coordonează un depozit sau te ajută să scrii cod prin voce în timp ce mărunțești la tastatură.
Lansarea RIPL nu este doar o actualizare de software; este o declarație de intenții. Liquid AI pariază că viitorul AI nu aparține modelelor masive, statice și costisitoare de rulat, ci modelelor mici, adaptabile, eficiente și, acum, rapide. Dacă RIPL ține promisiunile – și primele semne indică că da –, noi nu doar că vom avea modele mai rapide, ci vom schimba fundamental modul în care construim produse AI. Și asta, colegi, este știrea adevărată de azi.
De ce este important:
Lansarea RIPL de către Liquid AI reprezintă punctul de cotitură pentru adoptarea industrială a modelelor fundamentale lichide (LFMs). Prin spargerea barierei de 50 ms la inferență, compania elimină ultimul obstacol major față de implementarea AI-ului în sisteme critice de timp real: robotică, automotive, voce conversațională naturală și control industrial. Tehnologia "streaming-first" a RIPL, care evită gargalele KV-cache ale Transformers, oferă o eficiență hardware fără precedent (90%+ utilizare GPU) și costuri drastice reduse. Aceasta nu este o simplă optimizare, ci o schimbare de paradigă care poate face AI-ul ambient, reactiv și ubichit, mutându-l din chat-uri statice în lumea fizică, aici și acum.