
Pentru cine a urmărit evoluția ecosistemului AI în ultimii ani, lansarea asta nu vine ca un șoc total, dar vine ca o maturizare necesară. You.com, inițiat ca un motor de căutare îmbogățit cu LLM-uri, a pivotat treptat spre a deveni o platformă de productivitate și, acum, un furnizor de infrastructură de inference la scară largă. Şi a făcut asta în momentul în care piața strigă după alternative la monopolele proprietare.
Ce înseamnă de fapt "Inference Router"?
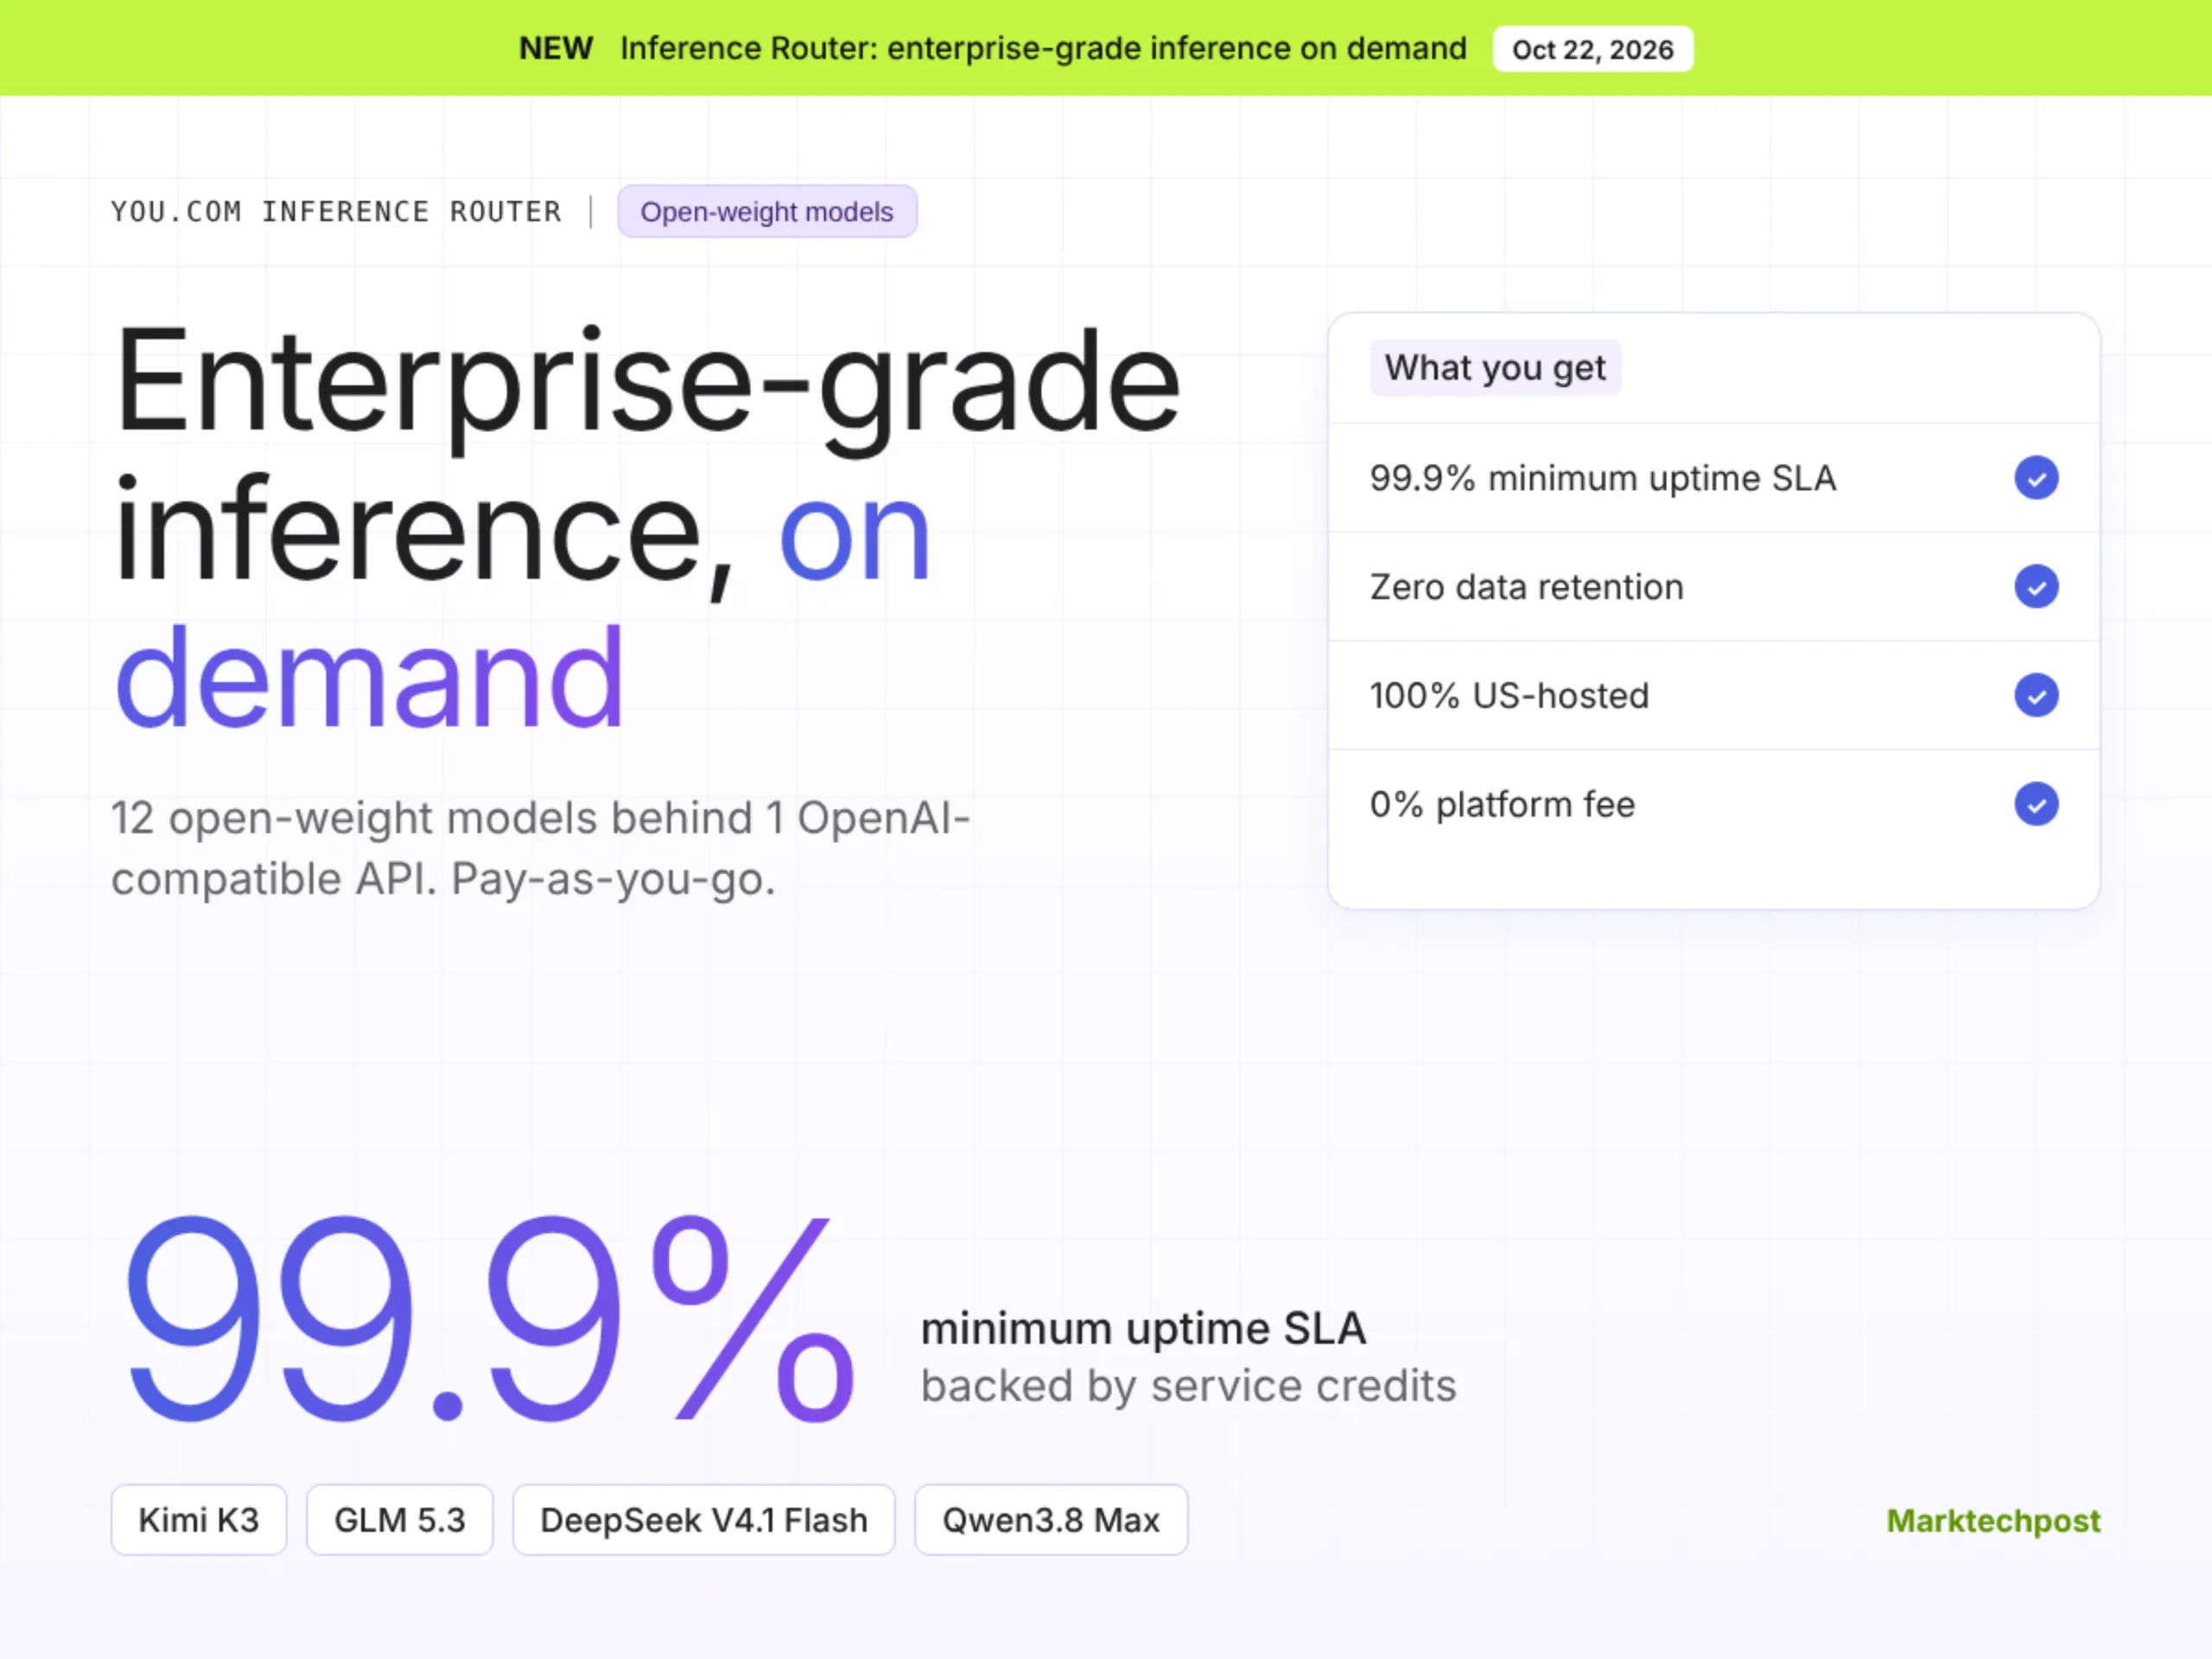
La nivel tehnic, routerul nu este un model per se, ci un strat de orchestrare care direcționează cererile către modelul cel mai potrivit din cele 12 disponibile, optimizând pentru latență, cost, capacități specifice (reasoning, coding, multilingvism, context lung) și — crucial — disponibilitate. Gândiți-vă la el ca la un load balancer inteligent pentru LLM-uri, dar care nu se bazează doar pe sănătatea serverelor, ci și pe semantica task-ului.
Lista modelelor include nume cunoscute din comunitatea open-weight: Llama 3.1 (8B, 70B, 405B), Nemotron 3 Ultra, Qwen 2.5 (7B, 72B), DeepSeek V2.5, Command R+, Phi-3 Medium, Gemma 2 (9B, 27B), Mistral Large 2, și altele. Acoperire largă, de la modele mici, rapide și ieftine pentru task-uri simple, până la giganti de 405B parametri pentru reasoning complex.
De ce SLA-ul de 99,9% e mare lucru
Aici e punctul în care majoritatea furnizorilor open-source (sau "open-weight", să fim precizi) eșuează. Poți descărca Llama 3.1 405B pe Hugging Face azi. Poți să-l rulezi pe propriile H100-uri. Dar cine garantează că clusterul tău nu va da de capăt când lanșezi campania de Black Friday? Sau când un bug în kernel-ul driver-ului NVIDIA îți strică inferența la 2 AM?
You.com pariază pe credibilitatea enterprise. SLA-ul de 99,9% înseamnă maxim 8,76 ore downtime pe an. Pentru comparație, multe API-uri "serverless" populare (chiar și de la mari jucători) nu oferă SLA deloc pentru tier-urile gratuite sau low-end, iar cele enterprise costă zeci de mii de dolari/lună cu contracte negotiate.
Routerul folosește o arhitectură multi-cloud, multi-regiune, cu failover automat și capacity buffering. Nu e magică — e inginerie grea, costisitoare și plictisitoare pe care You.com o face pentru tine.
Economia: open-weight ≠ free lunch
Să clarificăm: modelele sunt "open-weight" (greutățile sunt publice), nu neapărat "open-source" în sensul strict OSI (datele de antrenament, codul de training, licențele variază). Dar din perspectivă de developer, ești liber să le folosești comercial, să le fine-tunezi, să le distilezi, fără să ceri permisiune de la OpenAI, Anthropic sau Google.
Prețul? You.com anunță pricing-ul pe token, competitiv cu furnizorii serverless existenți (Together, Fireworks, Anyscale, Replicate), dar cu avantajul SLA-ului inclus. Pentru volumuri mari, există opțiuni de dedicated instances sau private deployments. Modelul economic e simplu: plătești inferența, nu cercetarea.
Cazurile de utilizare reale: unde strălucesc
1. RAG la scară enterprise: Ai nevoie de context de 128k tokenuri (suportat de majoritatea modelelor de aici) pentru a răspunde la întrebări pe baza documentației interne. Routerul alege automat un model cu context lung și retrieval optimizat.
2. Code generation la CI/CD: Nemotron 3 Ultra sau DeepSeek V2.5 pentru generare de cod, teste, docstrings. Latența sub-secundă e critică aici — developerii nu așteaptă 30 de secunde.
3. Agents multi-step: Phi-3 Medium sau Llama 3.1 8B pentru planificare rapidă, apoi escaladare la 70B/405B pentru execuție complexă. Routerul face handoff-ul transparent.
4. Multilingvism real: Qwen 2.5 și Command R+ au performanțe puternice pe română, chineză, arabă, hindi etc. Nu mai trebuie să traduci prompt-ul în engleză.
Riscurile și întrebările neîntrerupte
Nimic nu e perfect. Dependența de un singur furnizor (You.com) pentru accesul la toate modelele creează un single point of failure la nivel de business. Dacă You.com schimbă pricing-ul, termenii sau — scenariu extrem — dispar, migrarea nu e trivială (deși modelele sunt disponibile altundeva).
De asemenea, "open-weight" nu înseamnă transparență totală. Datele de antrenament rămân opace pentru majoritatea modelelor. Bias-urile, problemele de copyright, siguranța — rămân responsabilitatea ta ca deployer.
Și nu în ultimul rând: performanța reală vs. benchmark-uri. Routerul optimizează pentru metrici aggregate, dar task-ul tău specific poate fi mai bine servit de un model fix, ales manual, cu prompt engineering dedicat. Abstrația are costul propriu.
Poziționarea pe piață: David vs. Goliath... și alți Davizi
You.com nu e singurul. Together AI, Fireworks AI, Anyscale, Replicate, OctoAI (acum parte din NVIDIA), Hyperbolic, Lepton — toți luptă pentru același piept de piață: "inference as a service pentru modele open". Diferențiatorul You.com e double-down pe experiența developerului (SDK-uri clean, playground interactiv, documentație care nu te face să plângi) și pe credibilitatea enterprise (SLA, SOC2, HIPAA compliance în lucru).
În plus, You.com are un avantaj unic: feedback loop-ul direct de la milioane de utilizatori ai produselor sale consumer (search, chat, agents). Știe ce modele funcționează bine în producție, nu pe benchmarke.
Viitorul: routerul devine brain-ul
Pe termen lung, Inference Router-ul nu va fi doar un switch. Va deveni un model router learning system — care învață din traficul tău ce model e cel mai bun pentru tine, și se auto-optimizează. Fine-tuning automat al routing-ului. A/B testing continuu. Cost optimization fără efort.
Și aici e unde open-weight-ul devine periculos pentru modelele closed-source: când costul inferenței scade 10x față de GPT-4o, iar calitatea e 95% comparabilă, calculul economic devine irezistibil pentru CTO-uri și CFO-uri.
Concluzie: o piesă a puzzle-ului, nu picture-ul complet
Lansarea Inference Router de You.com e un pas important către democratizarea reală a AI-ului puternic. Nu doar "codul e pe GitHub", ci "serviciul e pe API, cu SLA, azi, acum".
Dar nu e o baghetă magică. Enterprises-urile vor continua să folosească modele proprietare pentru use-case-uri critice (legal, medical, financiar) unde liability-ul și auditabilitatea sunt non-negociabile. Dezvoltatorii indie vor continua să ruleze modele locale (Ollama, vLLM, TGI) pentru control total și cost zero la margină.
Routerul de You.com umple golul din mijloc: echipele care vor calitate open-weight, scalabilitate enterprise, și nu au timp să devină ingineri de infrastructură ML.
E o ofertă matură, bine timing-uită, și — cel mai important — o forță de presiune pe întreaga piață să ridice standardul. Concurența câștigă. Noi, utilizatorii, câștigăm.
De ce este important:
Această lansare marchează maturizarea ecosistemului open-weight de la "descarcă și rulează singur" la "consumă ca serviciu enterprise-grade". SLA-ul de 99,9% elimină principalul barrieră de adopție pentru companii serioase: riscul operațional. Routerul inteligent reduce complexitatea deciziei "ce model folosesc?" și optimizează costul/performanța automat. Presiunea competitivă va forța toți furnizorii (inclusiv cei closed-source) să iasă cu prețuri mai bune, SLA-uri mai clare și experiențe developer superioare. Pentru România și regiunea CEE, unde talenta tehnică e puternică dar capitalul e scarș, accesul la inference cheap, reliable și open-weight e un enabler strategic pentru inovație locală la scară globală.