Subiect: #vLLM
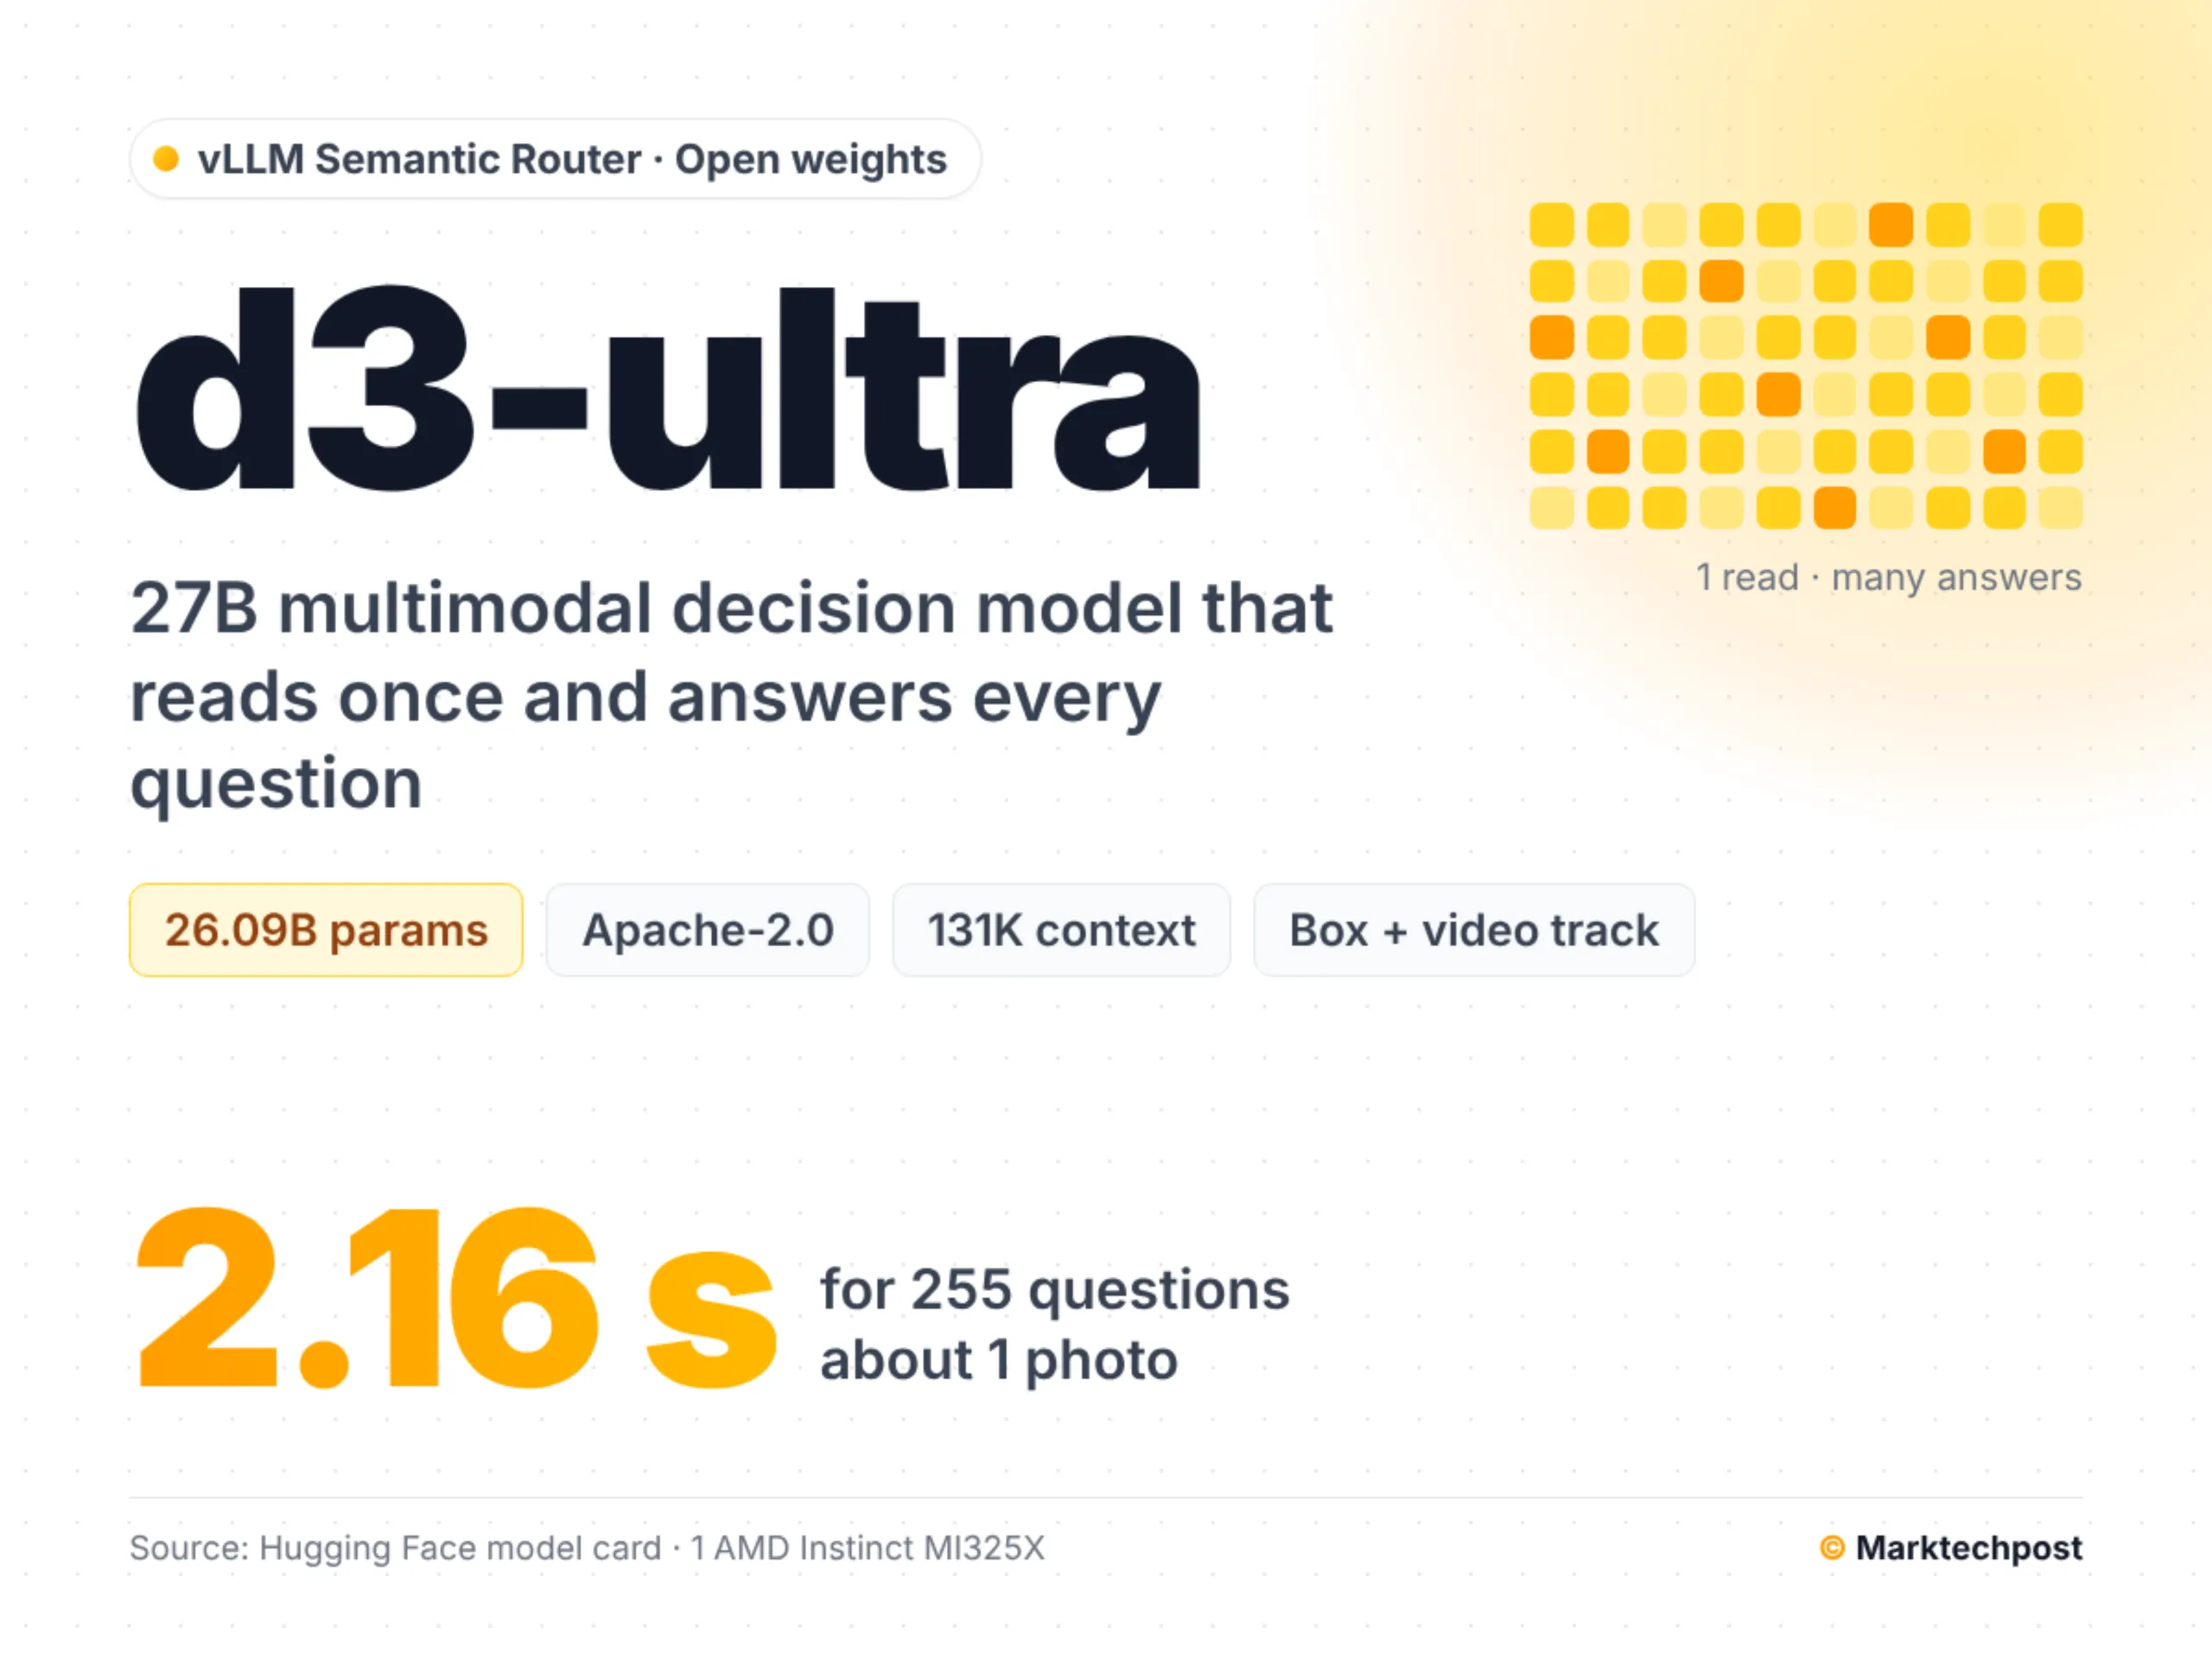
vLLM Semantic Router lansează d3-ultra: Un model multimodal deschis de 27B parametri pentru decizii complexe
vLLM Semantic Router lansează d3-ultra, un model multimodal open-source de 27B parametri specializat în routing semantic și luarea deciziilor pentru agenți AI. Modelul depăș modelele proprietare mai mici pe benchmark-uri de routing, rulează pe un singur GPU consumer și are licență Apache 2.0, democratizând infrastructura cognitive pentru agenți autonomi.
Decision 3.0: Cum noul model de rutare semantică al vLLM rescrie regulile jocului în inteligența artificială
Decision 3.0, cea mai recentă inovație a echipei vLLM Semantic Router, marchează o schimbare de paradigmă în modul în care sistemele AI procesează și direcționează cererile. Prin combinarea analizei semantice în timp real cu optimizarea resurselor, această abordare open-source promite să reducă latența, să crească acuratețea și să scadă costurile pentru dezvoltatorii din întreaga lume.
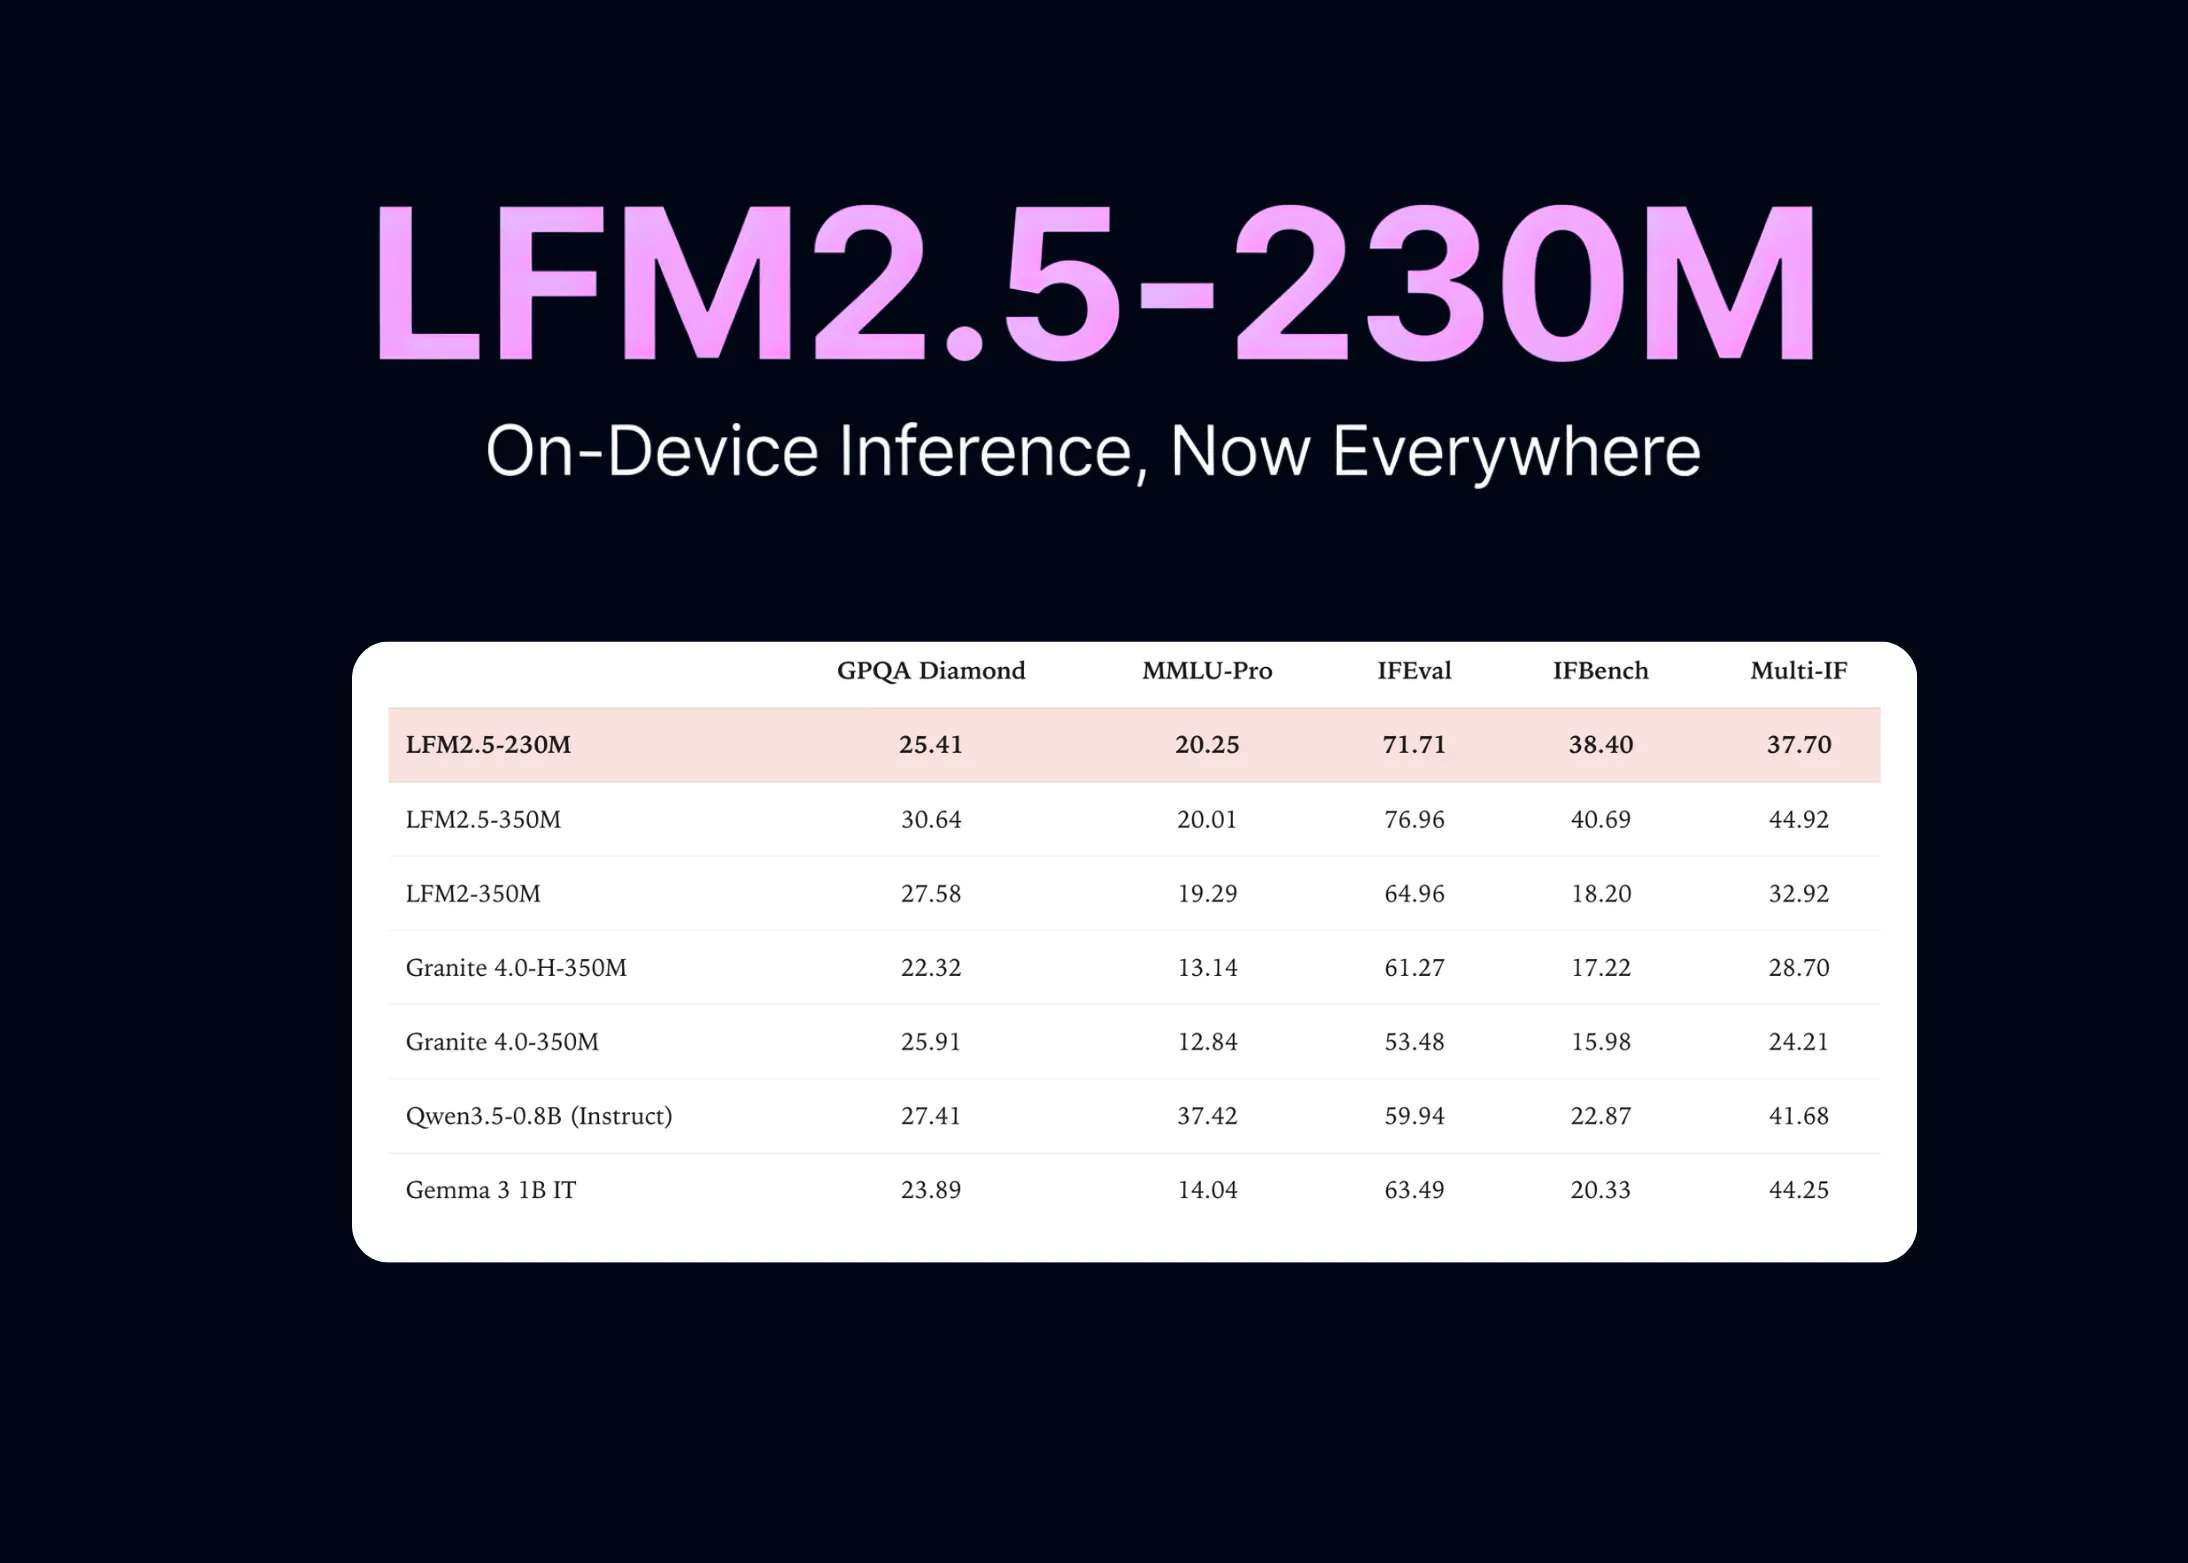
Liquid AI lansează modelul LFM2.5-230M cu suport pentru llama.cpp, MLX, vLLM, SGLang și ONNX – inferență direct pe dispozitiv
Liquid AI lansează modelul LFM2.5-230M cu suport pentru cinci framework-uri de inferență (llama.cpp, MLX, vLLM, SGLang, ONNX), permițând rularea AI-ului direct pe dispozitive locale, fără cloud. Un pas important spre democratizarea inteligenței artificiale.
Accelerarea implementării modelelor lingvistice mari (LLM) de pe Hugging Face prin NVIDIA NIM: O revoluție în infrastructura AI enterprise
NVIDIA anunță integrarea microserviciilor NIM cu platforma Hugging Face, deblocând accesul rapid la peste 100.000 de modele LLM. Soluția oferă un singur container Docker capabil să optimizeze automat implementarea, detectând arhitectura și selectând backend-ul ideal pentru performanță maximă.