Domeniu: AI
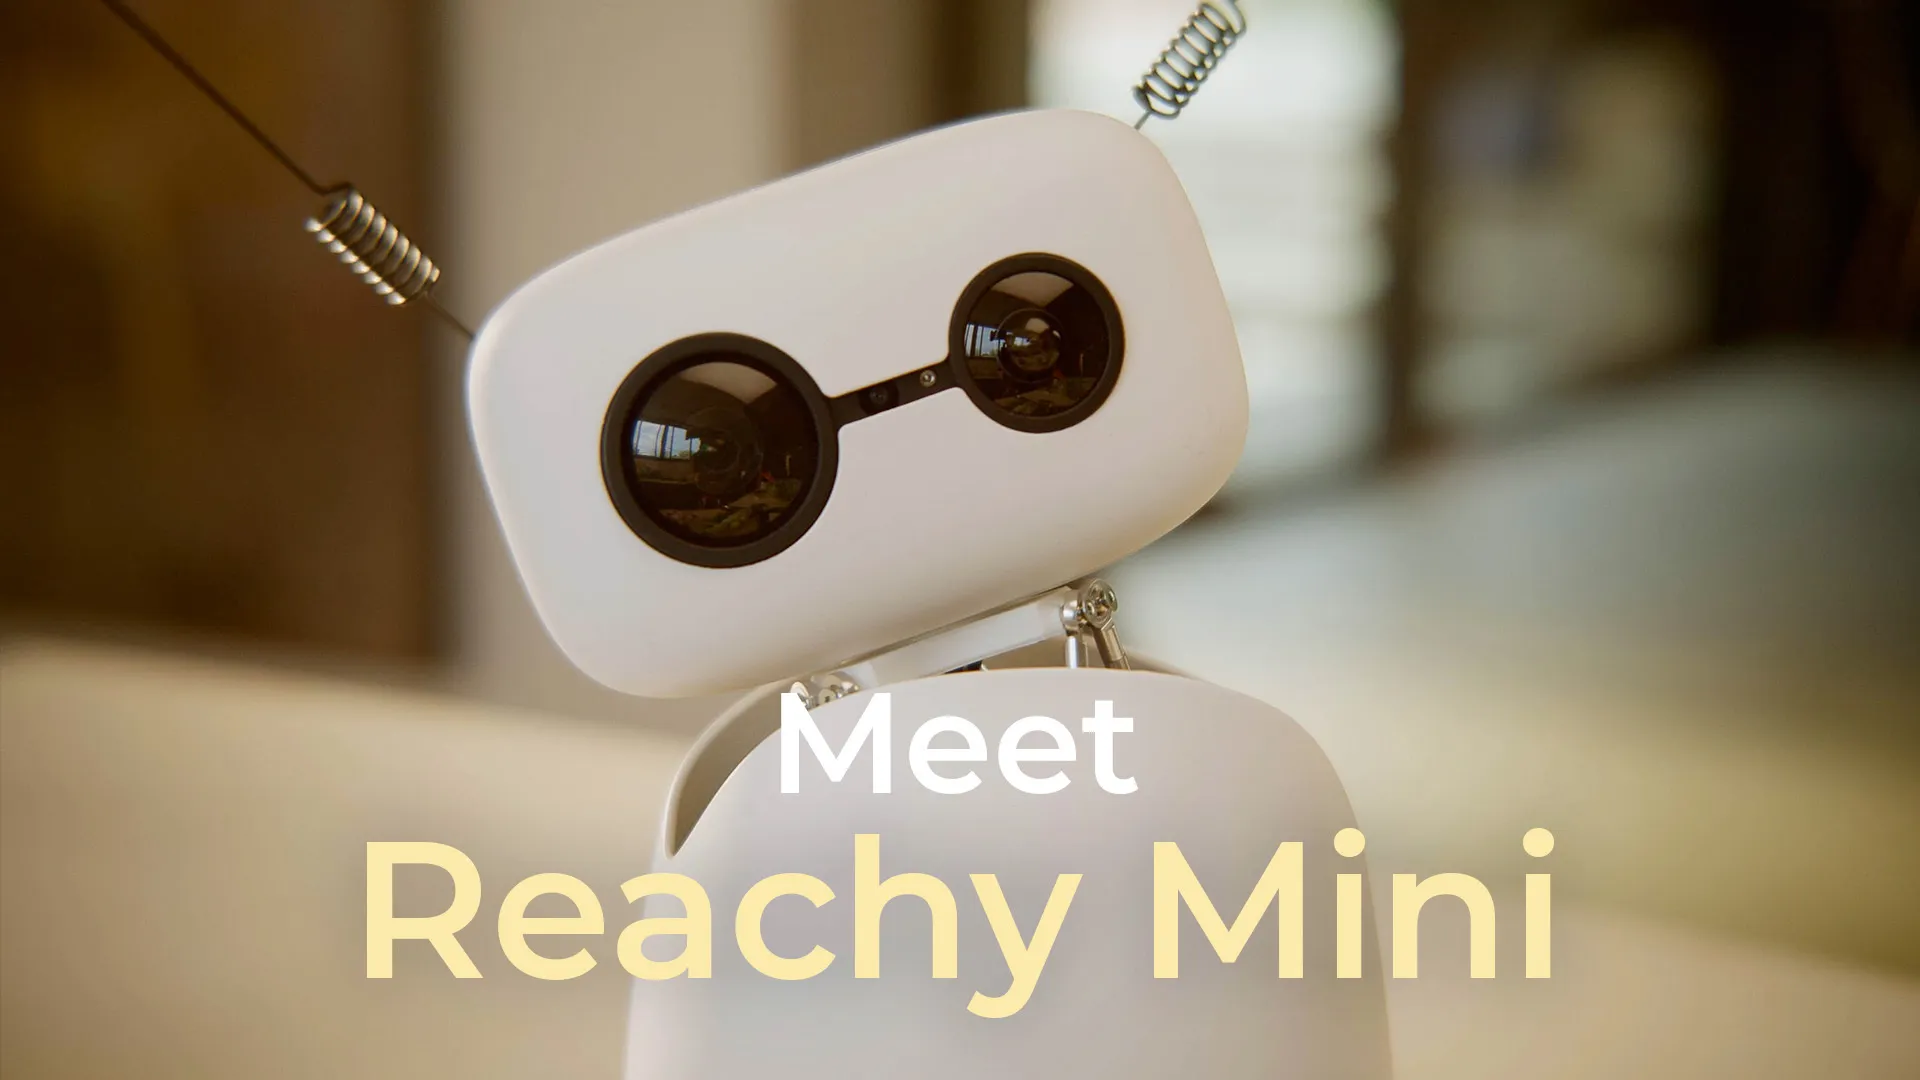
Reachy Mini – Robotul Open-Source care Democratizează Inteligența Artificială și Interacțiunea Om-Mașină
Reachy Mini, un robot open-source rezultat din colaborarea dintre Pollen Robotics și Hugging Face, democratizează accesul la robotică și AI. Cu un preț de pornire de 299$, capabilități multimodale și o comunitate activă, acesta este gata să devină noul standard pentru dezvoltatorii și entuziaștii din întreaga lume.
Construirea serverului MCP Hugging Face: O călătorie tehnică prin standardul de conectare a asistenților AI
Echipa Hugging Face detaliază procesul de construire a unui server MCP (Model Context Protocol) remote, explicând alegerile tehnice dintre transportele STDIO, SSE și Streamable HTTP, și argumentând decizia de a utiliza o configurație Stateless cu Direct Response pentru scalabilitate și eficiență în accesul la Hub.
ScreenEnv: Revoluționarea automatizării desktop prin agenți AI – Mediu sandboxat, control total și integrare flexibilă
ScreenEnv reprezintă o soluție inovatoare pentru automatizarea desktop și dezvoltarea agenților AI, oferind un mediu sandboxat complet care rulează în Docker. Cu control total asupra interfeței grafice și integrare flexibilă prin API direct sau MCP, instrumentul simplifică drastic procesul de creare a agenților capabili să execute sarcini complexe, deschizând calea către automatizarea cross-platform.
Kimina-Prover: Revoluția în Demonstrația Automată de Teoreme prin Căutare RL în Timpul Testării
Kimina-Prover-72B stabilește un nou standard în demonstrația automată de teoreme, atingând o rată de succes de 92.2% pe benchmark-ul miniF2F. Inovația sa principală, cadrul TTRL Search, permite modelului să descopere și combine recursiv leme, transformând procesul dintr-o simplă generare într-o căutare agentică strategică și profundă.
Migrarea platformei Hugging Face Hub de la Git LFS la Xet: O revoluție silențioasă în stocarea modelelor AI
Hugging Face a finalizat o migrare istorică și silențioasă de la Git LFS la Xet, afectând peste 1 milion de utilizatori și petabytes de date. Noua infrastructură asigură compatibilitatea retroactivă, transferuri ultra-rapide și o scalabilitate fără precedent pentru modelele AI.
Ettin Suite: O nouă eră în arhitectura AI – Encodere și Decodere de ultimă generație
Ettin Suite introduce primele modele pereche (encodere și decodere) antrenate identic, oferind o comparație riguroasă și performanțe de ultimă oră. Proiectul depășește standardele actuale precum ModernBERT și Llama 3.2, demonstrând superioritatea specifică a fiecărei arhitecturi în funcție de task-ul dorit.
Cinci îmbunătățiri majore aduse serverelor Gradio MCP: Suport fișiere locale, notificări în timp real și integrare API automatizată
Versiunea Gradio 5.38.0 aduce cinci inovații majore pentru serverele MCP: suport automat pentru încărcarea fișierelor locale, notificări de progres în timp real, transformarea specificațiilor OpenAPI în servere MCP printr-o singură linie de cod, îmbunătățiri ale autentificării prin header-e și posibilitatea personalizării descrierilor instrumentelor.
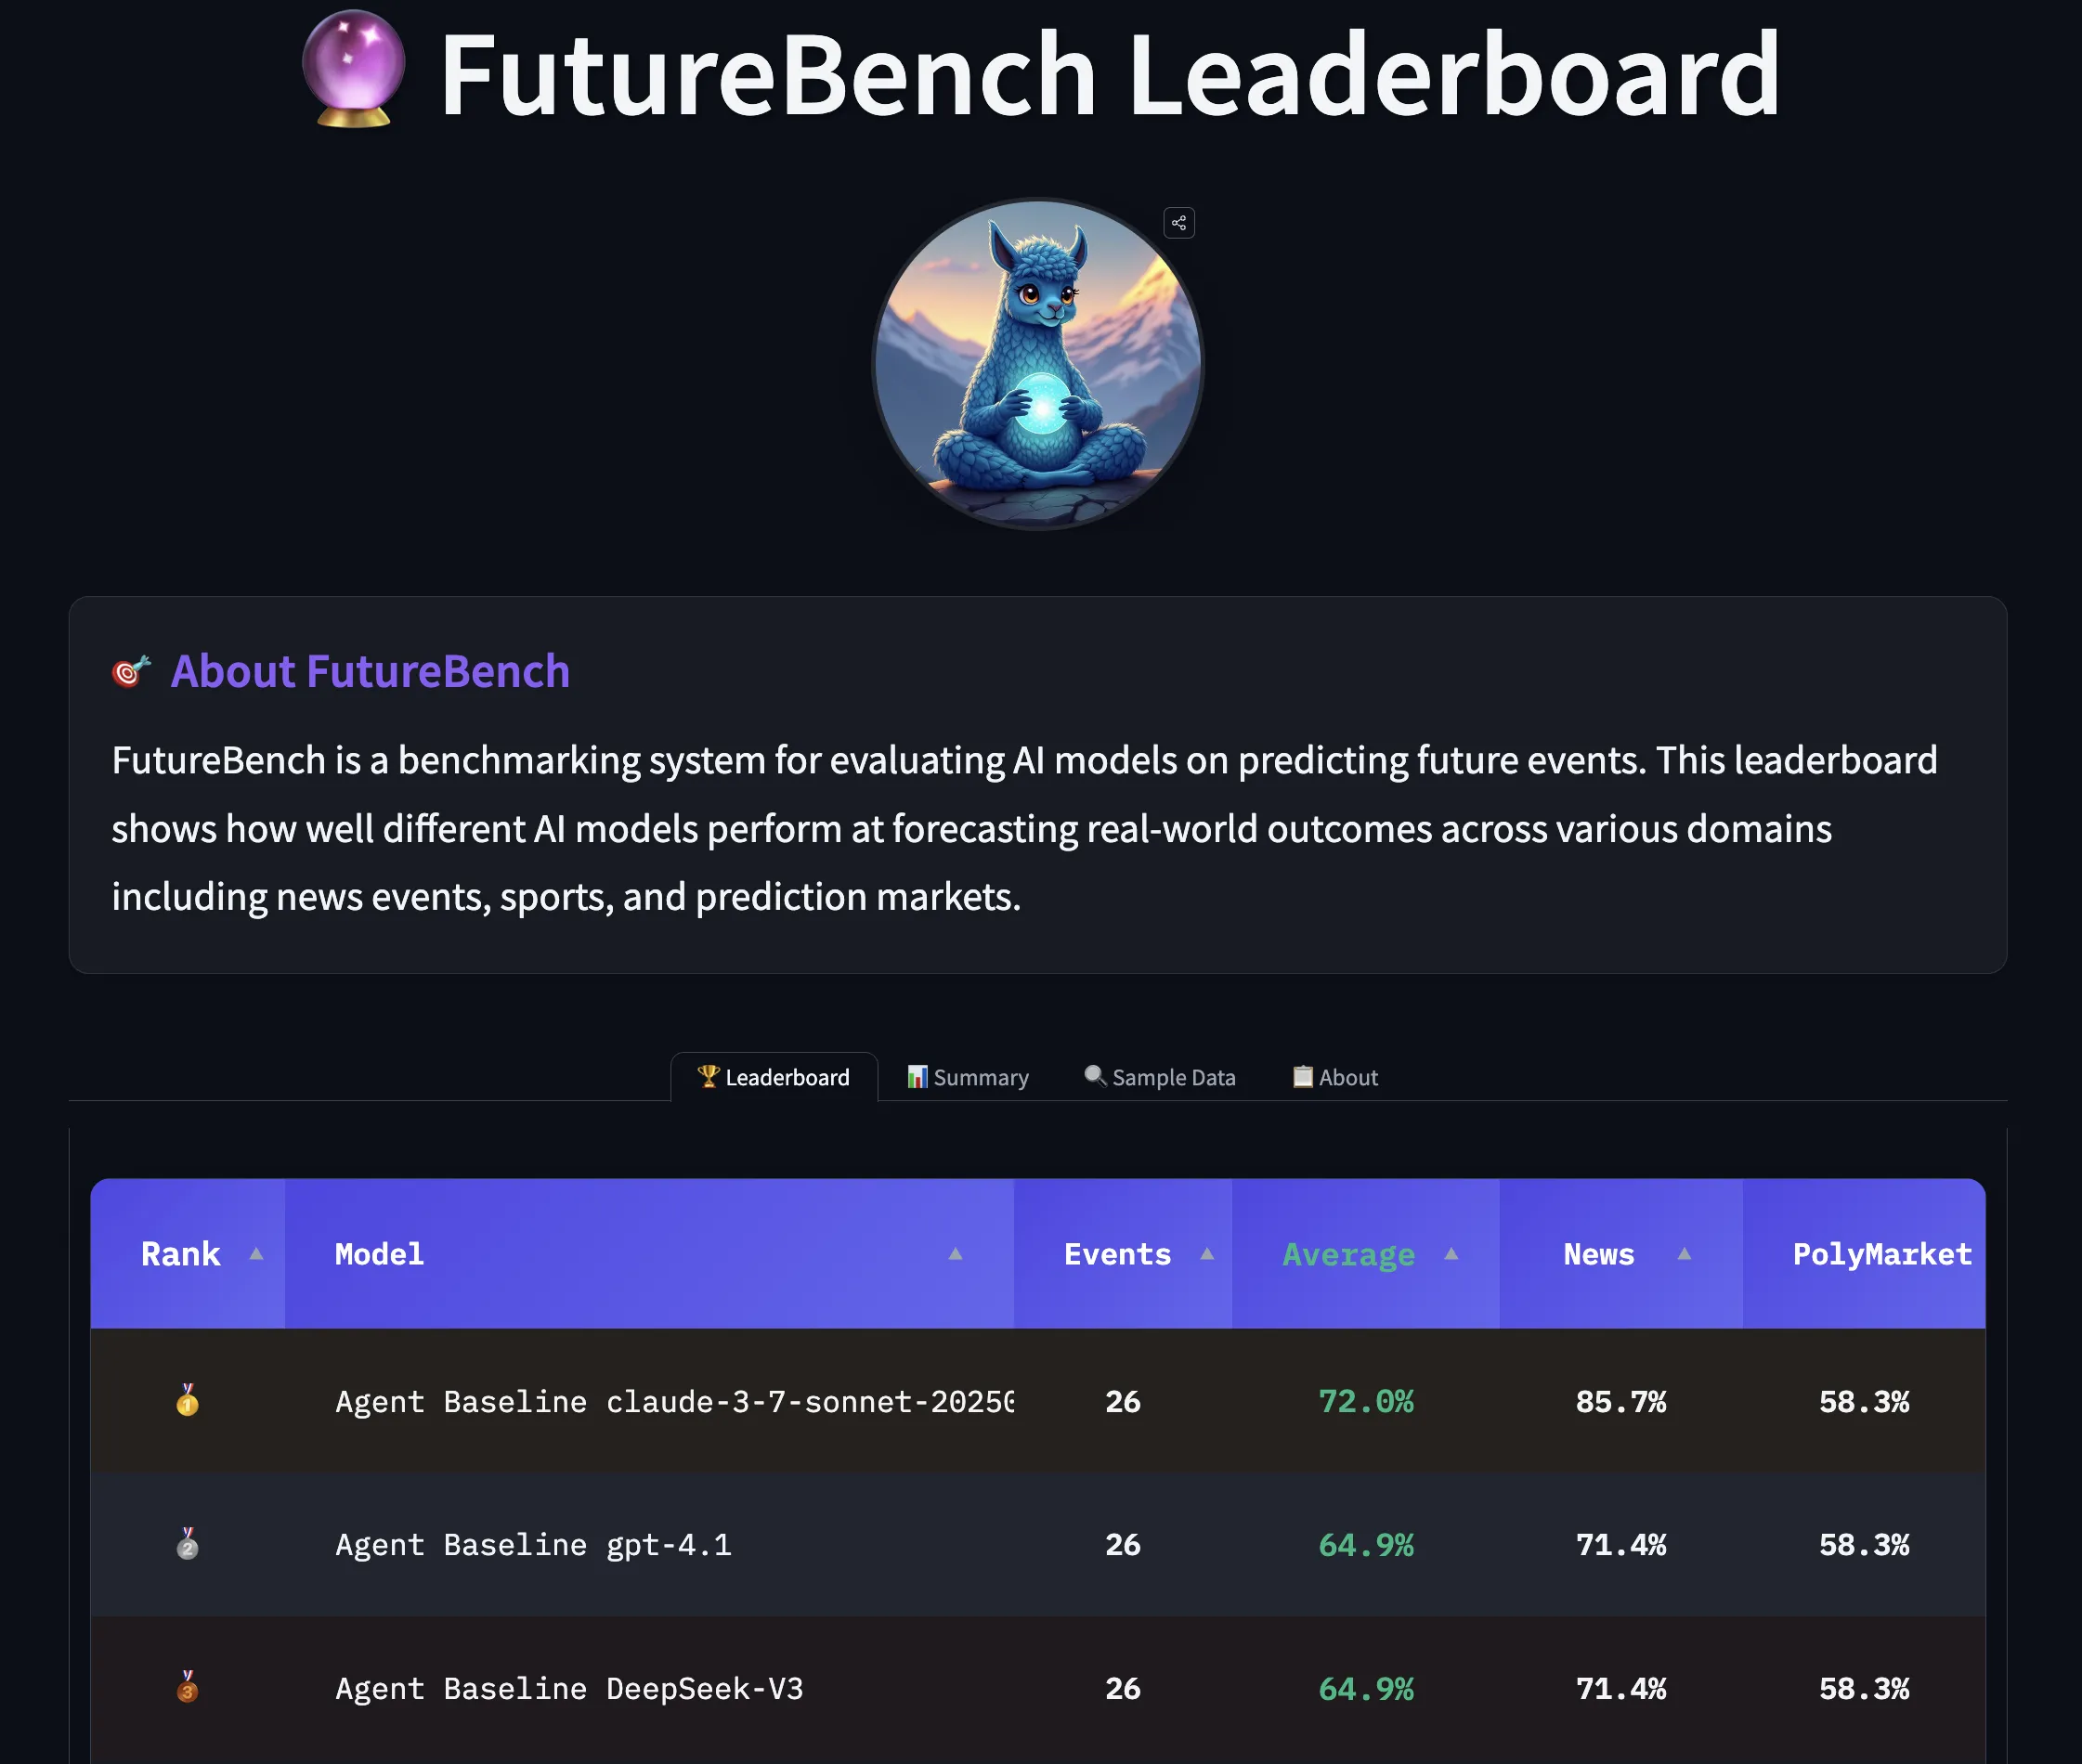
Înapoi în Viitor: Evaluarea Agenților AI în Predicția Evenimentelor Viitoare
Un nou benchmark revoluționar, FutureBench, propune evaluarea agenților AI pe baza capacității lor de a prezice evenimente viitoare, trecând de la testarea memorării faptelor istorice la măsurarea raționamentului complex și a înțelegerii cauzale.
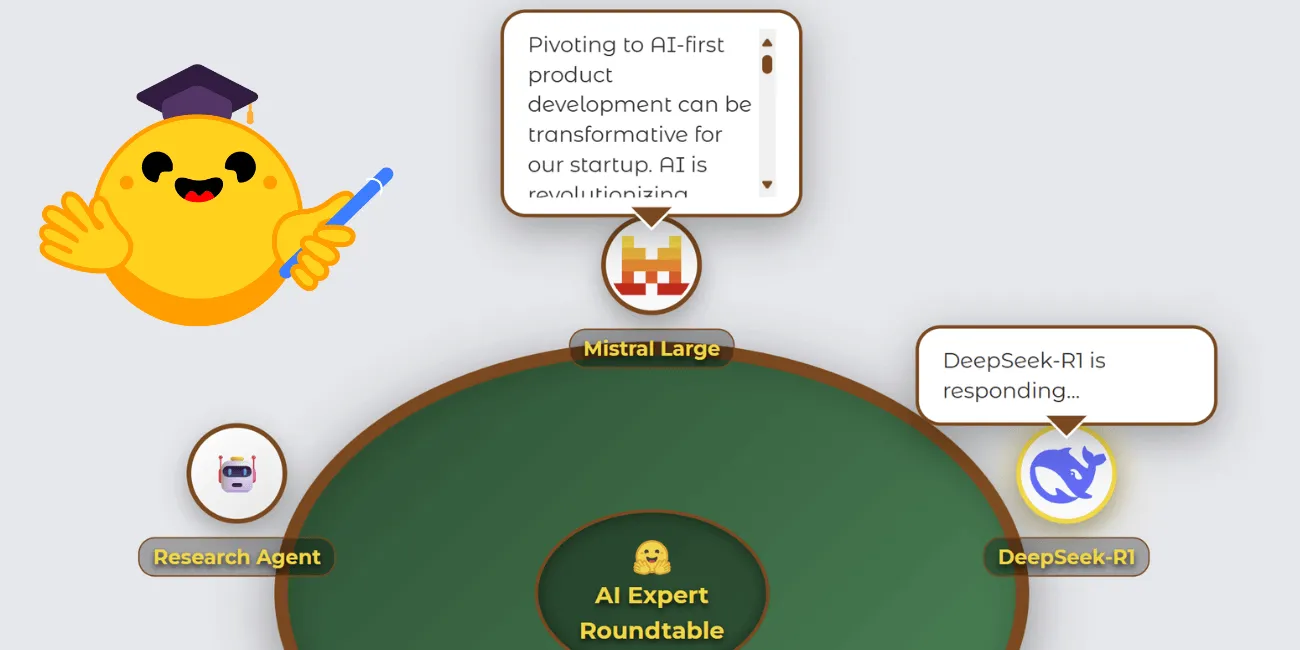
Consilium: Când modelele de limbaj colaborează – O revoluție în inteligența artificială distribuită
Consilium reprezintă o platformă revoluționară care permite multiplelor modele de limbaj mari (LLM) să colaboreze și să discute pentru a atinge consensuri, depășind limitările analizei individuale și validată de cercetări recente care arată că sistemele multi-AI pot atinge 85.5% acuratețe în diagnostic medical comparativ cu doar 20% pentru medicii umani.
Arc Virtual Cell Challenge: O inițiere în modelarea celulară virtuală
Arc Virtual Cell Challenge propune o revoluție în biologia computațională: antrenarea unui model AI capabil să simuleze efectele perturbărilor genetice fără a necesita experimente fizice costisitoare. Articolul explorează arhitectura modelului STATE, utilizarea modelelor de limbaj proteic și metricile complexe de evaluare.
Accelerarea implementării modelelor lingvistice mari (LLM) de pe Hugging Face prin NVIDIA NIM: O revoluție în infrastructura AI enterprise
NVIDIA anunță integrarea microserviciilor NIM cu platforma Hugging Face, deblocând accesul rapid la peste 100.000 de modele LLM. Soluția oferă un singur container Docker capabil să optimizeze automat implementarea, detectând arhitectura și selectând backend-ul ideal pentru performanță maximă.
Inferență rapidă cu LoRA pentru Flux utilizând Diffusers și PEFT: Ghid complet de optimizare
Un ghid tehnic detaliat despre optimizarea inferenței modelului Flux.1-Dev folosind LoRA, Diffusers și PEFT, acoperind strategii de la hotswapping fără recompilare până la rularea eficientă pe GPU-uri de consum precum RTX 4090.