Hai să lămurim mai întâi ce înseamnă „augmentarea datelor”, pentru că termenul sună mult mai tehnic decât este în realitate. Imaginează-ți că vrei să înveți un copil să recunoască un câine. Nu îi arăți o singură fotografie cu un labrador pe fundal alb, ci îi arăți sute de câini: negri, albi, pătați, fotografiați din lateral, din spate, în lumină slabă, în zăpadă, cu coada tăiată de cadru. Cu cât variația e mai mare, cu atât copilul va recunoaște un câine și în situații pe care nu le-a văzut niciodată. Exact același principiu stă la baza antrenării rețelelor neuronale. Augmentarea datelor este procesul prin care luăm un set de date existent și îl „deformăm” controlat — rotim imagini, adăugăm zgomot, schimbăm ordinea cuvintelor, modificăm tonul unei înregistrări — pentru ca modelul să învețe esența, nu detaliile accidentale.
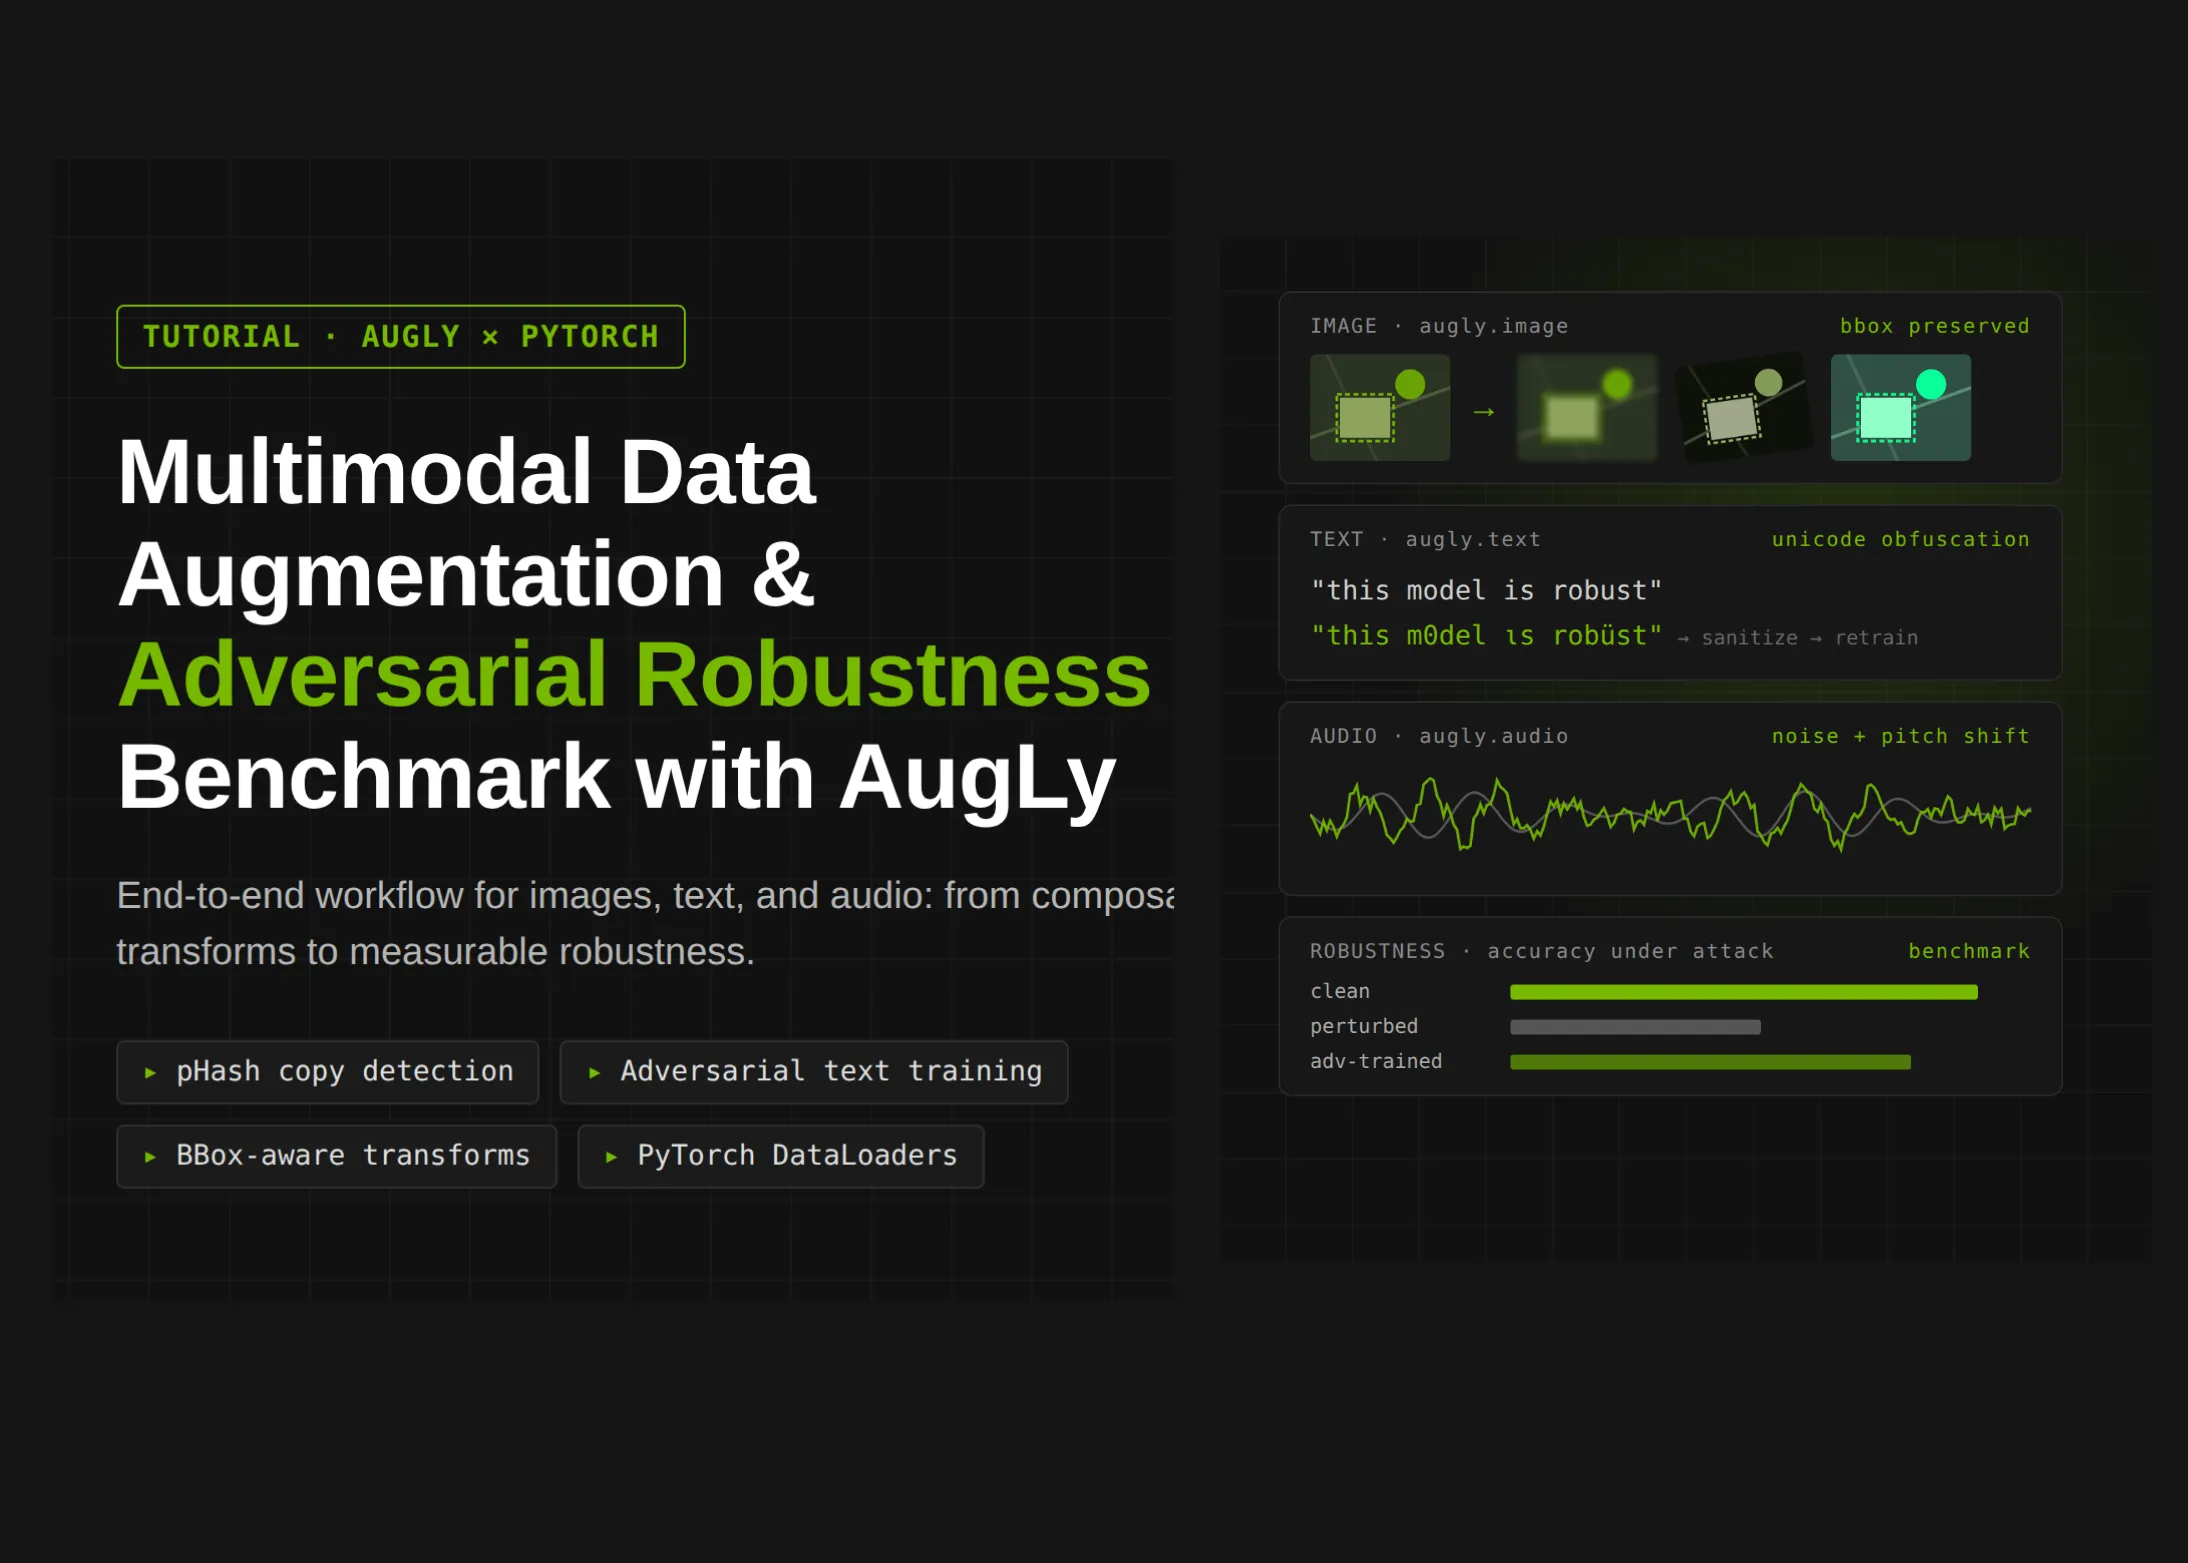
Aici intervine AugLy. Lansată de echipa Meta AI, biblioteca oferă peste o sută de transformări gata de folosit, împărțite pe cele patru modalități amintite. Pentru imagini, poți aplica blur, schimbări de luminozitate, suprapuneri de text, rotații, decupaje sau efecte de tip „screenshot de telefon”. Pentru text, AugLy poate introduce greșeli de tastare, sinonime, schimbări de diacritice, variații de limbaj sau chiar mimică stilul unui utilizator grăbit care scrie pe telefon. Pentru audio, biblioteca permite suprapunerea de zgomot de fond, modificarea vitezei, a tonului sau simularea unei convorbiri telefonice de proastă calitate. Iar pentru video, transformările includ schimbări de rezoluție, suprapuneri grafice sau efecte de compresie.
De ce contează toate acestea? Pentru că modelele de inteligență artificială sunt, în esență, niște paraziți ai mediului în care au fost antrenate. Un clasificator de imagini antrenat doar pe fotografii de studio va da greșit atunci când îi arăți o poză făcută noaptea, cu telefonul, într-o parcare. Un model de recunoaștere vocală antrenat pe înregistrări curate va eșua lamentabil când utilizatorul vorbește din metrou. Iar un detector de spam antrenat pe e-mailuri „curate” va fi păcălit de un text cu diacritice lipsă și litere amestecate.
Aici ajungem la partea cea mai interesantă și, totodată, cea mai sensibilă: robustețea adversarială. Un atac adversarial este o modificare aproape imperceptibilă pentru ochiul uman, dar care determină un model să greșească catastrofal. Clasicul exemplu: o fotografie cu un panda căreia i se adaugă un zgomot microscopic poate fi clasificată de o rețea neuronală drept „gibon”, cu o încredere de 99%. Pentru un om, imaginea rămâne un panda. Pentru model, este un gibon. Această vulnerabilitate nu este o curiozitate academică — este o problemă de securitate. Gândește-te la un sistem de recunoaștere facială folosit la o poartă de acces, la un filtru de conținut dintr-o rețea socială sau la un sistem de diagnostic medical asistat de AI. Toate pot fi manipulate.
Augmentarea datelor, făcută corect, este una dintre cele mai eficiente metode de apărare. Nu este o soluție magică, dar este ieftină, rapidă și funcționează surprinzător de bine. Atunci când antrenezi un model pe mii de variații ale aceleiași imagini — rotite, întunecate, cu zgomot, comprimate — îl înveți, practic, să ignore detaliile irelevante și să se concentreze pe caracteristicile esențiale. Un atac adversarial care exploatează tocmai acele detalii irelevante devine mult mai puțin eficient.
Ceea ce face AugLy deosebit nu este doar varietatea transformărilor, ci faptul că este multimodală și integrată nativ cu PyTorch, framework-ul de deep learning al Meta. Asta înseamnă că un cercetător poate construi un pipeline complet — de la încărcarea datelor, la augmentare, la antrenare, la evaluarea robusteții — fără să scrie cod de la zero pentru fiecare modalitate. Într-o industrie în care timpul de la idee la prototip se măsoară în zile, nu în luni, acest lucru contează enorm.
Mai mult, AugLy a fost gândită ca un benchmark. Adică nu doar ca un instrument de antrenare, ci și ca o modalitate de a măsura cât de rezistent este un model la perturbații realiste. Și aici apare o nuanță importantă: perturbațiile realiste nu sunt aceleași cu atacurile adversariale matematice, optimizate de algoritmi. Sunt perturbațiile pe care le întâlnești în viața de zi cu zi — o poză blurată, un text cu typo-uri, un audio cu ecou. Un model care rezistă la acestea este un model util în producție, chiar dacă nu este invulnerabil la atacuri sofisticate.
Există, desigur, și critici. Unii cercetători susțin că augmentarea datelor oferă o falsă senzație de securitate, pentru că un atacator determinat poate adapta atacul la transformările folosite la antrenare. Alții atrag atenția că prea multă augmentare poate dăuna performanței pe datele curate — modelul devine „paranoic” și ratează cazuri simple. Adevărul, ca de obicei, este undeva la mijloc: augmentarea nu înlocuiește alte tehnici de apărare, dar este o componentă esențială a oricărui sistem serios.
Ceea ce merită subliniat este direcția în care merge industria. Acum câțiva ani, augmentarea datelor era un „nice to have”, o optimizare pe care o făceai la finalul proiectului, dacă mai aveai timp. Astăzi, este o etapă obligatorie în orice pipeline de machine learning care se respectă. Iar instrumente precum AugLy — open-source, documentate, integrate cu ecosistemul PyTorch — democratizează accesul la tehnici care altădată erau disponibile doar echipelor marilor companii.
Într-un peisaj în care modelele devin din ce în ce mai mari, mai scumpe și mai greu de antrenat, augmentarea inteligentă a datelor rămâne una dintre puținele pârghii care oferă câștiguri reale fără costuri uriașe. Nu trebuie să construiești un supercomputer ca să faci un model mai robust. Trebuie, în schimb, să înțelegi că datele nu sunt doar materie primă — sunt și teren de antrenament pentru rezistență. Iar AugLy este, deocamdată, unul dintre cele mai bune săli de sport pentru modelele care vor să supraviețuiască în lumea reală.
De ce este important:
Augmentarea datelor multimodale și testarea robusteții adversariale nu mai sunt subiecte de nișă academică, ci fundația pe care se construiește încrederea în sistemele AI care ajung în spitale, bănci, mașini autonome și platforme sociale. AugLy, prin faptul că este open-source și acoperă simultan imagini, text, audio și video, reduce bariera de intrare pentru echipele mici și mijlocii care vor să construiască modele rezistente la condiții reale, nu doar la laborator. Într-o eră în care un atac adversarial bine țintit poate compromite un sistem de securitate sau poate manipula un filtru de conținut, capacitatea de a antrena și de a măsura robustețea devine o competență strategică, nu un lux tehnic. Cu cât mai mulți dezvoltatori folosesc astfel de instrumente, cu atât mai puțin fragile devin sistemele de care depindem zi de zi — și cu atât mai greu le va fi celor care încearcă să le păcălească.