Hai să o luăm pe rând, pentru că merită înțeles ce se întâmplă aici. Liquid AI nu este un nume la fel de sonor precum OpenAI, Google sau Anthropic, dar în comunitatea open-source și-a câștigat respectul prin abordarea sa neconvențională. În loc să construiască rețele neuronale clasice, bazate pe arhitecturi Transformer masive, echipa lucrează cu așa-numitele „modele lichide" — sisteme dinamice care își adaptează comportamentul în funcție de input, inspirate din modul în care funcționează neuronii reali. Rezultatul? Modele mai mici, mai eficiente, care pot rula pe dispozitive cu resurse limitate, fără să sacrifice prea mult din calitate.
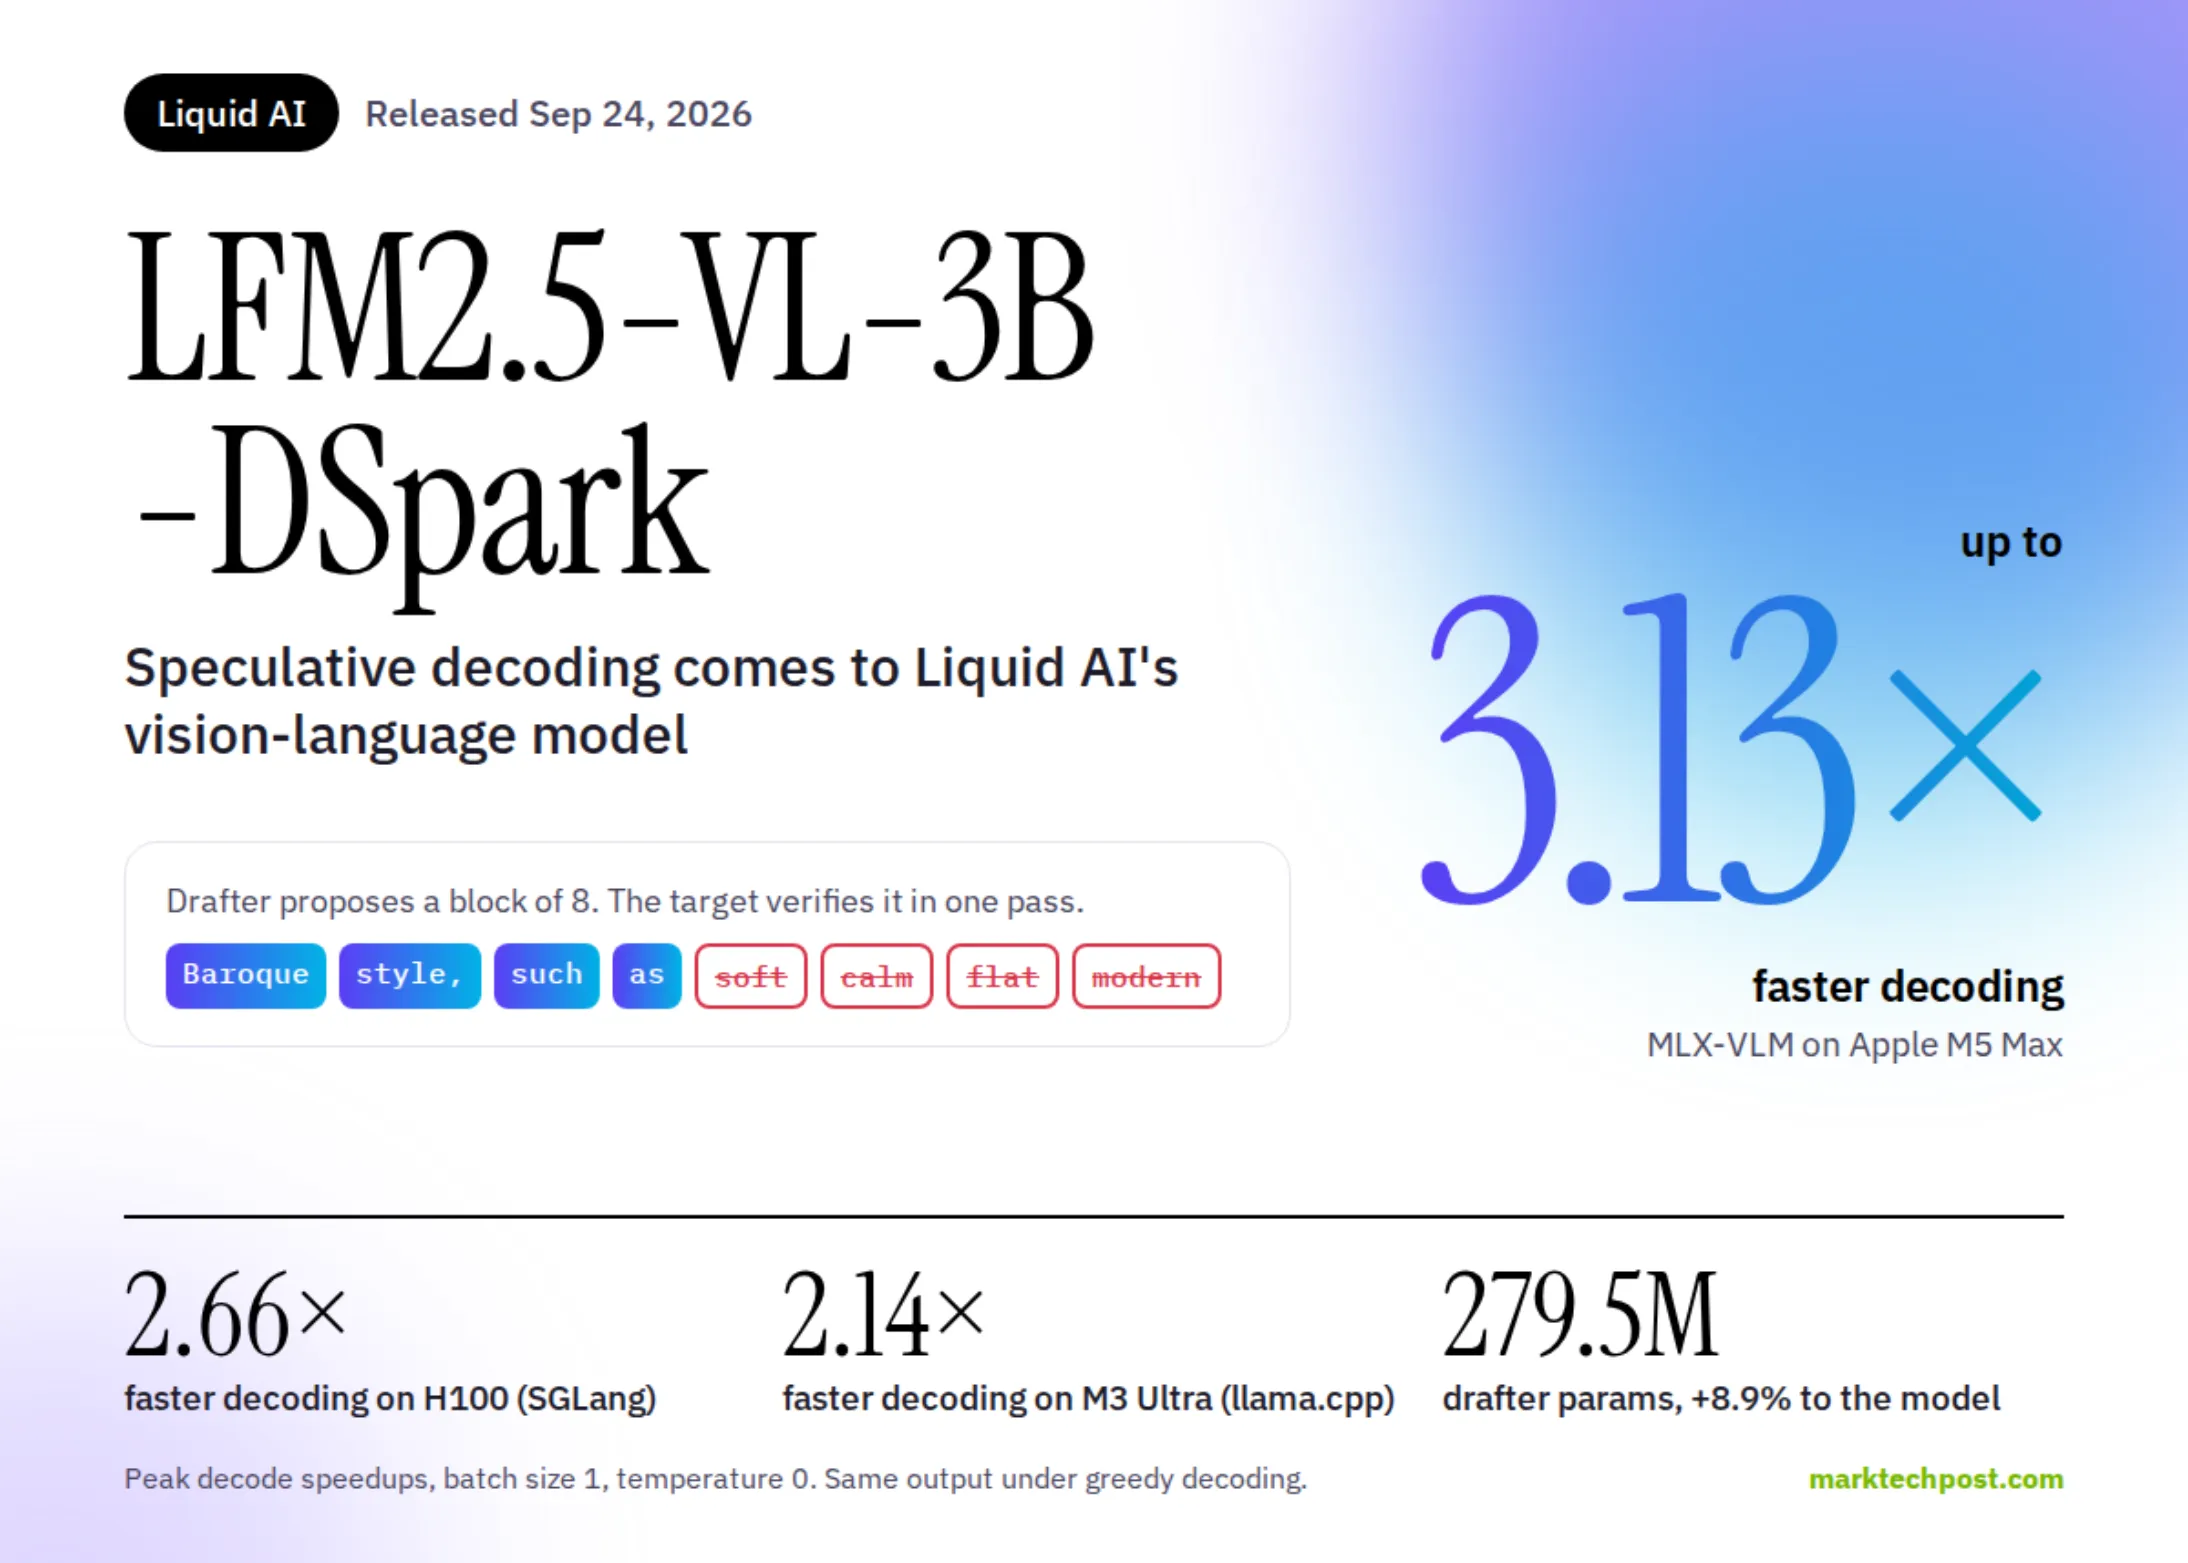
Acum, noul LFM2.5-VL-3B-DSpark vine cu o promisiune îndrăzneață: decodare de până la 3,13 ori mai rapidă pentru modelele vizual-lingvistice. Ca să înțelegem de ce contează asta, trebuie să ne oprim puțin asupra conceptului de decodare speculativă.
Ce este, de fapt, decodarea speculativă?
Imaginați-vă că vorbiți cu un asistent AI care trebuie să descrie o fotografie. În spatele scenei, modelul generează text cuvânt cu cuvânt — sau, mai precis, token cu token. Fiecare token necesită o trecere completă prin rețeaua neuronală, ceea ce consumă timp și putere de calcul. Când ai de generat sute de cuvinte, aceste micro-întârzieri se adună și transformă o conversație fluidă într-o așteptare frustrantă.
Decodarea speculativă rezolvă problema printr-un truc inteligent: în loc să genereze un singur token pe rând, folosește un model mic și rapid — numit „draft" sau „speculator" — care propune mai mulți tokeni deodată. Apoi, modelul mare și precis verifică aceste propuneri în paralel și le acceptă sau le respinge. Dacă draft-ul nimerește bine, câștigi timp prețios. Dacă greșește, pierzi doar o fracțiune de secundă. Este ca și cum ai avea un asistent care îți citește gândurile și îți completează propozițiile, iar tu doar confirmi dacă a nimerit.
Până acum, această tehnică era folosită mai ales la modelele de limbaj pure. Aplicarea ei la modelele vizual-lingvistice — cele care procesează simultan imagini și text — este mult mai complicată, pentru că trebuie să sincronizezi două fluxuri de informație complet diferite. Aici intervine noutatea celor de la Liquid AI.
De ce contează sufixul „DSpark"
Numele DSpark nu este întâmplător. Sugerează o scânteie — un mecanism care aprinde rapid procesul de generare. În esență, echipa a reușit să integreze un model speculator specializat care înțelege contextul vizual și propune tokeni relevanți pentru descrieri de imagini, răspunsuri la întrebări despre fotografii sau analize vizuale complexe. Rezultatul: o accelerare de până la 3,13x, ceea ce înseamnă că ceea ce dura trei secunde se poate rezolva acum într-o singură secundă.
Pentru utilizatorul obișnuit, asta se traduce prin aplicații mult mai responsive: asistenți care descriu instantaneu ce văd, instrumente de accesibilitate pentru persoanele cu deficiențe de vedere, sisteme de moderare a conținutului care analizează imagini în timp real. Pentru dezvoltatori, înseamnă costuri mai mici de inferență — și, implicit, posibilitatea de a oferi servicii mai ieftine sau chiar gratuite.
Contextul mai larg: cursa pentru eficiență
Lansarea celor de la Liquid AI nu vine din vid. Întreaga industrie se confruntă cu o problemă de scalare: modelele devin tot mai mari, iar costurile de rulare explodează. GPT-4, Claude sau Gemini consumă cantități uriașe de energie pentru fiecare răspuns. Companiile caută febril soluții pentru a reduce aceste costuri fără a sacrifica calitatea.
În acest peisaj, mișcări precum cea a Liquid AI sunt semnale importante. Ele arată că inovația nu mai vine doar de la giganți, ci și de la laboratoare agile, care mizează pe eficiență și pe contribuții open-source. Faptul că modelul este disponibil public — cu greutăți deschise — înseamnă că oricine poate să îl testeze, să îl modifice și să îl integreze în propriile produse. Este un gest care accelerează întregul ecosistem.
Desigur, există și limitări. Modelul are doar 3 miliarde de parametri, ceea ce îl face potrivit pentru sarcini specifice, dar nu pentru raționamente complexe sau conversații lungi și nuanțate. Nu va înlocui un GPT-4 într-o dezbatere filosofică. Dar pentru aplicații practice — recunoașterea obiectelor, descrierea scenelor, răspunsuri rapide la întrebări vizuale — este mai mult decât suficient, iar viteza suplimentară îl face deosebit de atractiv.
Ce urmează?
Dacă tendința continuă, ne putem aștepta ca decodarea speculativă să devină standardul în toate modelele multimodal. Viteza de inferență va deveni un criteriu la fel de important ca acuratețea, iar utilizatorii vor începe să o perceapă ca pe o necesitate, nu ca pe un lux. Liquid AI a deschis un drum pe care, foarte probabil, îl vor urma și alții.
Rămâne de văzut cât de repede vor reuși cercetătorii să împingă plafonul mai sus. 3,13x este impresionant, dar nu este sfârșitul poveștii. Cu fiecare iterație, granița dintre „rapid" și „instantaneu" se subțiază. Iar pentru noi, cei care folosim aceste tehnologii zi de zi, asta înseamnă doar un lucru: mai puțin timp pierdut așteptând, mai mult timp petrecut creând.
De ce este important:
Această lansare contează din trei motive majore. În primul rând, demonstrează că decodarea speculativă — o tehnică până acum rezervată modelelor de limbaj — poate fi extinsă cu succes la modelele vizual-lingvistice, ceea ce deschide uși pentru aplicații multimodale mult mai rapide. În al doilea rând, confirmă că inovația reală în AI nu mai vine exclusiv de la giganți: laboratoare mai mici, precum Liquid AI, pot aduce contribuții semnificative prin abordări neconvenționale și prin eliberarea greutăților în open-source. În al treilea rând, într-o industrie obsedată de scalare și de modele tot mai mari, eficiența devine noul câmp de bătălie. O accelerare de 3,13x nu este doar un număr frumos pe hârtie — înseamnă costuri mai mici, aplicații mai responsive și, în final, acces mai larg la tehnologie pentru toată lumea. Cursa pentru viteză abia a început, iar Liquid AI tocmai a tras un semnal puternic că vrea să fie în fruntea ei.