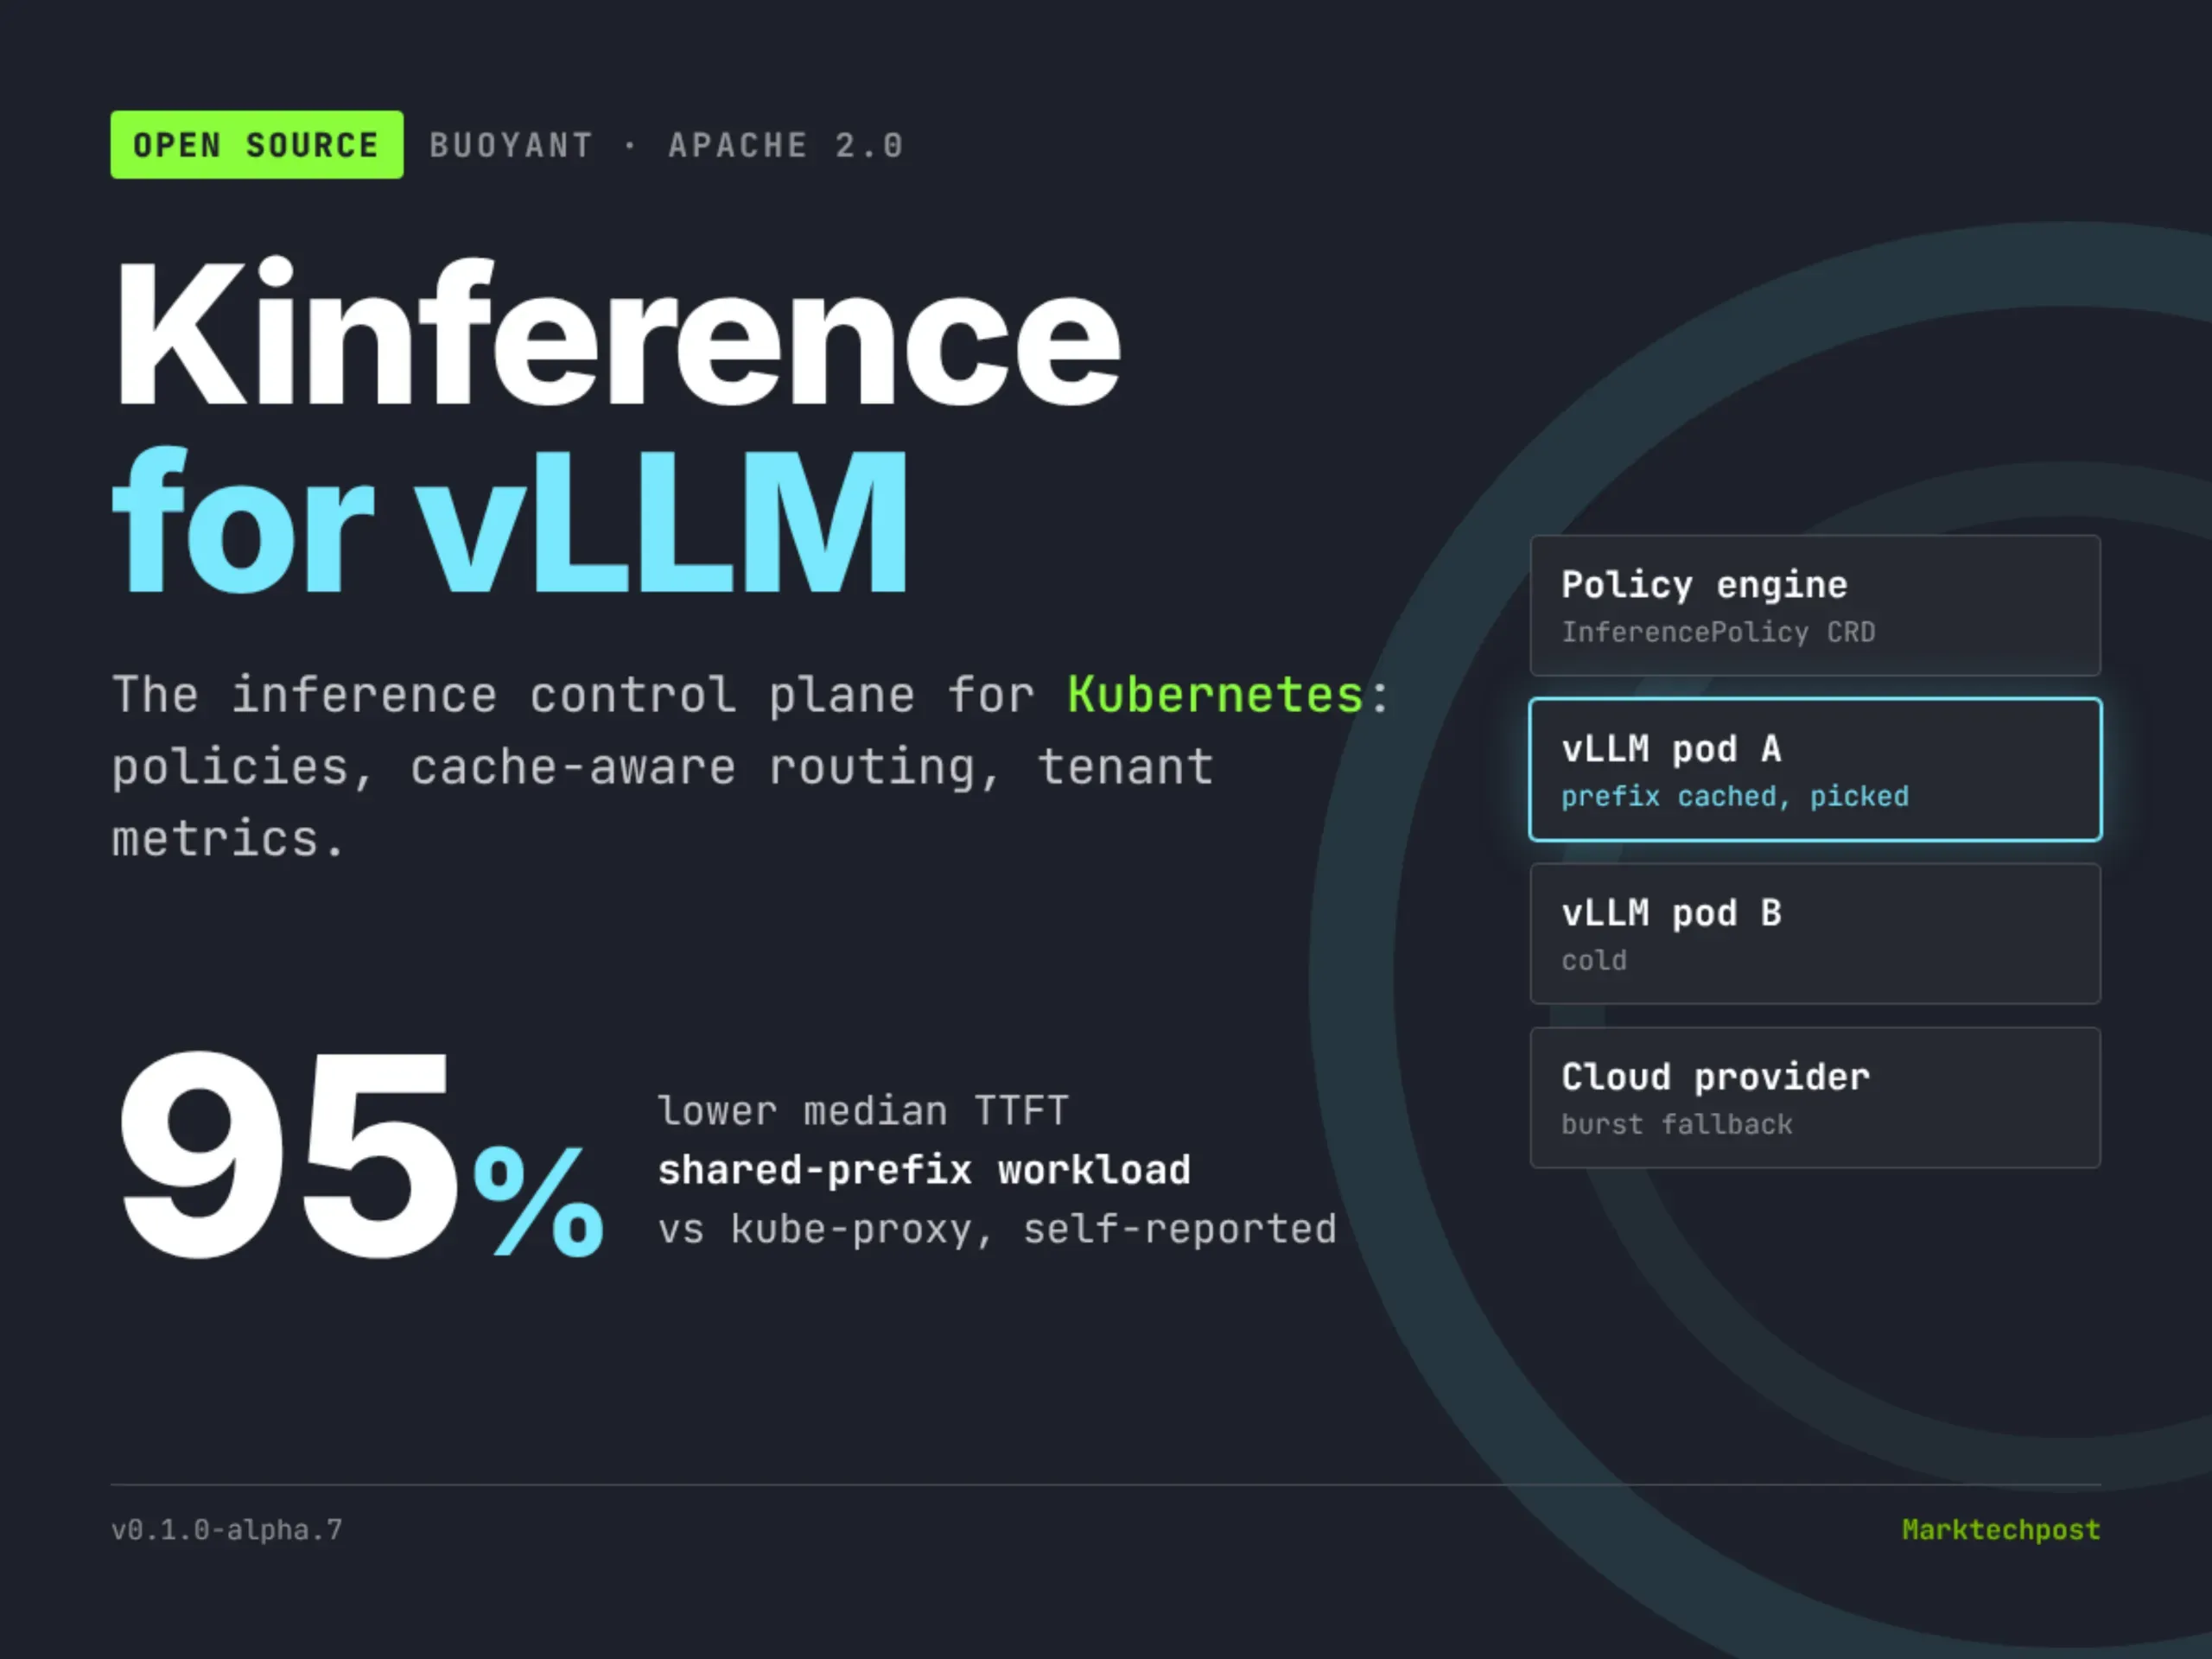
Pentru cei inițiați, Buoyant nu este un jucător nou în spațiul cloud-native. Fondată de William Morgan și Oliver Gould, compania a construit reputația pe Linkerd, cel mai ușor și mai sigur service mesh pentru Kubernetes, adoptat de giganti precum Nordstrom, HP și Microsoft. Acum, cu Kinference, echipa aplicate aceeași filozofie — simplitate, securitate, observabilitate zero-config — problemei ardente a inferenței LLM în producție.
Problema: Inferența LLM este un capcană operativă
Orice echipă care a încercat să servească un model precum Llama 3, Mistral sau Mixtral la scară largă cunoaște durerile de cap: gestionarea memoriei GPU, planificarea cererilor cu lungimi de context variabile, batching-ul continuu (continuous batching), prefix caching, și, nu în ultimul rând, routing-ul inteligent al traficului între instanțe pentru a maximiza throughput-ul și a minimiza latenta. Adăugați la asta necesitatea de a face rolling updates fără downtime, canary deployments pentru noi versiuni de modele, și observabilitate profundă (metrici de tip TTFT — Time To First Token, TBT — Time Between Tokens, utilization GPU), și aveți un cosmar operativ care depășește de mult complexitatea unui microserviciu clasic.
vLLM a devenit de facto motorul de inferență open-source preferat, din cauza arhitecturii sale PagedAttention revoluționare și a suportului nativ pentru continuous batching. Dar vLLM este un motor, nu o platformă. Lipsesc primitivele de control plan: service discovery, load balancing aware de stare (kv-cache awareness), traffic splitting, policy enforcement, mTLS între cliente și workeri. Aici intervine Kinference.
Ce este Kinference de fapt?
La nivel arhitectural, Kinference este un operator Kubernetes (împăachetat ca Helm chart) care instalează un control plane dedicat inferenței. Componentele sale principale includ:
1. Kinference Controller: Operatorul care reconciliază starea dorită (definită prin CRD-uri) cu starea actuală a clusterului. Gestionează cycle-ul de viață al `InferenceService`-urilor, `Model`-urilor și `LoRAAdapter`-elor.
2. Kinference Proxy (Data Plane): Un proxy de performanță ridicată, scris în Rust (pe baza linkerd2-proxy), care ședează în fața fiecărui pod vLLM. Acesta nu face doar round-robin. Implementează KV-cache aware routing — direcționează cererile către instanța care are deja prefixul relevant în cache, reducând dramatic latenta și consumul de compute.
3. CRD-uri Native Kubernetes: `InferenceService`, `Model`, `ModelClaim`, `LoRAAdapter`. Acestea permit declararea intenției: "Vreau 3 replici ale Llama-3-70B-Instruct cu 2 LoRA adapters pentru coding și summarization, cu canary deployment la 10% trafic". Controllerul se ocupă de restul: provisionare GPU-uri (via device plugin-uri), configurare vLLM args, generare certificate mTLS, înregistrare în service discovery.
4. Observabilitate Integrată: Dashboards Grafana out-of-the-box, alerte PrometheusRule, distributed tracing prin OpenTelemetry. Metrici specifice LLM (prefill latency, decode latency, queue time, cache hit rate) sunt expuse automat.
Inovația cheie: KV-Cache Aware Load Balancing
Aceasta este, fără îndoială, "killer feature". În vLLM clasic, dacă ai 4 replici și trimiți request-uri round-robin, cache-ul KV (Key-Value) este fragmentat. Fiecare replică construiește propriul cache pentru prefixe comune (system prompts, few-shot examples, RAG context). Kinference Proxy inspectează request-ul (în mod transparent, la nivel HTTP), extrage hash-ul prefixului (folosind mecanismele vLLM de prefix caching), și routează cererea către replica care are cel mai mare cache hit probability. Rezultatul? Reduceri de 30-60% în TTFT (Time To First Token) pentru workload-uri cu prefixe comune (chatbots cu system prompt fix, RAG, agentic workflows).
Securitate și Multi-tenancy by Default
În era RAG-ului și a agentelor, izolarea tenantilor este critică. Kinference impune mTLS mutual între orice client (un alt pod Kubernetes, un API gateway, un agent) și workerele vLLM. Certificatele sunt rotite automat (SPIFFE/SPIRE integration). Authorization policies (în stil OPA/Gatekeeper) pot fi aplicate la nivel de `ModelClaim`: "Echipa Marketing poate accesa doar Llama-3-8B cu LoRA-ul de copywriting, cu rate limit de 50 req/min". Acest lucru transformă clusterul GPU într-o platformă internă partajată, sigură și auditată.
Experiența Developer-ului: GitOps Native
Kinference nu vine cu o UI proprietară obligatorie. Toate configurațiile sunt resurse Kubernetes. Acest lucru înseamnă: ArgoCD / Flux GitOps flow nativ. Vrei să faci rollback la o versiune anterioară a modelului? `git revert`. Vrei să promovi canary-ul la 100%? Editezi YAML-ul `InferenceService` și mergi. Secret-urile (HuggingFace tokens pentru modele private, chei de criptare) sunt gestionate prin External Secrets Operator sau SealedSecrets. Zero vendor lock-in la nivel de tooling.
Comparativ: De ce nu doar KServe / KubeAI / TGI / Triton?
Landșape-ul este aglomerat. KServe (fost KFServing) este standardul de facto pentru model serving generic, dar este greu, complex (Knative dependency), și nu are optimizări specifice vLLM/KV-cache. TGI (Text Generation Inference) de la Hugging Face este excelent dar legat de ecosistemul HF și are un proxy propriu (router) care nu se integrează nativ cu service mesh-uri. Triton de la NVIDIA este puternic dar enterprise-heavy. Kinference nu încearcă să le înlocuiască pe toate — el se specializează pe vLLM pe Kubernetes, făcând această combinație să funcționeze ca un ceas elvețian. Este complementar: poți folosi KServe pentru modelele tale de embedding/clasificare clasice, și Kinference pentru LLM-urile generative grele.
Comunitate și Roadmap
Proiectul este lansat sub licență Apache 2.0 pe GitHub (buoyantio/kinference). Buoyant a confirmat că Kinference va rămâne open-source core, cu un model de business similar Linkerd: suport comercial, feature-uri enterprise (ex: multi-cluster federation, advanced cost attribution/showback, FIPS compliance) în oferta Buoyant Cloud. Roadmap-ul public include: suport pentru vLLM V1 (noua arhitectură disagregată prefill/decode), integrare cu NVIDIA Dynamo / Inference Microservices (NIM), autoscaling bazat pe SLO (nu doar CPU/GPU util), și suport pentru modele multimodale (LLaVA, Qwen-VL).
Concluzie: Maturizarea infrastructurii GenAI
Lansarea Kinference semnalizează trecerea de la faza "experimentăm cu LLM-uri pe laptopuri" la "rulăm LLM-uri ca servicii critice de business". La fel cum Linkerd a adus service mesh-ul la mase făcându-l simplu și sigur, Kinference promit să facă inferența LLM la scară largă să fie o operare rutină, nu un proiect de cercetare. Pentru orice organizație care rulează Kubernetes și are nevoie să servească modele open-source (Llama, Mistral, Qwen, Gemma) eficient, sigur și observabil, Kinference merită evaluată acum, în faza incipientă, pentru a influența direcția proiectului și a evita lock-in-ul în soluții proprietare costisitoare.
De ce este important:
Kinference reprezintă maturizarea infrastructurii pentru AI generativă, aducând practici SRE dovedite (mTLS, GitOps, observabilitate, canary deployments) în spațiul inferenței LLM. Rezolvă problema critică a fragmentării KV-cache prin routing inteligent, reduce costurile GPU prin utilizare eficientă, și elimină complexitatea operativă prin abstracții native Kubernetes. Este un pas esențial spre democratizarea accesului la infrastructură AI de clasă enterprise, fără vendor lock-in.