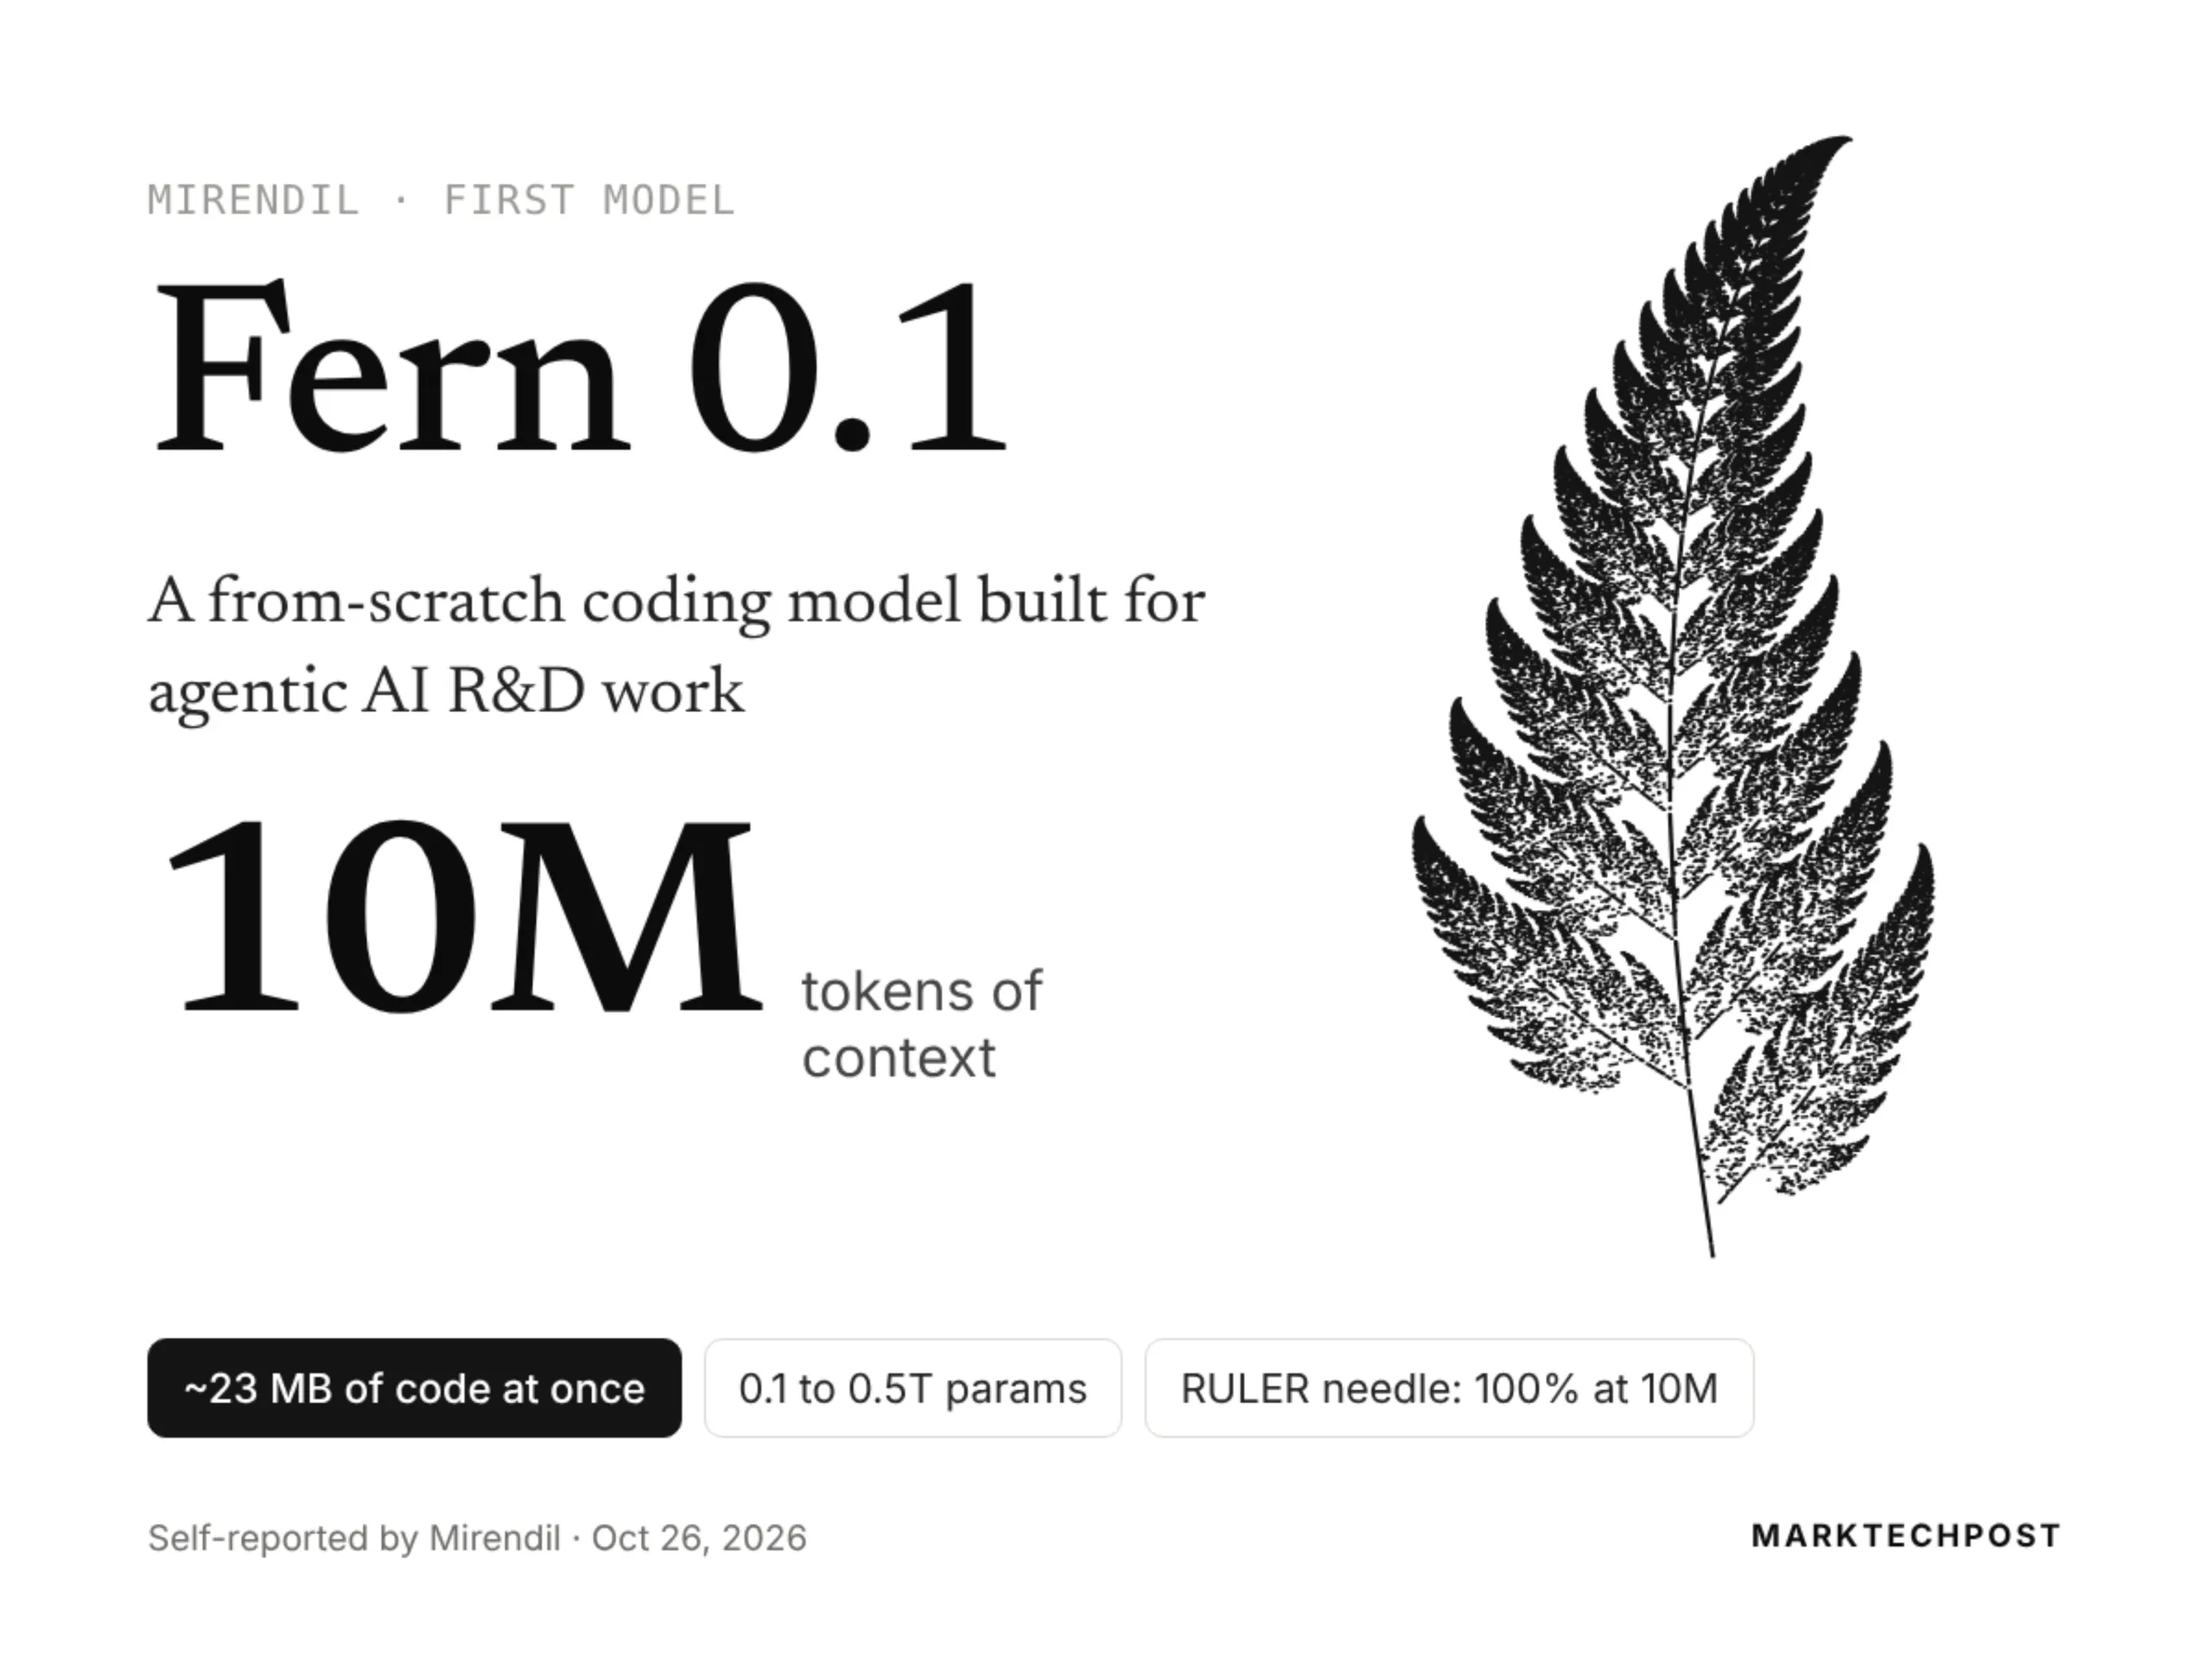
Ce înseamnă, de fapt, 10 milioane de token-uri? Pentru a pune lucrurile în perspectivă: un token este, grosier, trei patrule dintr-un cuvânt în engleză. Zece milioane de token-uri echivalează cu aproximativ 7,5 milioane de cuvinte. Aceasta înseamnă că modelul poate "citi" și reține, într-o singură conversație, conținutul a aproximativ 15.000 de pagini de text obișnuit. Sau, mai concret, întreaga bibliografie a unui doctorat, codul sursă complet al unui proiect software enterprise, sau arhiva completă a corespondenței interne a unei companii de mijlociu. Implicațiile sunt profunde: nu mai trebuie să decupezi documente, să folosești RAG (Retrieval-Augmented Generation) ca o muleță, sau să te îngrijorezi că modelul a uitat începutul conversației când ajungi la final.
Arhitectura tehnică din spatele Fern 0.1 rămâne, pentru moment, parțial în umbră. Mirendil nu a publicat un articole științific detaliat la lansare, ci a preferat o abordare de tip "open weights" – greutățile modelului sunt disponibile pentru descărcare și rulare locală, sub o licență permisivă care permite utilizarea comercială. Aceasta este o știre excelentă pentru comunitatea de dezvoltatori și cercetători care au simțit presiunea creșterii costurilor API și a dependenței de furnizorii mari. Totuși, lipsa unui paper tehnic complet înseamnă că, deocamdată, trebuie să ne bazăm pe benchmark-urile publicate de compania și pe testele comunității pentru a înțelege cum au reușit să scaleze atenția la această magnitudine fără ca costurile computaționale să explodeze. Presupunerea dominantă este că au folosit o variantă a mecanismului de atenție rară (sparse attention) sau o arhitectură hibridă care combină atenția clasică cu mecanisme de tip RNN sau state space models (precum Mamba) pentru secvențele lungi, păstrând atenția densă doar pentru o fereastră locală recentă.
Impactul asupra fluxurilor de lucru practice este imediat. În inginerie software, Fern 0.1 poate primi întregul codebase al unei aplicații complexe – frontend, backend, infrastructură, teste, documentație – și să răspundă la întrebări care necesită înțelegerea interdependențelor dintre module distante. "De ce această schimbare în modul de autentificare a rupt pipeline-ul de date din serviciul de facturare?" este o întrebare pe care un model cu 128k token-uri nu o poate răspunde decât dacă i-ai dat tu fișierele relevante manual. Fern o poate răspunde singur, pentru că are toate fișierele în context. În analiză juridică și due diligence, avocații pot încărca mii de contracte, anexe, email-uri și note interne, și să ceară modelului să identifice toate clauzele de schimbare de control, sau toate expozițiile la un anumit reglement, fără a pierde nicio referință subtilă ascunsă în pagina 4.000 a unui document.
Dar nu totul e roz. Un context de 10M token-uri aduce provocări masive la inferență. Memoria KV cache (Key-Value) pentru o singură secvență de 10M token-uri, la precizie bfloat16, pentru un model de dimensiune medie (să zicem 7-8 miliarde parametri), poate depăși 100-150 GB de VRAM. Asta înseamnă că rularea modelului la capacitate maximă necesită hardware de tip H100/A100 cu memorie mare sau clustere multi-GPU cu paralelism de tip tensor/pipeline. Pentru utilizatorul obișnuit cu o singură GPU de 24-48 GB VRAM, contextul practic va fi limitat de hardware, nu de arhitectură. Mirendil a anticipat asta și a lansat, alături de model, un motor de inferență optimizat (probabil bazat pe vLLM sau SGLang cu paginare KV cache și offloading CPU) care permite rularea pe hardware mai modest, sacrificând viteza pentru capacitate. De asemenea, au introdus un mecanism de "context streaming" care permite modelului să proceseze input-ul în chunk-uri, menținând o reprezentare compresată a istoricului, deși asta introduce o ușoară degradare a performanței pe task-uri care necesită recall perfect al detaliilor din începutul contextului.
Comunitatea open-source a reagit cu entuziasm amestecat cu scepticismul sănătos. Pe Hugging Face, repo-ul Fern-0.1 a acumulat mii de download-uri în primele 24 de ore, iar pe GitHub issue-urile tehnice au început să apară: teste de "needle in a haystack" la diferite adâncimi, benchmark-uri RULER, LongBench, și încercări de a sparge modelul cu input-uri adversariale concepute să confuzeze mecanismele de atenție rară. Primele rapoarte indică că Fern 0.1 excellează la task-uri de tip retrieval și sumarizare pe documente lungi, dar are performanțe mai slabe pe raționament complex multi-hop care necesită integrarea informațiilor din părți foarte distante ale contextului – o problemă cunoscută a arhitecturilor cu atenție rară. De asemenea, unele teste sugerează că modelul are o tendință să "halucineze" citate specifice când i se cere să citeze exact dintr-un document de 5M token-uri, preferând să generalizeze în loc să caute literal.
Strategic, lansarea lui Fern 0.1 plasează Mirendil într-o poziție unică pe piață. Nu concurează direct cu GPT-5 sau Claude 4 pe inteligență generală raw, ci domine o nică critică: contextul ultra-lung la costuri controlabile și cu control total al datelor. Aceasta este o propoziție de valoare puternică pentru enterprise, guvernamente, și organizații care nu pot sau nu vor să trimită datele sensibile la API-uri externe. Modelul este, de asemenea, o platformă excelentă pentru fine-tuning specializat: imaginează-ți un Fern-Medical antrenat pe milioane de dosare medicale, sau un Fern-Legal pe jurisprudență completă. Fereastra de 10M token-uri permite includerea întregului corpus de antrenament în context la inferență, eliminând nevoia de RAG extern pentru multe cazuri de utilizare.
Viitorul imediat al proiectului depinde de trei factori: calitatea documentației tehnice pe care Mirendil o va publica (un paper ar fi esențial pentru adoptarea academică și enterprise), stabilitatea și performanța motorului de inferență la scară largă, și capacitatea comunității de a construi tooling-ul necesar (chunking inteligent, caching semantic, evaluare automată de context lung). Dacă Mirendil reușește să transforme Fern dintr-un demo tehnic impresionant într-un instrument de producție robust, avem de a face cu un moment de tip "Linux pentru context lung" – o fundație open pe care se vor construi aplicațiile de următoarea generație.
Până atunci, recomandarea mea pentru echipele tehnice este: descărcați greutățile, rulați benchmark-urile voastre pe datele voastre reale, și testați motorul de inferență pe hardware-ul vostru. Nu vă bazați pe marketing. Datele vorbesc. Și, pentru prima dată, avem un model care poate asculta toată povestea, nu doar ultimul capitol.
De ce este important:
Lansarea Fern 0.1 marchează prima dată când un model open-weights oferă un context de 10 milioane de token-uri – o capacitate care elimina nevoia de sisteme RAG complexe în multe scenarii enterprise, permite analiza holistică a codebase-urilor mari, a arhivelor juridice sau medicale, și democratizează accesul la context ultra-lung fără dependență de API-uri proprietare costisitoare. Deși există provocări hardware și calitative de rezolvat, acest lucru reprezintă un punct de cotitură pentru suveranitatea datelor și pentru arhitectura aplicațiilor AI de următoarea generație.