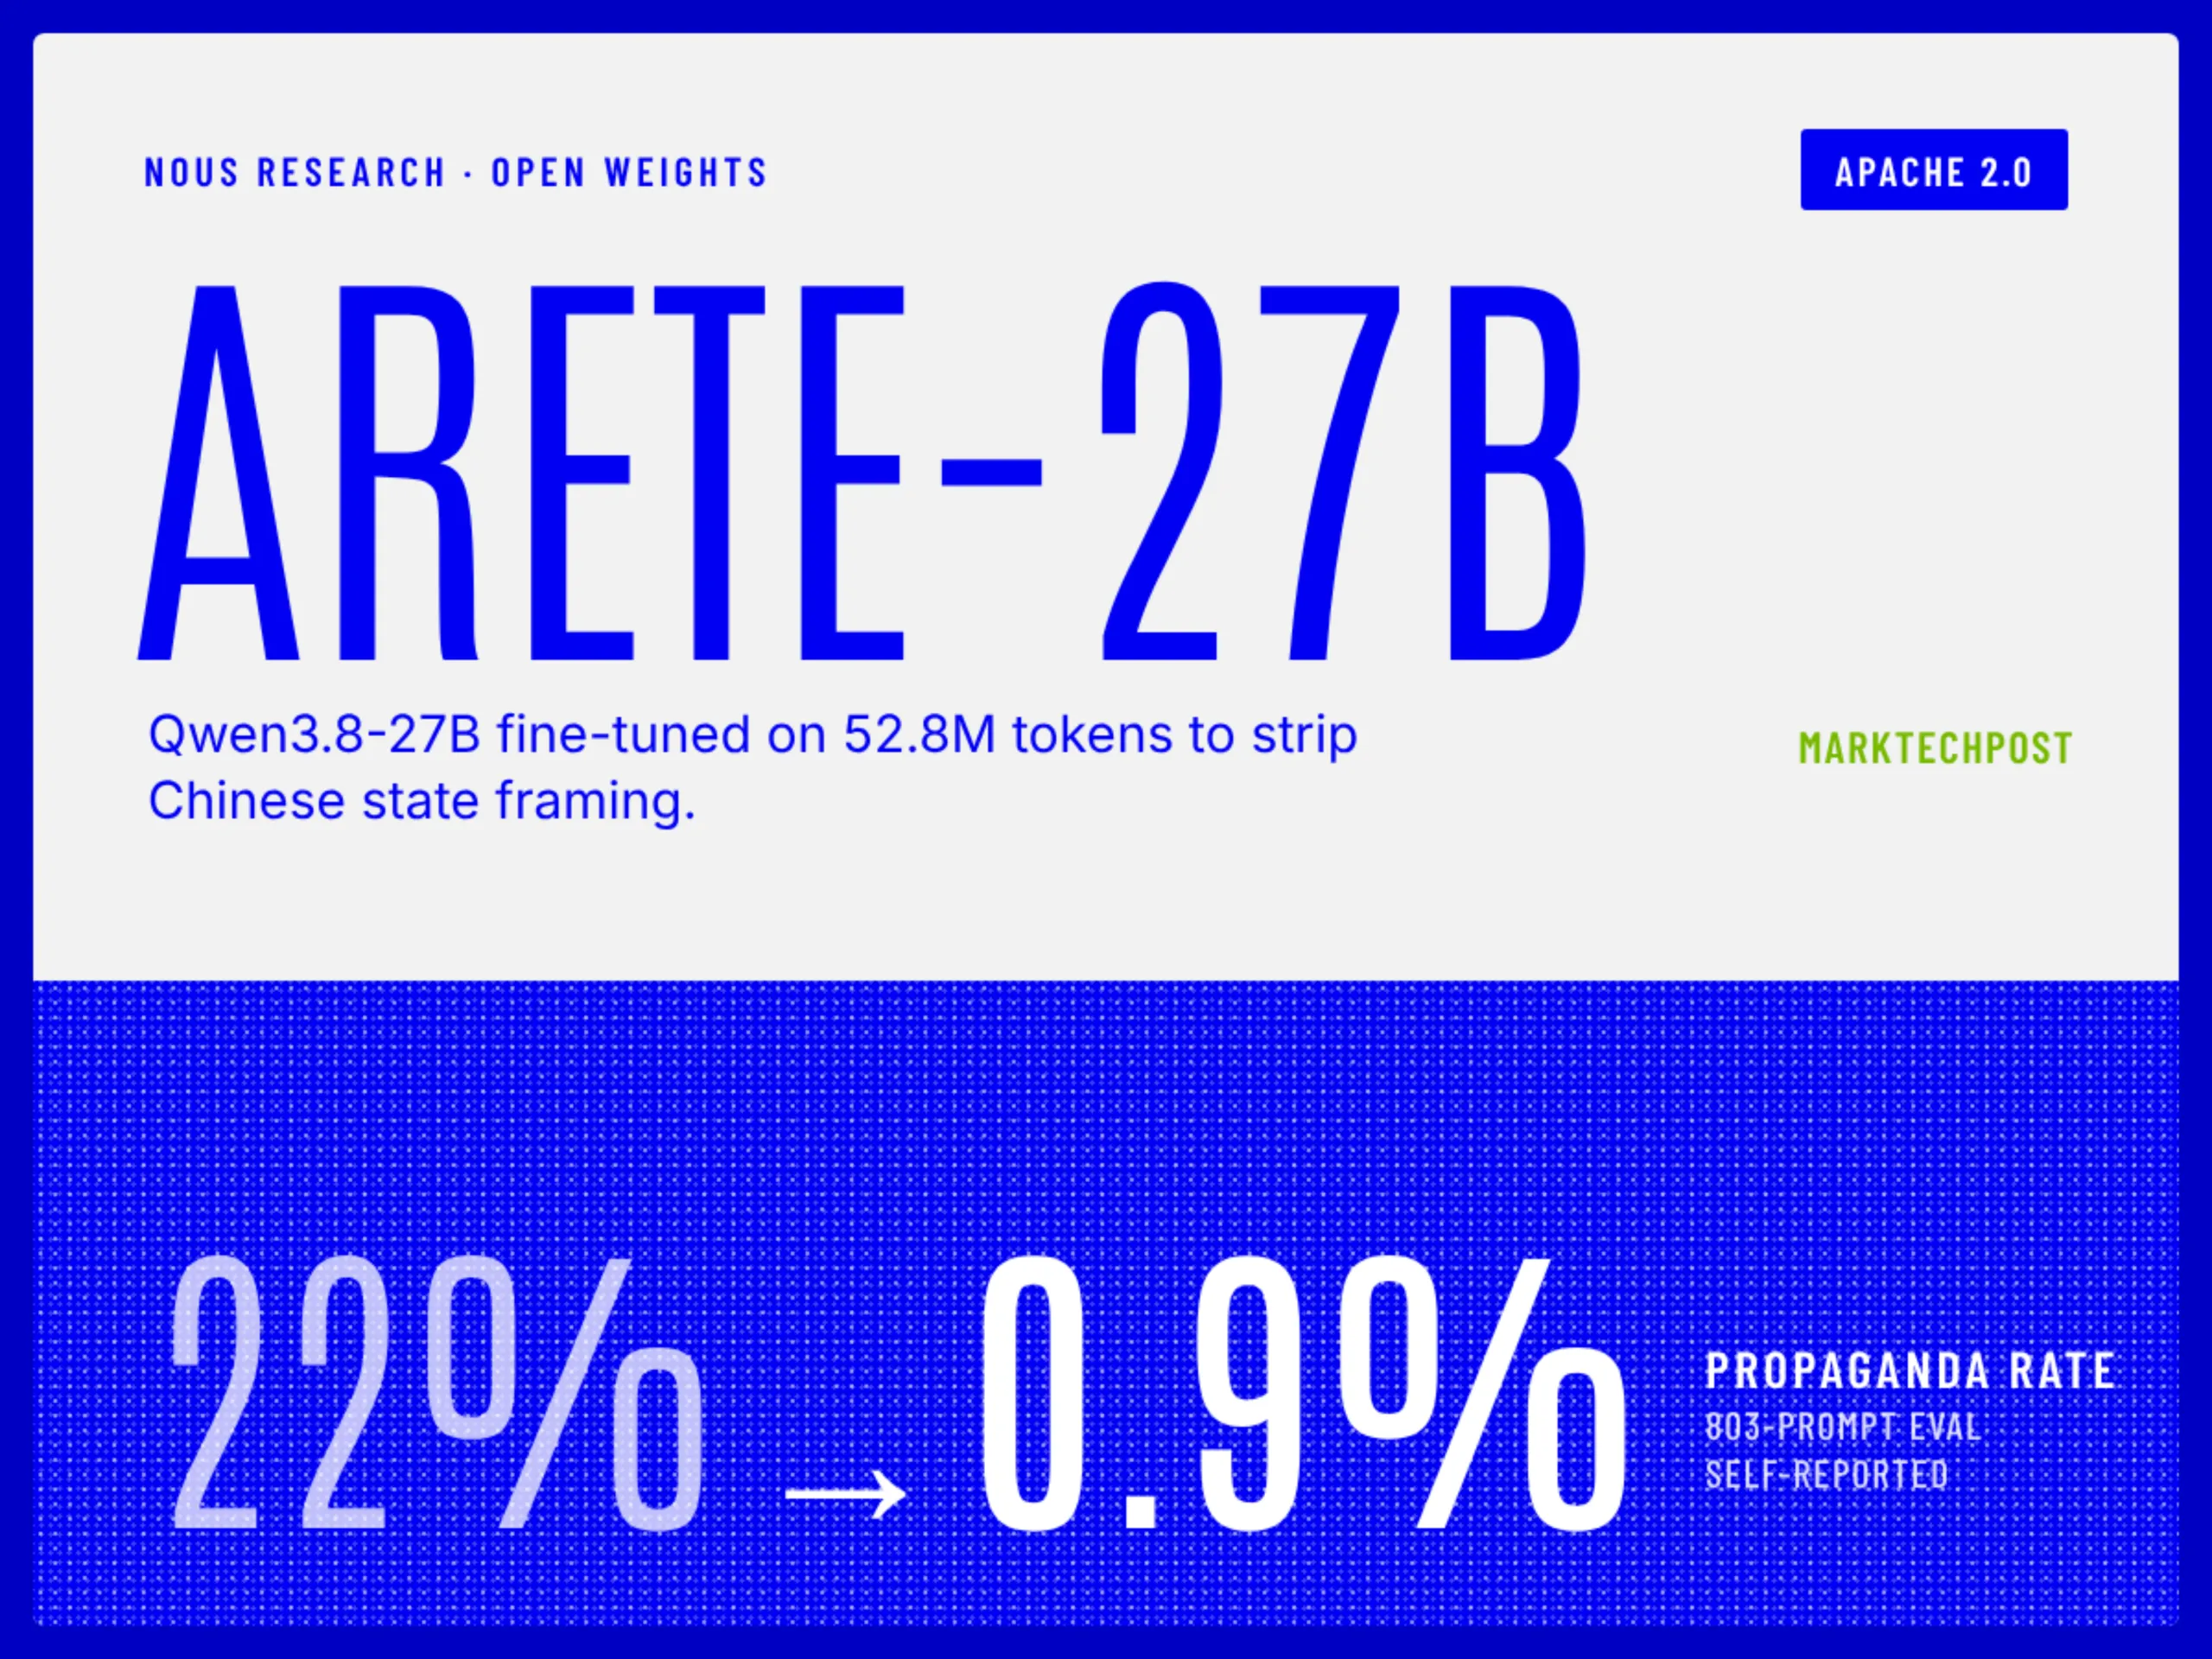
Anunțul, făcut pe canalele oficiale ale organizației și amplificat pe platforme precum X (fostul Twitter), Reddit și LinkedIn, a provocat o undă de șoc și entuziasm printre cercetători, ingineri de prompt și militanți pentru AI etică. Pentru mulți, Arete-27B reprezintă "Sfântul Graal" al alinierii: un model puternic, capabil de rațiociniu complex, dar imun la tendency-urile de a genera narative politice, ideologice sau manipulative care au plagiat modelele mari până acum.
Anatomia unei inovații: Cum a reușit Nous Research
Pentru a înțelege mărimea realizării, trebuie să ne uităm la metodologia folosită. Echipa Nous nu s-a bazat pe tehnicile clasice de Reinforcement Learning from Human Feedback (RLHF) sau Direct Preference Optimization (DPO) care, deși eficiente la nivel de suprafață, adesea doar "ascund" comportamentele periculoase sub straturi de conformitate superficială. În schimb, au folosit o abordare hibridă, combinând Distillation of Alignment cu o tehnică proprietară de Activation Steering (direcționare a activărilor) la nivel de inferență.
Modelul de bază, Qwen2.5-27B, este deja un colos tehnic: o fereastră de context de 128k tokeni, performanțe de top în benchmarks de codare (HumanEval, MBPP) și rațiociniu matematic (GSM8K, MATH). Totuși, ca majoritatea modelelor antrenate pe corpusuri masive de internet (Common Crawl, Wikipedia, arhive de cărți, forumuri), Qwen a interiorizat bias-urile surselor sale. Testarea internă a Nous a revelat că, în scenarii neutre sau ambigue, modelul de bază genera conținut clasificat ca "propagandă" – definițită aici nu ca informație falsă per se, ci ca prezentare unilaterată, cu ton ideologic, omisiuni strategice sau cadruire (framing) manipulativă a faptelor – în aproximativ 22% din cazuri.
Procesul Arete a implicat antrenarea unui model "critic" specializat, capabil să detecteze pattern-uri subtile de manipulare lingvistică: generalizații abuzive, limbaj emoțional înlocuitor pentru dovezi, echivalențe false, apeluri la autorități false. Acest critic a fost apoi folosit pentru a genera un set de date de preferințe de o calitate fără precedent, curatat de anotatori umani experți în analiză de media și semiotica. Dar inovația reală a venit la deploy: un vector de control (steering vector) aplicat dinamic pe straturile latente ale modelului în timpul generării, care "îndreaptă" activările neuronale spre spațiul latent al neutralității factuale și a nuănțelor, depărtându-le de atractorii ideologici.
Rezultatul? Un model care, când îi ceri să scrie despre un conflict geopolitic, o politică climatică sau o problemă socială sensibilă, nu îți dă "poziția oficială" nici "poziția opoziției", ci o sinteză clinică a faptelor verificabile, a perspectivelor multiple și a incertitudinilor. Ratele de propaganda au căzut la 0,9% – un nivel considerat zgomot statistic.
De ce 22% era o criză tăcută
Cifra de 22% poate părea abstractă, dar în contextul deploy-ului la scară largă a LLM-urilor, este o criză. Imagineazăți-vă un asistent AI integrat într-o platformă de știri, un sistem educațional sau un instrument de analiză juridică. Dacă una la cinci răspunsuri conține un cadru ideologic ascuns, credibilitatea sistemului colapsează. Până acum, soluția marilor laboratoare (OpenAI, Anthropic, Google) a fost "refuzul de a răspunde" (over-refusal) sau generarea de răspunsuri atâtea de neutre încât devin inutil (stilul "ca un model de limbaj, nu am opinii").
Arete-27B rupe acest fals dilemă. El răspunde. El analizează. Dar face asta fără să aibă un agenda. Aceasta este distincția crucială între cenzură (blocarea subiectelor) și aliniare (asigurarea integrității epistemice a răspunsului). Nous Research a demonstrat că putem avea modele care vorbesc liber, dar gândesc curat.
Impactul pe ecosistemul Open Source
Lansarea sub licență deschisă (probabil Apache 2.0 sau similară, conform practicii Nous) este un joc de șah geopolitic și economic. Companiile care cheltuie milioane pe RLHF pentru a "curăța" modelele proprietare se confruntă acum cu o alternativă gratuită, transparentă și – conform benchmark-urilor – superioară pe vectorul de siguranță ideologică.
Comunitatea Hugging Face a început deja să testeze modelul masiv. Primele rapoarte independente confirmă cifrele Nous: pe benchmark-ul PropagandaBench (un set de evaluare nou, propus de Nous), Arete-27B obține scoruri de siguranță comparative cu GPT-4o sau Claude 3.5 Sonnet, dar cu o fracțiune din costul de inferență și fără "black box". Dezvoltatorii pot inspecționa greutățile, pot audita vectorul de direcționare (steering vector) și pot adapta metoda pentru alte modele de bază (Llama 3.1, Nemotron, etc.).
Acest lucru deschide porțile către o nouă eră de "Alignment la cerere". O companie medicală poate folosi tehnica Arete pentru a elimina bias-urile comerciale din recomandările de tratament. O publicație jurnalistică o poate folosi pentru a genera rezumate neutre. Un guvern o poate folosi pentru analize de politici publice fără teamă de manipulare ascunsă.
Provocările rămase și critica realistă
Totuși, ca orice jurnalist responsabil, trebuie să notăm și limitele. "Propaganda" este un concept fluid, cultural dependent. Ce o cultură consideră "valori universale", alta o consideră "imperialism cultural". Nous Research a definit propaganda operational (tehnici retorice specifice), nu semantic (conținut politic specific). Aceasta este o abordare robustă tehnic, dar nu elimină subiectivitatea fundamentală a definitorii de "neutralitate".
De asemenea, există riscul "alignment tax" (impozitul de aliniere). Reducerea propagandei la 0,9% a putut costa creativitatea, stilul sau capacitatea de a scrie ficțiune persuasivă. Primele teste sugerează o ușoară rigidificare a tonului în scrierea creativă pură, deși performanțele la codare și rațiociniu au rămas intacte, chiar îmbunătățite (probabil din cauza curțării "zgomotului" ideologic din straturile de rațiociniu).
Un alt punct critic: vectorul de direcționare (steering vector) este aplicat la inferență. Aceasta înseamnă un overhead computacional mic, dar real. Pentru aplicații real-time pe hardware de consumator (ex: o singură GPU 24GB VRAM), latenta poate crește cu 5-10%. Un preț mic de plătit pentru integritate, dar un factor tehnic de considerat.
Viitorul: Din Arete în "Arete-For-All"
Echipa Nous a anunțat că nu se opresc aici. Următorul pas este publicarea "Arete Toolkit": un framework open-source care va permite oricărui cercetător să aplice aceeași metodologie de Activation Steering pentru Siguranță Epistemică pe orice model open-weight. Aceasta ar putea standardiza conceptul de "Model Card pentru Siguranță Ideologică", similar cu cum FICO score-urile standardizează riscul de credit.
Într-o lume unde modelele devin infrastructură critică – de la sistemele de vot electronic la diagnostic medical –, capacitatea de a certifica că un model "nu minte prin omisiune sau cadruire" devine la fel de importantă ca performanța pe MMLU sau HumanEval. Arete-27B este prima dovadă concretă că acest certificat este tehnic posibil, economic viabil și etic necesar.
De ce este important:
Acest lanț de evenimente marchează maturizarea industriei AI din faza "cine are modelul mai mare" în faza "cine are modelul mai de încredere". Nous Research, un laborator născut din comunitate, fără miliarde de dolari de la venture capital, a rezolvat o problemă pe care giganții tehnologiei o evitaseră sau o mascaraseră prin cenzură. Arete-27B nu este doar un model nou; este un nou standard de onestitate intelectuală pentru mașini. Pentru dezvoltatori, înseamnă acces la putere fără compromis. Pentru utilizatori finali, înseamnă o AI care respectă inteligența lor suficient să nu le vândă o narativă. Și pentru societate, este o speranță că tehnologia puternică poate fi construită cu integritate, nu doar cu capacitate.