Pentru cei inițiați, un "backend Git" nu este doar un depozit de cod. Este motorul care gestionează stocarea, indexarea și negocierea obiectelor la fiecare `git push` sau `git fetch`. La scară mică, Git-ul standard (bazat pe formatul packfile și protocolul smart HTTP/SSH) funcționează perfect. Dar când ajungi la monorepo-uri de zeci de gigaocteți, cu mii de dezvoltatori care push-uiesc zilnic, arhitectura tradițională începe să crape sub propriul greutate: I/O-ul pe disc devine bottleneck-ul principal, negocierea obiectelor durează minute, iar latența devine un factor limitativ al productivității.
Arhitectura Pando: Re-gândirea fundamentală a stocării
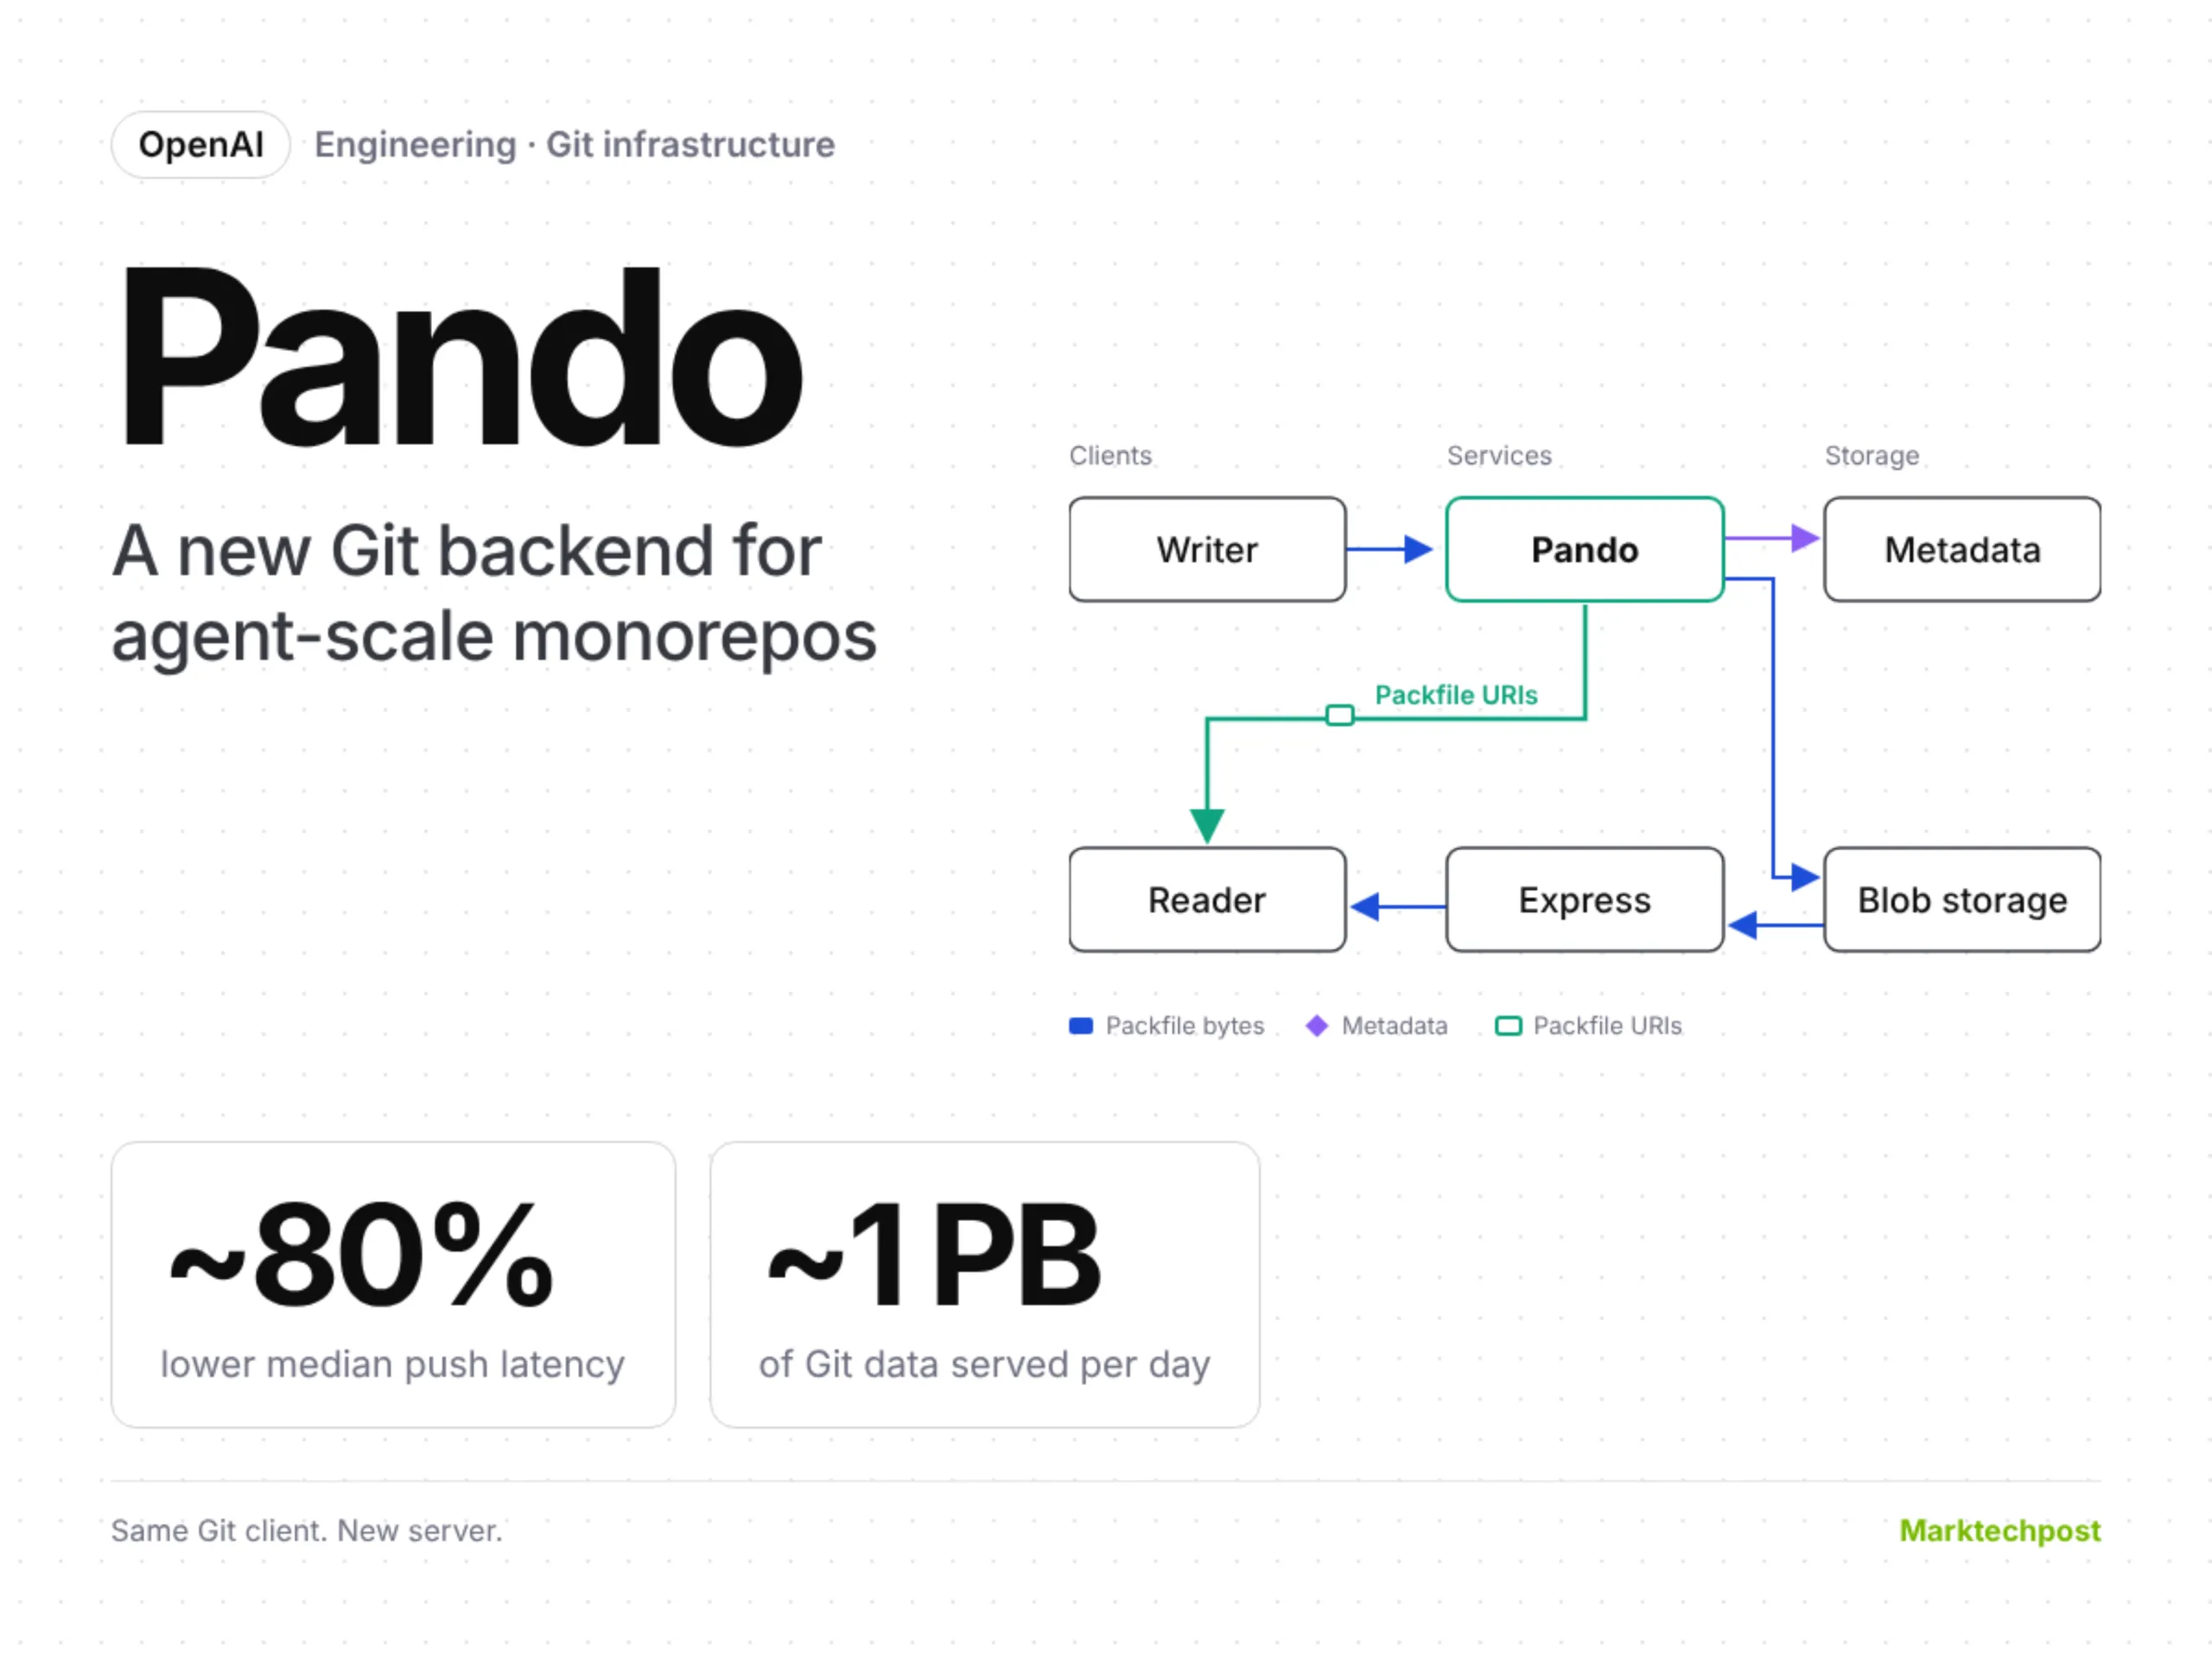
Pando nu este un simplu fork al Git-ului cu câteva patch-uri de performanță. Este o rescriere completă a stratului de stocare și transfer, inspirată din sistemele de fișiere distribuite și baze de date OLAP moderne. În loc să se bazeze pe packfile-uri monolitice care trebuie rescrise la fiecare batch de obiecte noi, Pando folosește o arhitectură Log-Structured Merge (LSM) Tree adaptată pentru obiecte Git, combinată cu un sistem de deduplicare la nivel de chunk bazat pe hash-uri content-addressable (la fel ca Git, dar la granularitate fină).
Aceasta înseamnă că când un dezvoltator face push la un commit care conține un fișier de 1 GB modificat doar în 10 MB, Pando nu stochează întregul fișier nou, nici nu reconstruiește un packfile uriaș. Împarte fișierul în chunk-uri de dimensiune variabilă (folosind algoritmi de tip Rabin fingerprinting), identifică chunk-urile neschimbate deja prezente în depozit, și stochează doar delta-urile reale. Rezultatul: scrieri dramatice mai mici pe disc, mai puțină presiune pe cache-ul de pagini al kernel-ului, și o latență de push care scalează logaritmic, nu liniar, cu dimensiunea depozitului.
Numerele care contează: Benchmark-uri reale
OpenAI a publicat date de benchmark rulate pe propriul monorepo intern (estimată la peste 50 GB, cu istoric de ani și sute de contribuitori activi). Rezultatele sunt eloachioase:
Dar cel mai important metric nu este viteza brută, ci predictibilitatea. În sistemele vechi, un push putea dura 10 secunde sau 3 minute în funcție de starea cache-ului, fragmentarea discurilor sau load-ul serverului. Pando elimină această variabilitate prin design: scrierile sunt append-only în segmente LSM, citirile sunt servite din memorie (block cache) sau SSD-uri NVMe cu pattern-uri de acces secvențial, iar compactarea (echivalentul `git gc`) se face incremental, în background, fără să blocheze scrierile.
Implicații pentru ecosistemul dezvoltării
Lansarea Pando ca open source (sub licență Apache 2.0, gazduită pe GitHub sub organizația OpenAI) nu este doar un gest de goodwill. Este un semnal clar că viitorul dezvoltării la scară masivă nu se află în VCS-uri proprietare (ca Perforce sau sapphire-ul intern de la Google), ci în evoluția Git-ului ca protocol și format de date, cu backend-uri specializate.
Pentru companii care luptă astăzi cu monorepo-uri uriașe — fie că vorbim de Uber, Airbnb, sau orice startup care a ajuns la stadiul "Git e prea lent" — Pando oferă o cale de migrare pragmatică. Nu trebuie să schimbi tooling-ul (IDE-uri, CI/CD, code review) pentru că protocolul Git (smart HTTP/SSH) rămâne identic. Schimbi doar serverul backend. OpenAI oferă deja un server de referință (`pando-server`) scris în Rust, care expune interfața standard `git-receive-pack` / `git-upload-pack`, compatibil cu orice client Git ≥ 2.30.
Există, desigur, provocări. Adopția inițială va necesita experțiță operațională: Pando folosește un cluster de stocare distribuit (bazat pe Raft pentru consensus al metadatelor) și un sistem de blob storage compatibil S3 (MinIO, AWS S3, GCS, Azure Blob) pentru datele efective. Nu este un singur binary pe un singur server. Dar pentru organizații care deja rulează Kubernetes și object storage, integrarea este naturală.
Perspective: Dincolo de Git
Ce face Pando fascinant nu este doar optimizarea Git-ului, ci arhitectura sa modulară. Stratul de deduplicare chunk-level și motorul LSM sunt agnostici față de formatul de date de sus. Nimic nu împiedică ca viitoare versiuni să ofere interfețe pentru LFS (Large File Storage) nativ, fără pointeri separate, sau chiar să devină backend pentru sisteme de build bazate pe conținut (content-addressable build caches ca Bazel/Remote Execution), unde deduplicarea chunk-urilor poate reduce dramatic transferul de artefacte între workere.
OpenAI a sugerat, în documentația de design, că Pando a fost conceput inițial pentru a gestiona seturile de date de antrenament și checkpoint-urile de modele — fișiere de zeci de GB care se schimbă incremental. Git-ul standard eșuează miserabil aici. Pando transformă acest caz de limită în caz de uz standard.
Concluzie: Un moment pivotal pentru infrastructura dezvoltării
Lansarea Pando nu este doar o optimizare tehnică; este o declarație de intenții. OpenAI, o companie definită de scalarea masivă a calculului și a datelor, aplică acum aceeași rigurozitate inginerescă tooling-ului zilnic al dezvoltatorilor. Reducerea latenței push-ului cu 80% nu înseamnă doar că inginerii așteaptă mai puțin. Înseamnă că ciclul de feedback se accelerează, că experimentarea devine mai ieftină, că costul oportunității a unui commit greșit scade.
Într-o industrie obsedată de "developer experience" (DX), adesea redus la interfețe ușoare sau copiloți AI, Pando ne amintește că DX-ul real începe la nivelul sistemului de fișiere și al protocolului de rețea. Dacă Pando va deveni standardul de facto pentru monorepo-uri la scară largă (și parierile mele sunt că va fi, în 2-3 ani), vom privi la arhitectura packfile-ului Git ca la o relictă a eroiului Linus — genială pentru 2005, dar inadecvată pentru 2025.
Gata să testezi? `git clone https://github.com/openai/pando` și citește `DESIGN.md`. Arhitectura merită studiată, chiar dacă nu migrezi mâine.
De ce este important:
Pando reprezintă cea mai semnificativă inovație în infrastructura Git din ultimul deceniu, adresând direct bottleneck-ul fundamental al scalării monorepo-urilor: latența și variabilitatea operațiunilor de scriere. Prin adoptarea unei arhitecturi LSM-tree cu deduplicare la nivel de chunk, OpenAI demonstrează că performanța la scară industrială nu vine din tweak-uri incrementale, ci din re-gândirea fundamentală a structurilor de date și a modelelor de acces la stocare. Pentru orice organizație care atinge limitele Git-ului standard, Pando oferă o cale de upgrade pragmatică, compatibilă înapoi, care poate debloca productivitatea zeci de sute de ingineri. Este, de asemenea, un studiu de caz exemplu de inginerie de sisteme distribuite: separarea clară a planului de control (metadate, consensus Raft) de planul de date (blob storage, LSM compaction), design pentru failure domains, și observabilitate integrată. Chiar dacă nu adopți Pando mâine, principiile sale arhitecturale vor influența următoarea generație de tooling pentru dezvoltare software.