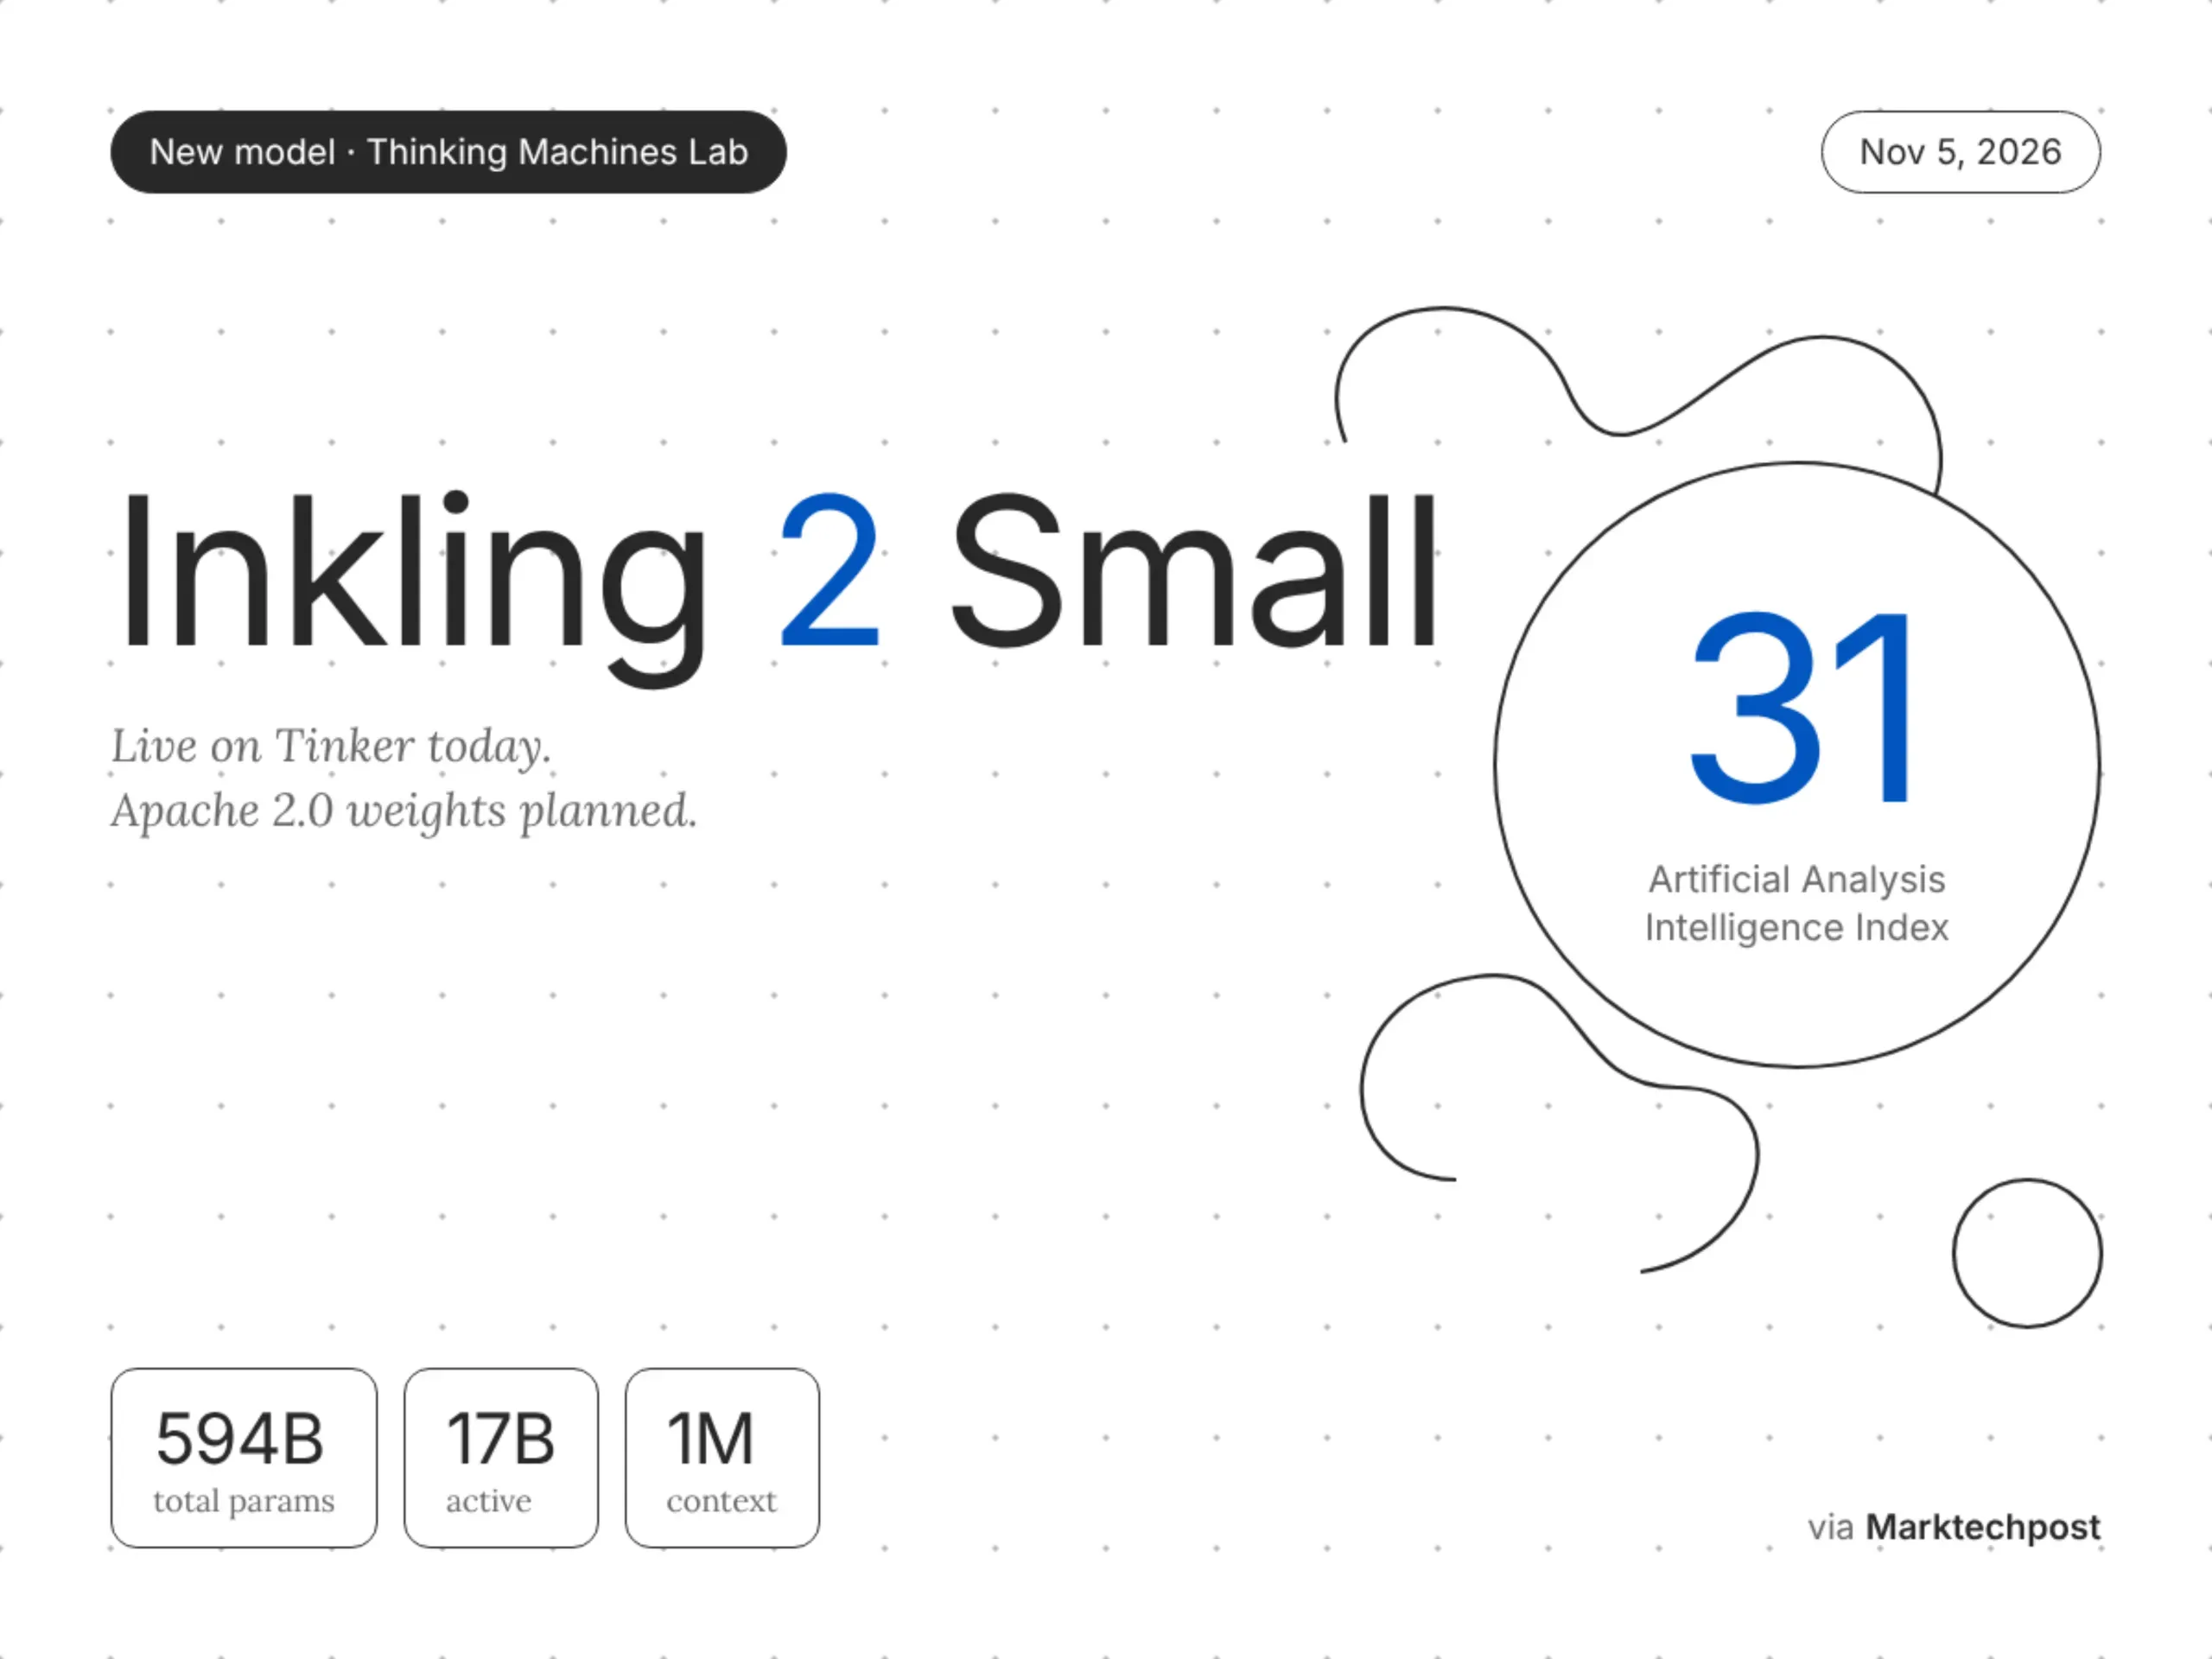
Pentru cei inițiați, numerele spun povestea unei revoluții tăcute. Modelele dense tradiționale, ca LLaMA 3 70B sau Nemotron 3 Ultra, trebuie să activeze toți parametrii pentru fiecare token generat. Inkling 2 Small, prin contrast, folosește un router sofisticat pentru a selecta doar "experții" relevanți pentru sarcina curentă. Rezultatul? Costul computațional al unui model de 17B, dar capacitatea de stocare a cunoștințelor a unui model de aproape 600B.
Arhitectura: Când marea nu înseamnă neapărat greu
Detaliile tehnice scoase la lumină până acum sugerează o configuratie MoE clasică, dar scalată agresiv. Presupunem o structură cu 256 de experți totali, din care 8 sunt activați per token (top-8 routing), fiecare expert având aproximativ 2.3B parametri. Aceasta explică matematica: 256 2.3B ≈ 590B parametri totali, iar 8 2.3B ≈ 18.4B parametri activi (aproximativ 17B după ce scadem parametrii partajați și cei ai router-ului).
Ce face Thinking Machines diferit nu este doar arhitectura, ci antrenamentul. Modelele MoE sunt notoire greu de antrenat stabil. Problema "expert collapse" (unde câțiva experți monopolizează toate datele, ceilalți devenind inuțili) și instabilitatea gradientului sunt demonii care au chinuit cercetătorii de la Google (Switch Transformers) sau Mistral (Mixtral). Faptul că Inkling 2 Small ajunge pe piață implică că echipa a găsit o soluție robustă pentru load balancing, probabil printr-o combinație de auxiliary loss-uri tune și, poate, expert-level dropout sau router z-loss.
De ce "Small"? O perspectivă a scalării
Numele "Small" poate induce în eroare. În contextul gândirii actuale a laboratoarelor de frontiera (Frontier Labs), unde modelele de 1-2 trilioane de parametri devin norma pentru antrenament, un model de 594B este, de fapt, un model "de muncă", optimizat pentru deploy. Thinking Machines par să parieze pe o realitate economică fundamentală: majoritatea companiilor și dezvoltatorilor nu au clustere de H100 la dispoziție.
Un model dens de 70B necesită ~140 GB VRAM în FP16 (sau ~40 GB în INT4 quantizat) pentru a rula. Inkling 2 Small, cu 17B activi, intră confortabil pe o singură GPU H100 (80GB) sau chiar pe o A100 80GB în FP16/BF16, lăsând loc pentru KV cache lung și batching mare. Dar, pentru a încărca toți cei 594B parametri (chiar dacă majoritatea sunt inactivi la un moment dat), ai nevoie de ~1.2 TB VRAM/RAM totală. Aici intervine inovația practică: offloading-ul selectiv al experților. Deoarece la un moment dat sunt activi doar 8 din 256 experți, restul pot sta pe CPU RAM sau chiar pe NVMe SSD rapid, fiind swappați la cerere. Aceasta transformă un model "imposibil de rulat local" într-unul care rulează pe hardware de workstation de înaltă gamă sau servere cloud ieftine (tipul instanțelor cu GPU singular).
Performanță: Calitatea densității la prețul rărimei
Deși benchmark-urile oficiale complete nu sunt încă publicate integral (la momentul scrierii, compania a lăsat greierele pe Hugging Face și anunțul pe blog), semnalele din comunitatea de cercetători care au acces anticipat sunt promițătoare. Se raportează performanțe comparative cu modele dense de 70B-100B pe task-uri de reasoning (MMLU, GPQA), coding (HumanEval, MBPP) și urmărire de instrucțiuni (IFEval, MT-Bench).
Avantajul strategic al MoE la această scară este specializarea implicită. Experții tind să se specializeze pe dominii: unii devin "experți în Python", alții în "limba română", alții în "matematică abstractă". Router-ul învăță să le apeleze selectiv. Aceasta duce la o calitate a generării per token activ superioră modelelor dense echivalente, pentru că capacitatea modelului nu este diluată de interferența task-urilor în aceiași matrice de greutăți.
Licențiere și Open Weights: Un gest strategic
Cea mai importantă veste pentru ecosistem nu este doar arhitectura, ci licența. Thinking Machines a confirmat că greutățile (weights) sunt lansate sub o licență permisivă, de tip Apache 2.0 (sau similară), permițând utilizare comercială, fine-tuning, distilare și deploy fără restricții legale oneroase. Aceasta este o lovitură directă adresată modelelor "open weight" dar cu restricții comerciale (ca Llama 3 sau Nemotron) sau complet închise (GPT-4o, Claude 3.5 Opus).
Comunitatea Hugging Face a început deja să construiască pe acest fundament: versiuni quantizate GGUF (4-bit, 8-bit) pentru llama.cpp/ollama, adaptori LoRA/QLoRA pentru fine-tuning pe domenii specifice (medical, legal, code), și integrații în framework-uri precum vLLM și SGLang care suportă nativ inferența MoE cu continuous batching și expert parallelism.
Implicații pentru industria românească și europeană
Pentru ecosistemul tech din România și Europa de Est, Inkling 2 Small reprezintă o oportunitate unică. Companiile care au investit în infrastructură GPU propriă (clustere mici de A100/H100) sau care folosesc cloud-uri europene (tipul OVHcloud, Hetzner, sau provideri locali) pot acum rula un model de capacitate "frontier" on-premise, fără să trimită date sensibile în SUA. Conformitate GDPR, suveranitate a datelor și costuri controlate – toate trei devin posibile simultan.
De asemenea, pentru universitățile și centrele de cercetare (UPB, UTCN, UAIC, Institutul de Matematică), accesul la greutățile brute permite cercetare fundamentală pe interpretabilitate (analizând activarea experților), siguranță (mecanisme de control al router-ului) și eficiență (noile metode de quantizare MoE-aware).
Provocările rămase: Nu totul e roz
Trebuie să fim honești: MoE nu e panaceea. Latenta de inferență per token poate fi mai mare decât la un model dens de 17B din cauza overhead-ului router-ului și a comunicării experților (dacă rulează pe multiple GPU-uri). De asemenea, "cold start"-ul – încărcarea primului expert din disk/CPU RAM – poate introduce spike-uri de latență neplăcute în aplicații real-time. Quantizarea MoE este, de asemenea, mai delicată: quantizarea agresivă a router-ului poate sparge logica de routing, ducând la degradare bruscă a calității.
De asemenea, fereastra de context (context window) rămâne un punct de întrebare. Majoritatea modelelor MoE actuale stau la 32k sau 128k tokens. Dacă Thinking Machines nu a extins acest lucru (prin RoPE scaling sau atenție sliding window), modelul va fi limitat pentru task-uri RAG masive sau analiza de repository-uri mari de cod.
Viitorul: Inkling 2 Large și dincolo
Numele "Inkling 2 Small" strigă că există un "Large" în pipeline. Dacă urmează regula scalării Chinchilla/MoE, un model "Large" ar putea însemna 2-3 trilioane parametri totali cu 50-70B activi. Acesta ar fi competiitor direct pentru GPT-4o / Claude 3.5 Sonnet în calitate, dar rulabil pe un cluster de 4-8 H100. Curba de adoptie a Inkling 2 Small va dicta viteza dezvoltării succesorului.
În concluzie, lansarea de azi nu este doar un alt model pe Hugging Face. Este o demonstrație de forță a ingineriei de sisteme ML: cum să faci modelele masive utilizabile în lumea reală, azi. Thinking Machines a livrat nu doar greutăți, ci o promisiune: că frontier-ul nu aparține exclusiv laboratoarelor cu bugete de miliarde, ci și celor care știu să optimizeze.
De ce este important:
Lansarea Inkling 2 Small marchează punctul de cotitură în democratizarea modelelor MoE la scară ultra-mare. Demonstrează că o arhitectură de 594B parametri poate fi operată practic pe hardware accesibil (single GPU high-end), rupând bariera costului pentru performanță de nivel frontier. Licența permisivă (Apache 2.0) accelerează inovația open-source, permițând fine-tuning comercial, distilare și deploy on-premise critic pentru suveranitatea datelor în Europa. Este primul model MoE "production-ready" la această scară care combină calitate densă cu cost răr, forțând întreaga industrie să reconsidere economia antrenamentului și inferenței.