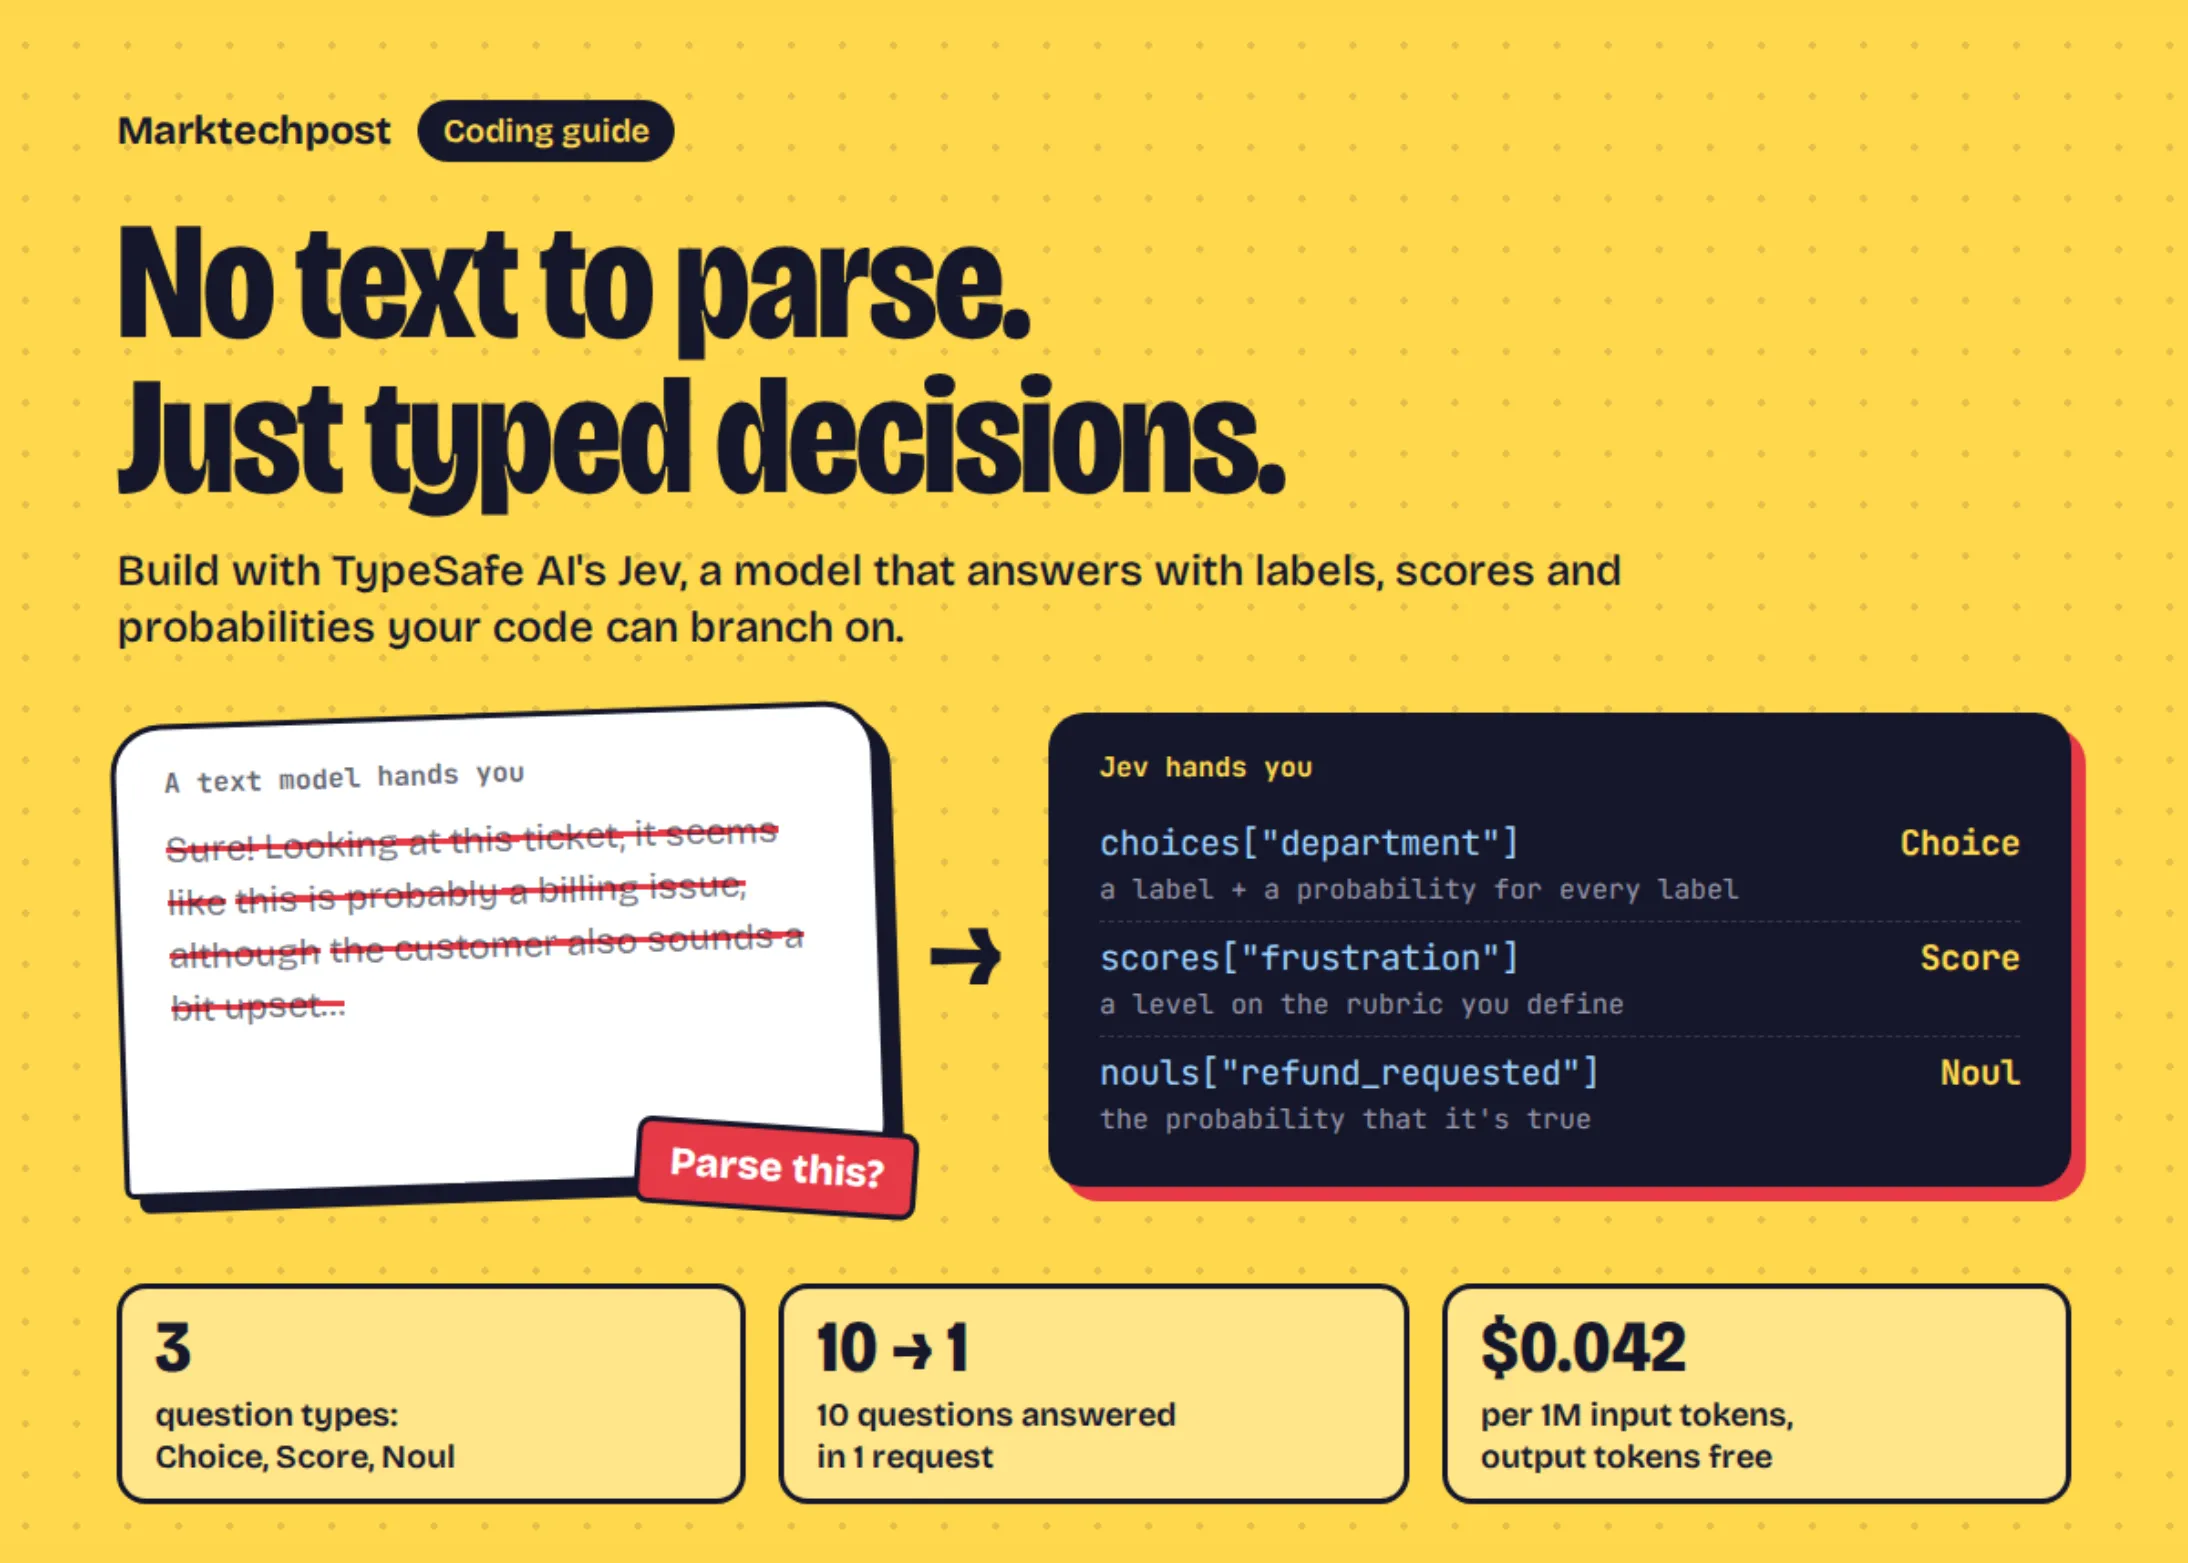
Hai să lămurim întâi ce înseamnă, pe românește, „TypeSafe AI”. În programare, un limbaj „type-safe” te obligă să declari ce fel de date circulă prin codul tău: un număr rămâne număr, un text rămâne text, iar dacă încerci să amesteci lucrurile, compilatorul te oprește înainte să produci o eroare în producție. Aplicat la AI, ideea devine fascinantă: în loc să lași un model să scoată text liber pe care apoi îl parsezi cu regex-uri fragile, îl obligi să răspundă într-o structură strictă, cu câmpuri bine definite. Fiecare decizie pe care o ia agentul devine un obiect tipizat, verificabil, testabil și — cel mai important — refuzabil atunci când nu respectă contractul.
De aici derivă primul pilon al acestui ghid: deciziile tipizate. În loc ca agentul să spună „cred că ar trebui să trimit un email clientului”, el returnează ceva de genul: tip acțiune = trimitere_email, destinatar = client, prioritate = ridicată, încredere = 0.87. Fiecare câmp are un tip clar, iar sistemul care primește răspunsul poate valida instantaneu dacă e ceva în neregulă. E o schimbare de mentalitate: nu mai tratezi modelul ca pe un oracol care vorbește în versuri, ci ca pe un funcționar care completează formulare. Pare restrictiv, dar tocmai această restricție îl face utilizabil în sisteme reale, unde o eroare de parsare poate însemna un client supărat sau un proces de facturare blocat.
Al doilea pilon, poate cel mai subtil, este încrederea calibrată. Aici e o capcană pe care mulți o ratează: modelele lingvistice sunt notoriu de încrezătoare în ele însele, chiar și când halucinează. Îți spun „sigur, răspunsul este 42” cu aceeași voce cu care îți spun „nu știu”. Încrederea calibrată înseamnă că sistemul învață să-și asocieze un scor de probabilitate care să reflecte realitatea statistică: dacă spune „am 90% încredere”, atunci în aproximativ 90% din cazuri ar trebui să aibă dreptate. Sună simplu, dar e greu de obținut. Se face prin antrenare pe seturi de date unde răspunsurile corecte și greșite sunt etichetate, prin tehnici de temperatură, prin modele auxiliare care estimează incertitudinea sau prin agregarea mai multor rulări. Rezultatul? Un agent care știe când să tacă, când să ceară ajutorul unui om și când să meargă înainte cu încredere.
Al treilea pilon ne duce într-un teritoriu și mai interesant: execuția speculativă paralelă, sau „speculative fan-out”. Imaginează-ți că agentul tău trebuie să răspundă la o întrebare complexă. În loc să aleagă o singură cale și să o urmeze până la capăt, el lansează simultan mai multe ramuri de raționament — ca un jucător de șah care analizează mai multe variante deodată. Fiecare ramură produce o decizie tipizată, cu propriul scor de încredere. Apoi un mecanism de agregare alege varianta câștigătoare, ținând cont de coerență, de cost și de încrederea calibrată. E o strategie costisitoare din punct de vedere computațional, dar extrem de puternică atunci când acuratețea contează mai mult decât viteza. Și, pentru că fiecare ramură e tipizată, poți compara merele cu mere, nu poezie cu poezie.
Acum, partea care leagă totul: modelul „System One”. Termenul vine din psihologia cognitivă a lui Daniel Kahneman, care descria două moduri de gândire — Sistemul 1, rapid, intuitiv, automat, și Sistemul 2, lent, deliberativ, analitic. În arhitecturile AI moderne, un model „System One” este un model mic, rapid, specializat pe decizii instantanee: clasifică, etichetează, filtrează, prioritizează. Nu încearcă să scrie eseuri filozofice. Rolul lui e să facă triajul rapid al situației, iar apoi, dacă e nevoie, să delege către un model mai mare, mai lent, mai scump. Combinația e letală: System One face fan-out-ul speculativ ieftin, iar System Two validează și rafinează.
De ce contează toate acestea pentru cineva care nu scrie cod? Pentru că ele schimbă felul în care vor arăta produsele AI din următorii ani. În loc de chatboți care inventează răspunsuri cu o încredere orbitoare, vom avea agenți care știu exact ce știu, care își declară incertitudinea, care își structurează deciziile într-un mod auditabil și care pot fi opriți automat atunci când ies din parametri. Pentru companii, asta înseamnă mai puține incidente, mai puține halucinații ajunse la client și mai multă încredere în automatizare. Pentru utilizatori, înseamnă sisteme care nu te mai mint cu zâmbetul pe buze.
Desigur, nu e totul roz. TypeSafe AI vine cu propriile provocări. Definirea tipurilor e muncă de inginerie serioasă, iar fiecare tip nou înseamnă cod de validare, teste și mentenanță. Încrederea calibrată e greu de măsurat corect, mai ales în domenii unde adevărul e subiectiv sau se schimbă în timp. Iar execuția speculativă paralelă poate exploda costurile dacă nu e gestionată cu cap. Nu în ultimul rând, există riscul ca echipele să se îndrăgostească de arhitectură și să uite de utilizator — o capcană veche de când lumea în inginerie.
Cu toate acestea, direcția e clară. Industria se mișcă de la „hai să vedem ce iese din model” la „hai să construim sisteme care nu pot ieși din anumite limite”. E o maturizare firească, la fel cum programarea a trecut de la cod scris pe genunchi la tipuri stricte, teste automate și integrare continuă. TypeSafe AI, cu deciziile tipizate, încrederea calibrată, fan-out-ul speculativ și modelul System One, nu e o modă trecătoare. E scheletul pe care se vor construi agenții de încredere din următorul deceniu. Iar cine înțelege asta acum are un avantaj serios în fața celor care încă se roagă ca modelul să nu halucineze.
De ce este important:
Pentru că trecem, fără să ne dăm seama, de la o eră în care AI-ul era o curiozitate fascinantă la una în care AI-ul ia decizii reale în spitale, bănci, fabrici și administrații. Într-o astfel de lume, „sperăm că modelul se comportă bine” nu mai e o strategie acceptabilă. TypeSafe AI oferă o soluție concretă: decizii structurate, verificabile, cu încredere măsurată și cu posibilitatea de a opri automat comportamentul nedorit. Este diferența dintre un asistent simpatic care inventează și un coleg de încredere care știe când să spună „nu sunt sigur, întreabă un om”. Iar această diferență, în multe industrii, valorează mai mult decât orice benchmark de performanță.