
Pentru cei inițiați, "atenția" este motorul care face ca transformatorii să funcționeze. Este mecanismul care permite modelului să "privească" înapoi prin secvența de intrare și să decidă ce token-uri sunt relevante unele pentru altele. Problema? Atenția standard (self-attention) scalează cvadratic (O(N²)) cu lungimea secvenței. Dublezi contextul, quadruplezi costul de calcul și memoria. Aceasta a fost "taxa" pe care am plătit-o toți pentru capabilitățile de raționament a modelelor GPT, Llama sau Gemini.
Anii trecuți au fost plini de încercări de a evita această taxă: FlashAttention (optimizări de IO-aware pe GPU), atenția rară (sparse), liniară (linear/recurrent), sau modele de tip state-space (Mamba, RWKV). Fiecare a adus câștiguri, dar și compromisuri: pierderea calității de modelare a dependențelor la distanță lungă, instabilitatea la antrenament sau dificultatea de a folosi infrastructura hardware existentă optimizată pentru matrici dense.
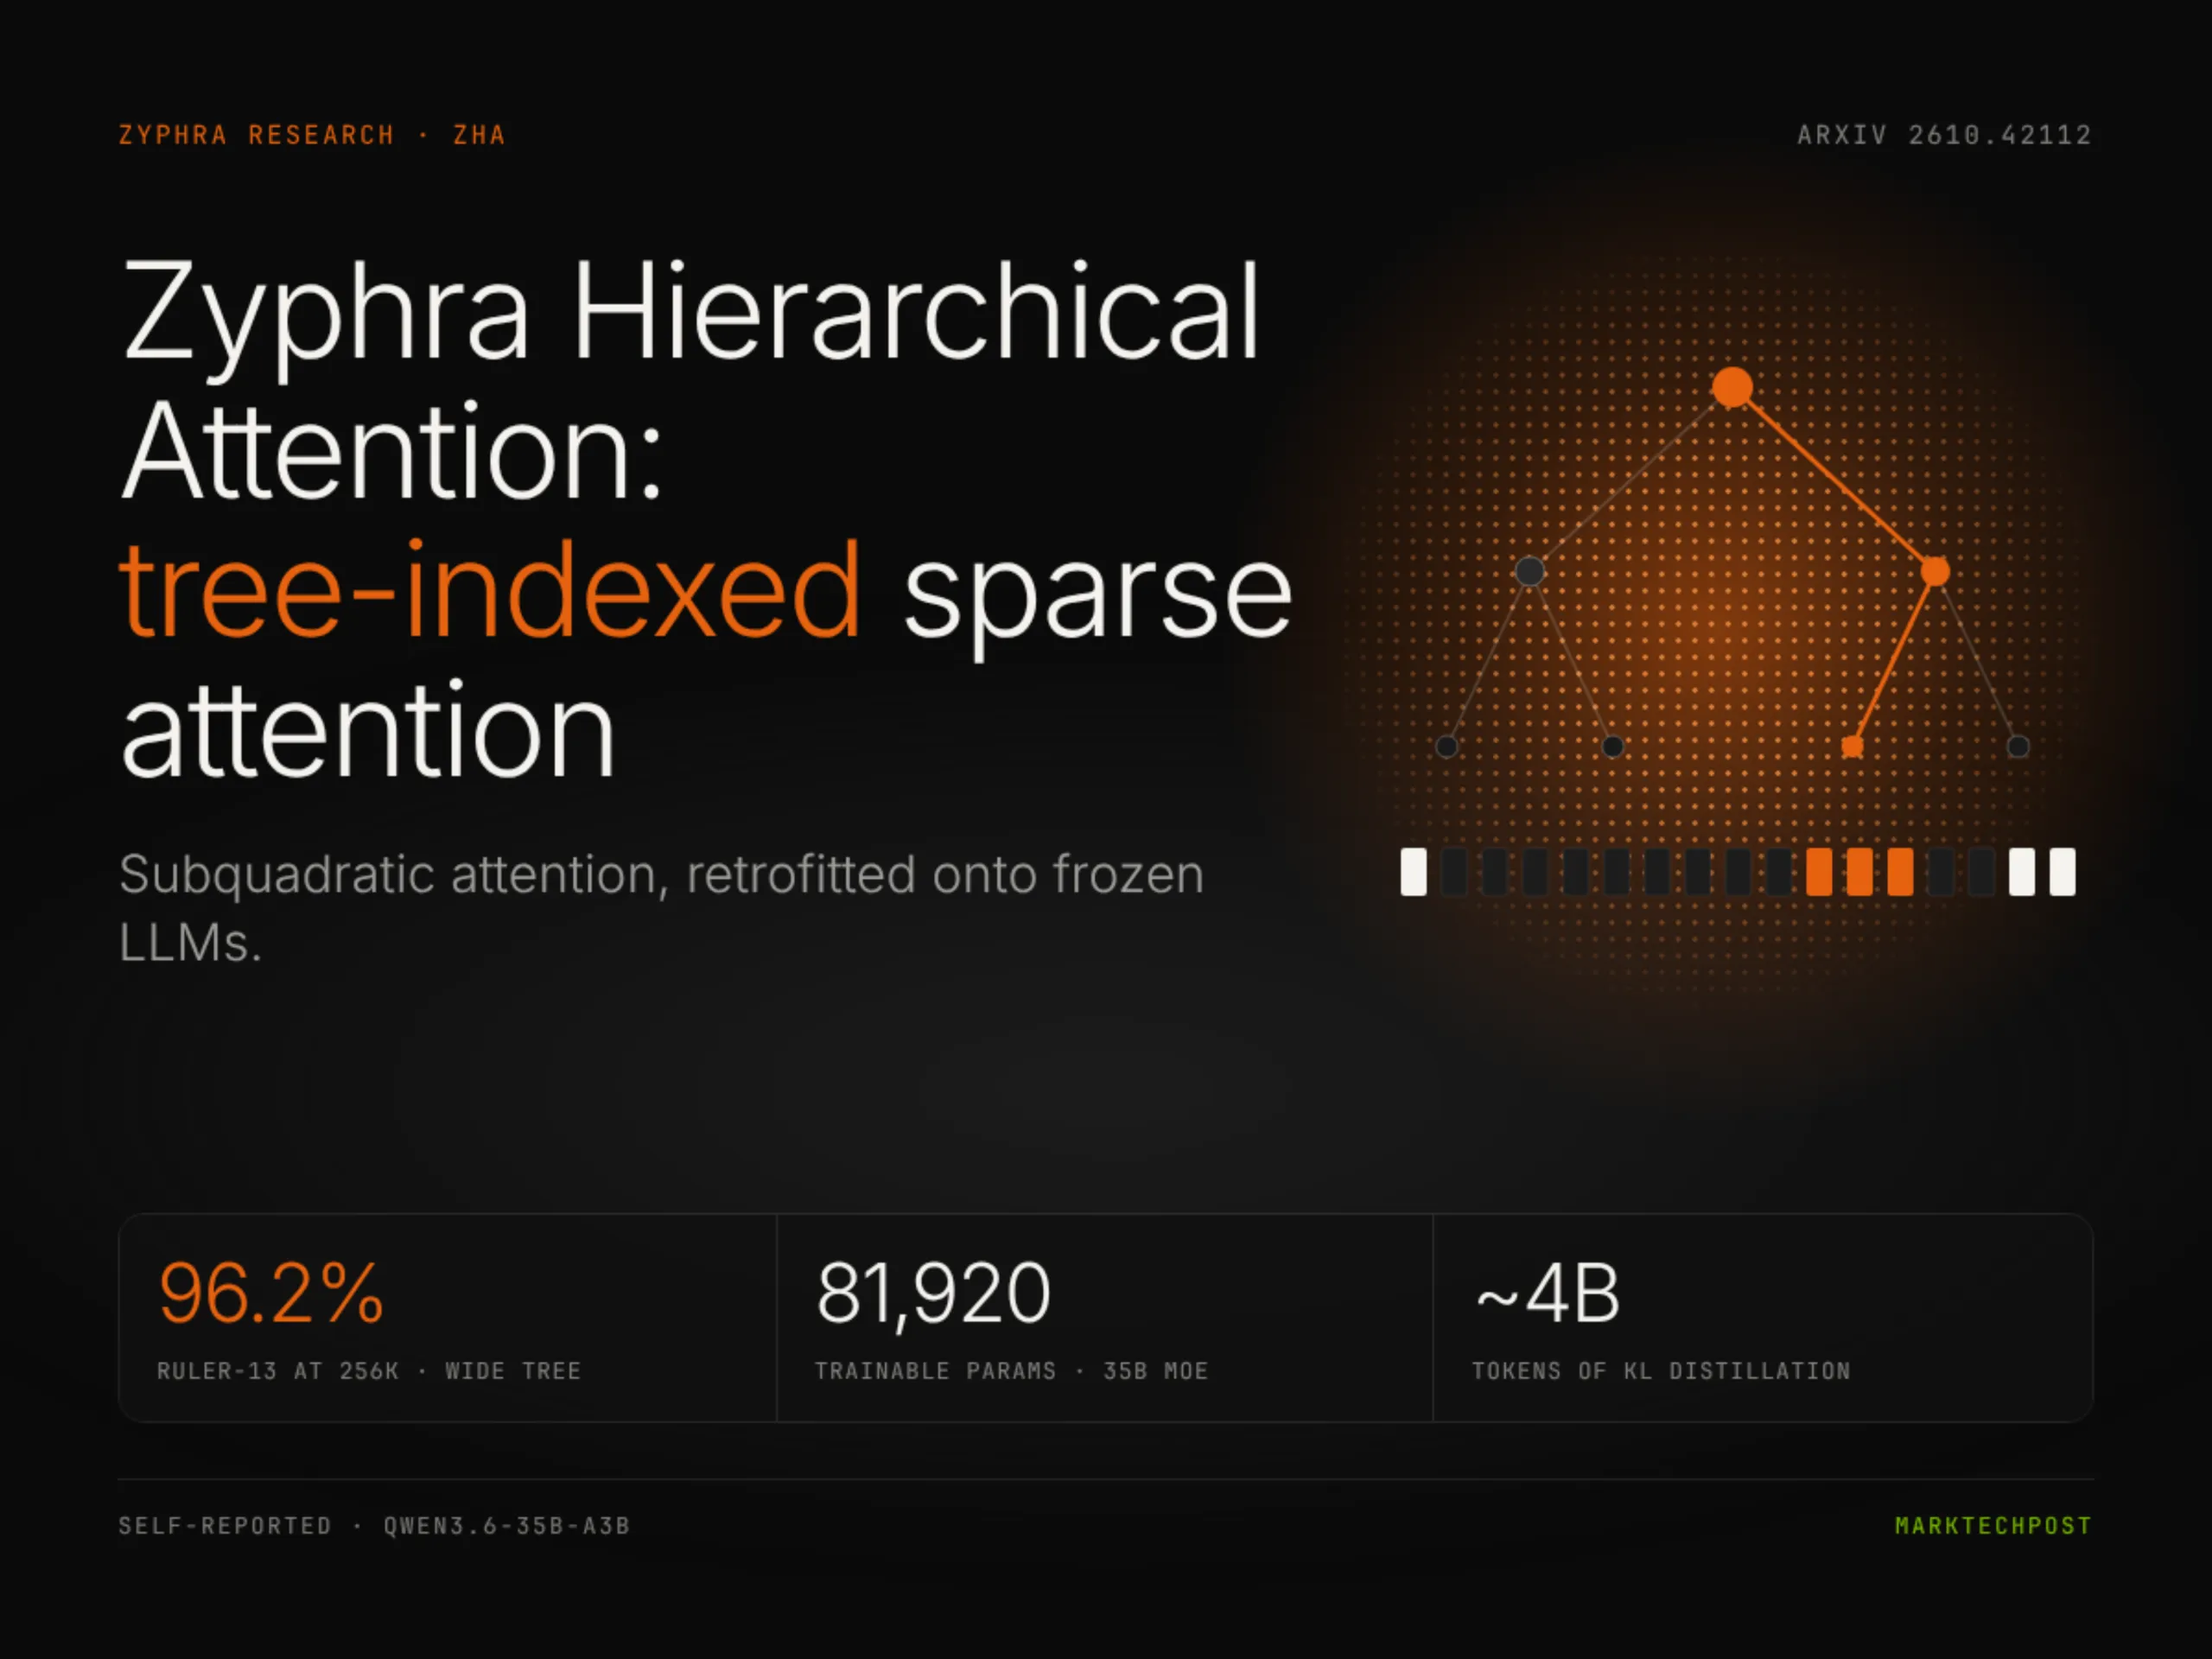
ZHA nu încearcă să înlocuiască atenția cu o recurență simplificată. În schimb, ierarhizează-o. Gândiți-vă la cum procesează informația creierul uman: nu comparăm fiecare pixel cu fiecare alt pixel în câmpul vizual. Procesăm caracteristici locale (muchii, texturi) în zone mici, apoi integram aceste rezumate la niveluri superioare (forme, obiecte), și în final la o scenă globală. ZHA face exact asta, dar matematic rigoros și derivabil end-to-end.
Arhitectura împarte secvența de intrare în blocuri locale. În interiorul fiecărui bloc, se aplică o atenție completă, densă, capturând nuanțele fine ale interacțiunilor locale (de exemplu, relația sintactică între cuvintele dintr-o propoziție). Apoi, o a doua fază de atenție operează pe reprezentările comprimate (sumarizate) ale acestor blocuri, permițând informației să curgă globală prin întreg contextul. Rezultatul? O complexitate care scalează aproape liniar cu lungimea secvenței – de aici termenul "subcvadratic" – păstrând în același timp capacitatea de a modela dependențe globale precise, lucru în care modelele liniare pure (precum Mamba) au adesea dificultăți.
Ce face ZHA diferit de alte abordări ierarhice (precum Longformer sau BigBird) este granulația și modul de integrare. Nu este o atenție rară cu pattern-uri fixe (sliding window + global tokens), ci o ierarhie învățată, adaptivă. Parametrii care decid cum se aggregate informația locală în context global sunt antrenați împreună cu restul modelului. Aceasta înseamnă că modelul învață ce este important să transmită la nivelul superior, nu este forțat de o euristică codată hard.
Din perspectiva ingineriei, Zyphra a făcut o mișcare strategică briliantă: ZHA este conceput să fie "hardware-aware" de la început. Implementarea referință vine cu kerneli CUDA optimizați care folosesc Tensor Cores pe GPU-uri Hopper (H100) și Blackwell (B200), minimizând accesul la memoria globală (HBM) prin tiling inteligent la ambele niveluri ale ierarhiei. În benchmark-urile interne, ZHA atinge o utilizare a MFU (Model FLOPs Utilization) de peste 55-60% pe contexte de 128k-256k tokeni, unde FlashAttention-2 pe același hardware cade sub 20% din cauza presiunii de memorie KV-cache. Practic, ZHA permite antrenamentul pe contexte masive pe clustere mai mici, democratizând accesul la modele cu context lung.
Dar de ce este important acum? Pentru că ne apropie de eră a "contextului infinit". Aplicatiile practice sunt imediate: analiza de bază de cod a întreaga repo-uri (milione de linii) într-un singur prompt, procesarea de documente legale sau medicale întregi fără RAG (Retrieval-Augmented Generation) pierzător, sau agenți care își mențin memoria de conversație pe luni, nu pe minute. RAG-ul nu dispare, dar devine un instrument pentru cunoștințe externe statice, nu o mule pentru fereastra de context a modelului.
Zyphra a indicat, de asemenea, că ZHA deschide ușa către o nouă generație de modele "hibride" la nivel de arhitectură. Deoarece blocurile locale sunt independente până la nivelul global, ele pot fi distribuite pe dispozitive diferite (model parallelism) mult mai eficient decât atenția standard, care necesită comunicare all-to-all masivă. Aceasta aliniază ZHA perfect cu tendința actuală a antrenamentului pe clustere geo-distribuite sau pe hardware heterogen.
Există, desigur, întrebări deschise. Cum se comportă ZHA la inference cu KV-cache? Ierarhia implică stocarea stărilor comprimate la nivel global, ceea ce ar trebui să reduce drastic memoria KV-cache, dar mecanismul exact de actualizare a ierarhiei la generarea token-cu-token (decoding) este un detaliu de implementare critic pentru latența de servire. De asemenea, stabilitatea antrenamentului la scară mare (trilioane de tokeni) rămâne de demonstrat public, deși rezultatele preliminare pe modele de 1B și 7B parametri sunt promițătoare, arătând curbă de pierdere (loss curves) indistinguibile de atenția completă, dar cu o viteză de antrenament de 3-5x mai mare pe contexte lungi.
Comunitatea open-source a reacționat cu entuziasm amestecat cu scepticismul sănătos specific cercetătorilor. Codul este disponibil sub o licență permițătoare (Apache 2.0), iar Zyphra a promis modele de bază (base models) antrenate cu ZHA în curând. Dacă acele modele vor egala sau depăși performanțele modelelor dense la benchmark-uri standard (MMLU, GSM8K, HumanEval) și vor demonstra capacități superioare pe task-uri de context lung (Needle-in-a-Haystack, RULER, LongBench), ZHA va deveni standardul de facto pentru noua generație de LLM-uri.
În concluzie, Zyphra Hierarchical Attention nu este doar un alt "truc de optimizare". Este o re-gândire fundamentală a fluxului de informație în transformatori, una care respectă constrângerile hardware-ului modern (ierarhia memoriei, lățimea de bandă, compute density) fără a sacrifica expresivitatea matematică a atenției. Dacă transformatorul a fost motorul de aviație a IA-ului, ZHA este trecerea la turborreactor: același principiu de bază (Newton/atenție), dar o arhitectură care scălează la altitudini și viteze inaccesibile anterior. Următorii 12 luni vor decide dacă Zyphra devine numele asociat cu această eră, dar direcția este clară: viitorul este ierarhic, subcvadratic și, sperăm, mult mai accesibil.
De ce este important:
ZHA reprezintă cea mai credibilă cale până acum spre eliminarea "taxei cvadratice" a transformatorilor. Rezolvă trilema fundamentală: Calitate (atenție densă) + Scalabilitate (context lung) + Eficiență (Hardware-aware). Pentru industrie, înseamnă modele mai ieftine de antrenat, mai rapide de servit și capabile să raționeze peste volume masive de date (cod, video, ADN, istoric conversații) fără soluții de tip "band-aid" precum RAG-ul forțat. Este o schimbare de paradigă la nivel de infrastructură software a IA-ului.