Subiect: #Optimizare
Cum să folosești Rebalancer-ul Meta: Ghid complet pentru plasarea sarcinilor și optimizare
Rebalancer, instrumentul open-source de la Meta, promite să rezolve una dintre cele mai dureroase probleme din antrenamentul distribuit: utilizarea ineficientă a resurselor GPU. Acest ghid explică ce este, cum se instalează și ce strategii de optimizare poți folosi pentru a-ți echilibra workload-ul pe clustere eterogene.
Meta a deschis codul pentru Rebalancer: soluția C++ care rezolvă 40 de milioane de probleme de plasare pe zi
Meta a deschis codul sursă pentru Rebalancer, un solver C++ care rezolvă aproximativ 40 de milioane de probleme de plasare pe zi. Instrumentul, folosit intern pentru optimizarea centrelor de date și a resurselor AI, promite să schimbe modul în care industria gândește optimizarea sistemelor distribuite la scară uriașă.
AutoScheduler lansează un constructor de aplicații pentru depozite, gândit pentru echipele de logistică
AutoScheduler lansează un constructor de aplicații pentru depozite care le permite echipelor de logistică să-și creeze singure unelte software pornind de la date live din hală. Construit pe un strat semantic de șase ani și pe solveri matematici validați în aproape 100 de situri, instrumentul promite să elimine decalajul dintre problema văzută pe teren și soluția digitală.
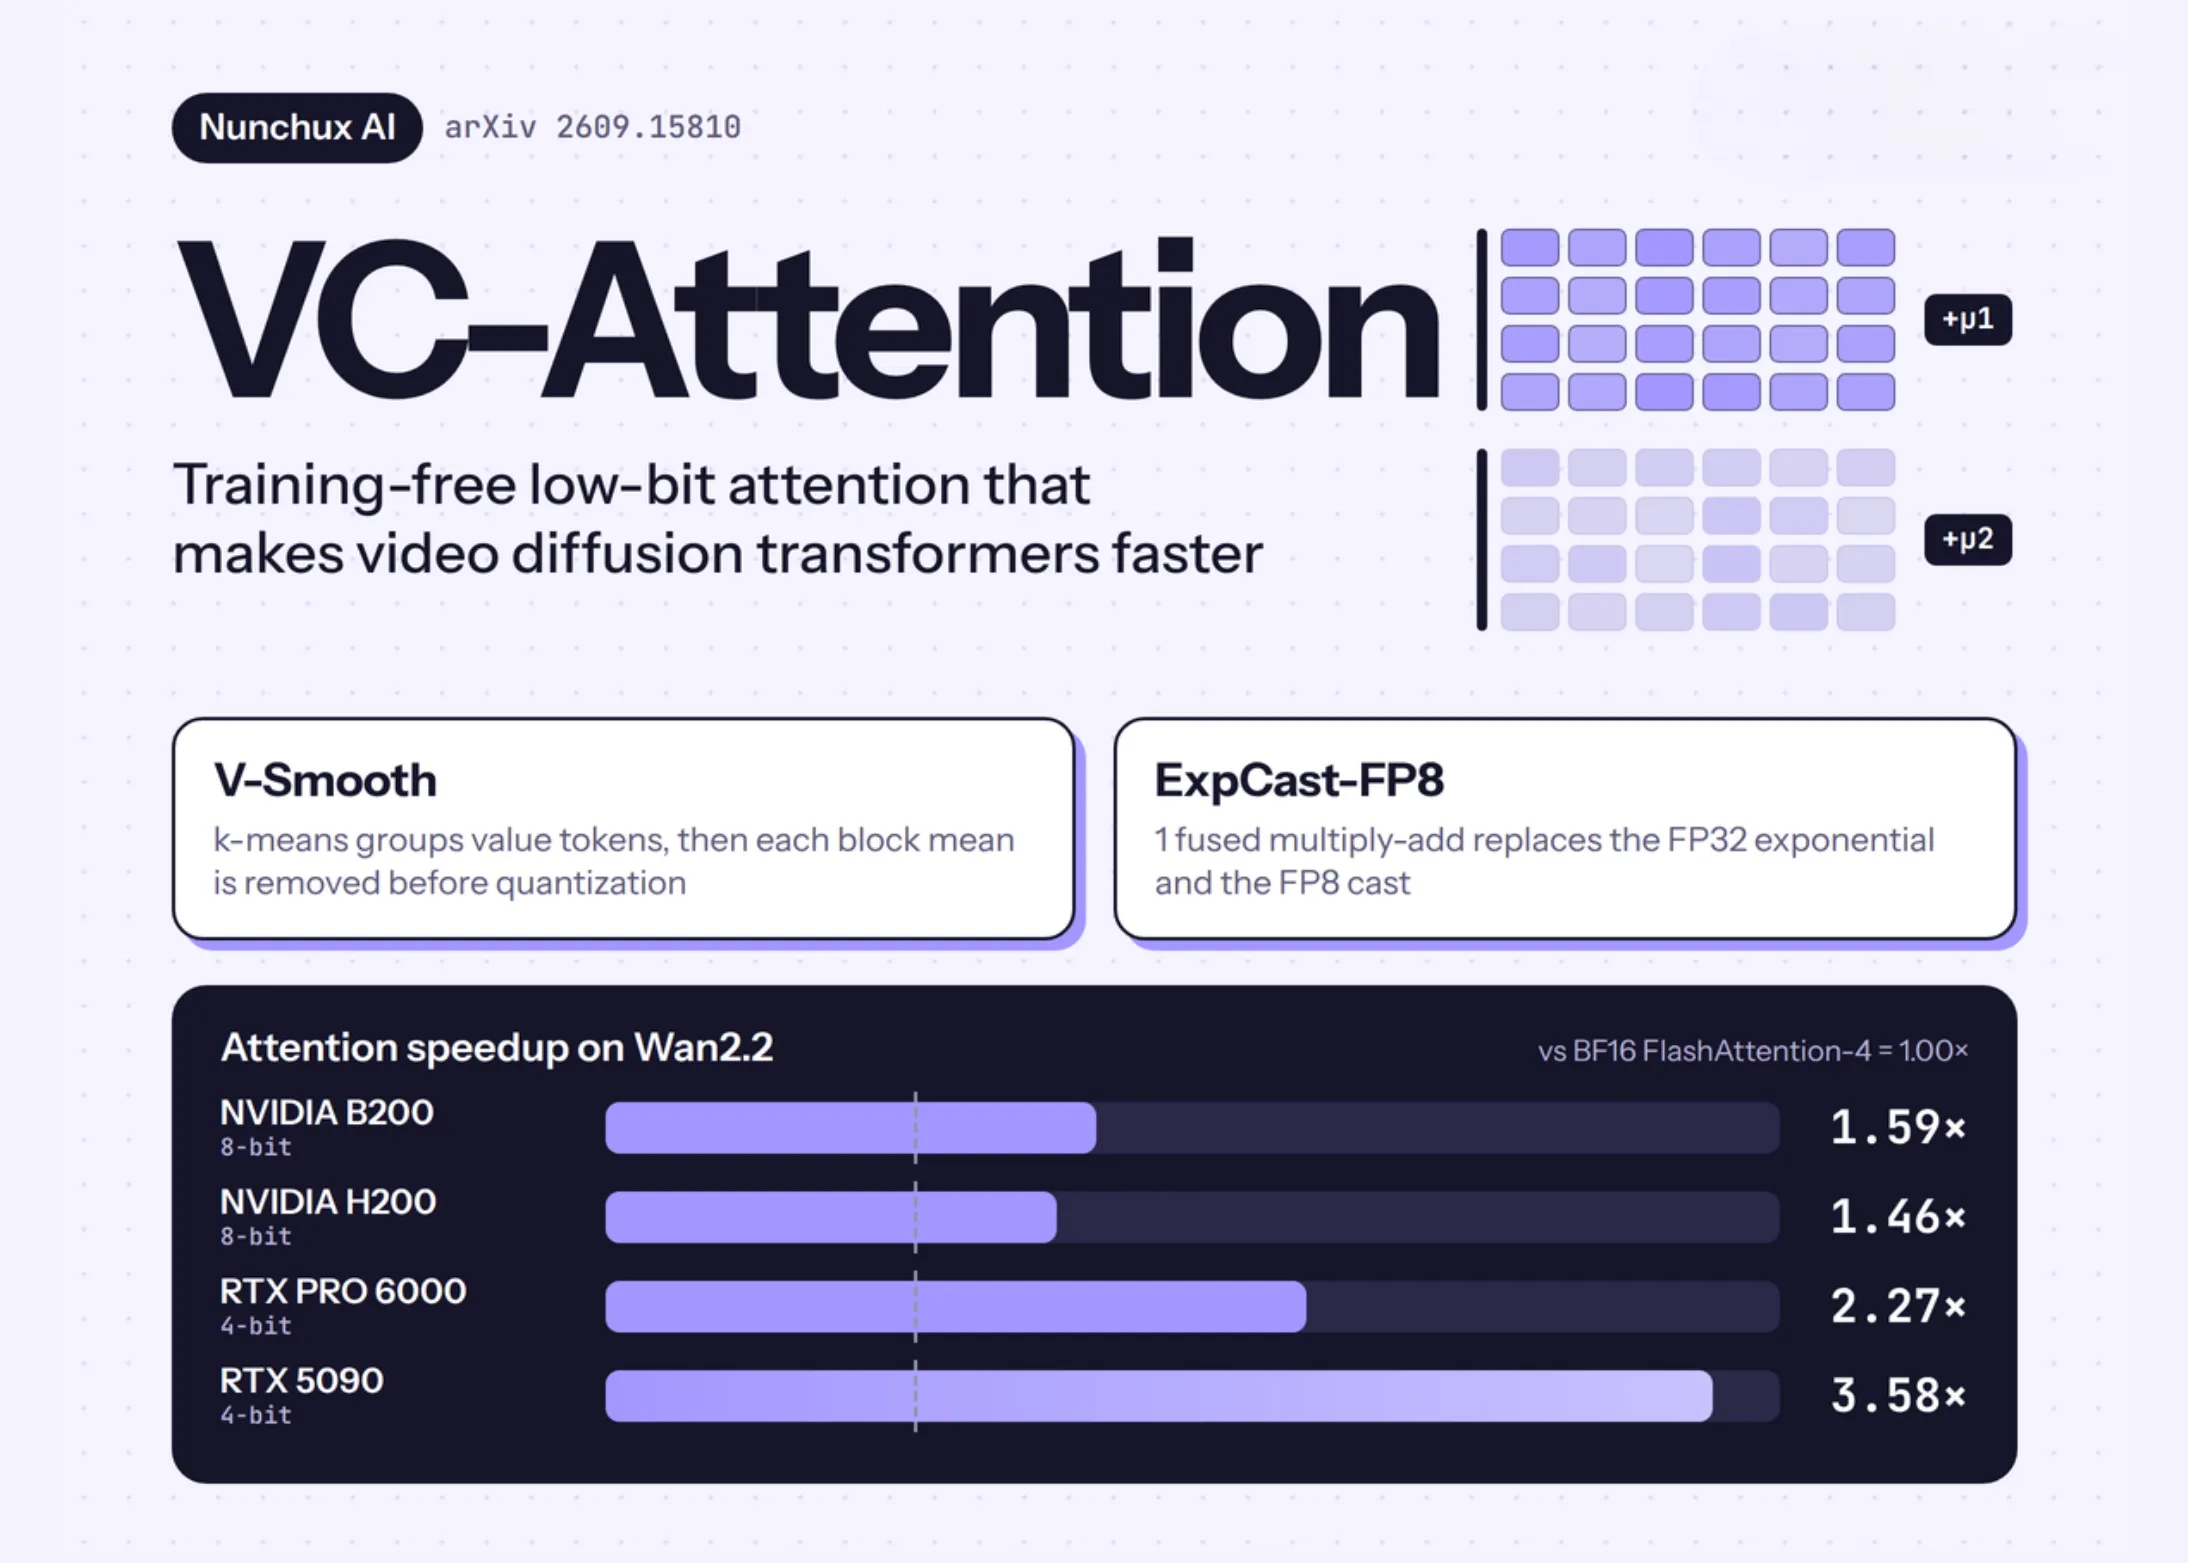
Nunchux AI lansează VC-Attention: kernel-ul de atenție low-bit care accelerează difuzia video fără antrenament
Nunchux AI a lansat VC-Attention, un kernel de atenție low-bit fără antrenament care accelerează semnificativ modelele de difuzie video bazate pe transformatoare. Prin cuantizare inteligentă și vectorizare, acesta reduce costurile de calcul și consumul de memorie, menținând calitatea vizuală. Open-source și ușor de integrat, VC-Attention democratizează generarea video AI.
Microsoft SkillOpt: Transferul optimizat al abilităților agenților AI între modele și platforme
Microsoft SkillOpt demonstrează că abilitățile agenților AI pot fi transferate optimizat între modele (Codex → Claude Code) și medii noi, cu performanțe remarcabile pe sarcini structurate, dar limitate pe cele de raționament abstract.
Ghid practic pentru programarea GPU pe bază de tile-uri: de la cuTile și Triton la Flash Attention
Un ghid practic pentru programarea GPU pe bază de tile-uri folosind cuTile, Triton și Flash Attention, cu exemple de kernel-uri și verificare în PyTorch. Învață cum să optimizezi operații precum adunarea vectorială, GELU, softmax, înmulțirea matricelor și atenția eficientă.
Liquid AI lansează Antidoom: o metodă open-source care reduce buclele de doom în modelele de raționament
Liquid AI a lansat Antidoom, o metodă open-source care reduce drastic buclele de doom în modelele de raționament, folosind Final Token Preference Optimization (FTPO) pentru a reantrena doar tokenul care declanșează bucla. Rezultatele arată scăderi de la 22,9% la 1% pe anumite modele.
Pot companiile tech să învețe să iubească modelele AI mai ieftine?
Industria AI se confruntă cu o posibilă schimbare majoră: trecerea de la modele mari și costisitoare la modele mai mici și mai ieftine, care ar putea gestiona 80% din sarcini fără pierderi de calitate. Aceasta ar putea reduce drastic costurile și ar putea redefini economia sectorului.
Xiaomi MiMo și TileRT: Un model cu 1 trilion de parametri depășește 1000 de tokeni pe secundă pe GPU-uri comerciale
Xiaomi și TileRT au dezvoltat o soluție care permite unui model AI cu 1 trilion de parametri să ruleze la peste 1000 de tokeni pe secundă pe GPU-uri comerciale, democratizând accesul la inteligența artificială avansată.
NVIDIA revoluționează distilarea cunoștințelor: X-Token, noul standard care depășește GOLD cu +3.82 puncte pe Llama-3.2-1B
NVIDIA lansează X-Token, o tehnică avansată de distilare a cunoștințelor care depășește metoda GOLD cu +3.82 puncte pe modelul Llama-3.2-1B. Articolul explică mecanismul de proiecție ghidată și cross-tokenizer, rezultatele obținute și impactul asupra dezvoltării modelelor AI compacte și eficiente.
EAGLE 3.1: Algoritmul de decodare speculativă care repară deriva atenției în inferența modelelor de limbaj
EAGLE 3.1 este un algoritm de decodare speculativă care corectează deriva atenției în inferența modelelor de limbaj, reducând latența cu până la 60% și menținând calitatea textului generat.
Părtinirea de frecvență a Gradientului Descendent Stocastic (SGD) și cum o rezolvă Adam
Gradientul Descendent Stocastic (SGD) are o părtinire de frecvență care favorizează tiparele rare în detrimentul celor frecvente. Optimizatorul Adam corectează această problemă prin adaptarea ratei de învățare per-parametru, normalizând gradienții în funcție de varianță. Articolul explică mecanismul și importanța sa practică.