Subiect: #Reinforcement Learning
Kimina-Prover-RL: O nouă eră în demonstrarea automată a teoremelor prin învățare prin întărire
Echipa Kimina lansează kimina-prover-rl, un pipeline open-source de învățare prin întărire pentru demonstrarea teoremelor în Lean 4, care utilizează un paradigmă de raționament structurat și un mecanism inovator de corecție a erorilor, obținând performanțe de top pentru modelele de dimensiuni mici.
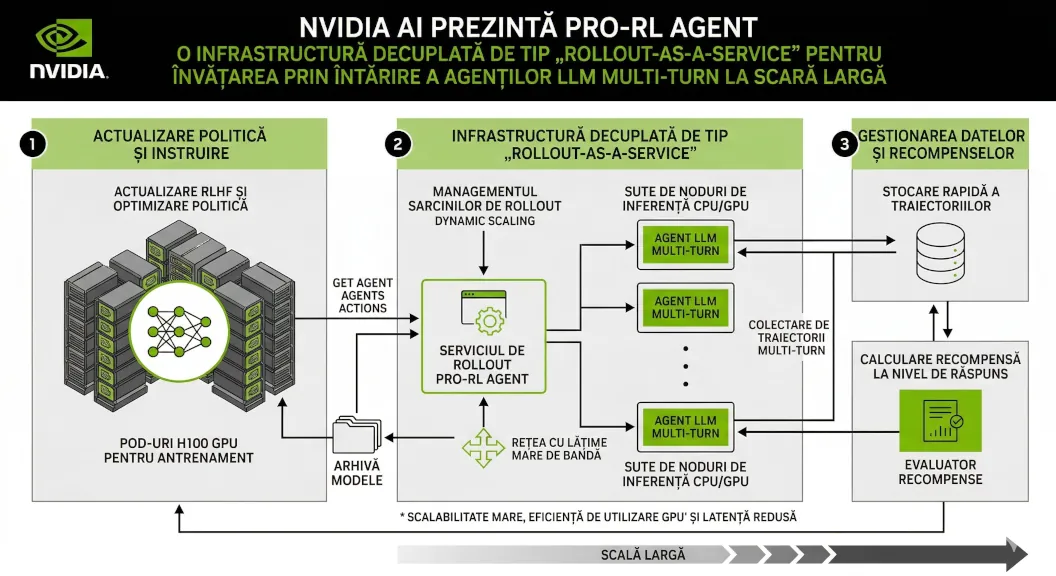
NVIDIA AI prezintă ProRL Agent: O infrastructură decuplată de tip „Rollout-as-a-Service” pentru învățarea prin întărire a agenților LLM multi-turn la scară largă
Cercetătorii de la NVIDIA au lansat ProRL Agent, o infrastructură scalabilă care revoluționează antrenarea agenților LLM prin decuplarea procesului de colectare a experiențelor (rollout) de bucla de antrenament, rezolvând astfel conflictele majore de resurse care îngreunează dezvoltarea AI-ului la scară largă.
Familia Palmyra-mini: Modele puternice, ușoare și pregătite pentru raționament complex
Familia Palmyra-mini redefinesc standardele modelelor de limbaj ușoare, combinând eficiența computațională cu capacități avansate de raționament. Descoperă noile modele „thinking”, antrenate cu Chain of Thought, care obțin scoruri remarcabile pe benchmark-uri precum GSM8K și AMC23.
Construirea Ecosistemului Open Agent Împreună: Prezentarea OpenEnv
Meta-PyTorch și Hugging Face lansează OpenEnv, un standard deschis pentru medii agențiale care redefinesc antrenamentul și implementarea AI. Acest ecosistem oferă siguranță, scalabilitate și un cadru standardizat pentru dezvoltarea agenților autonomi.
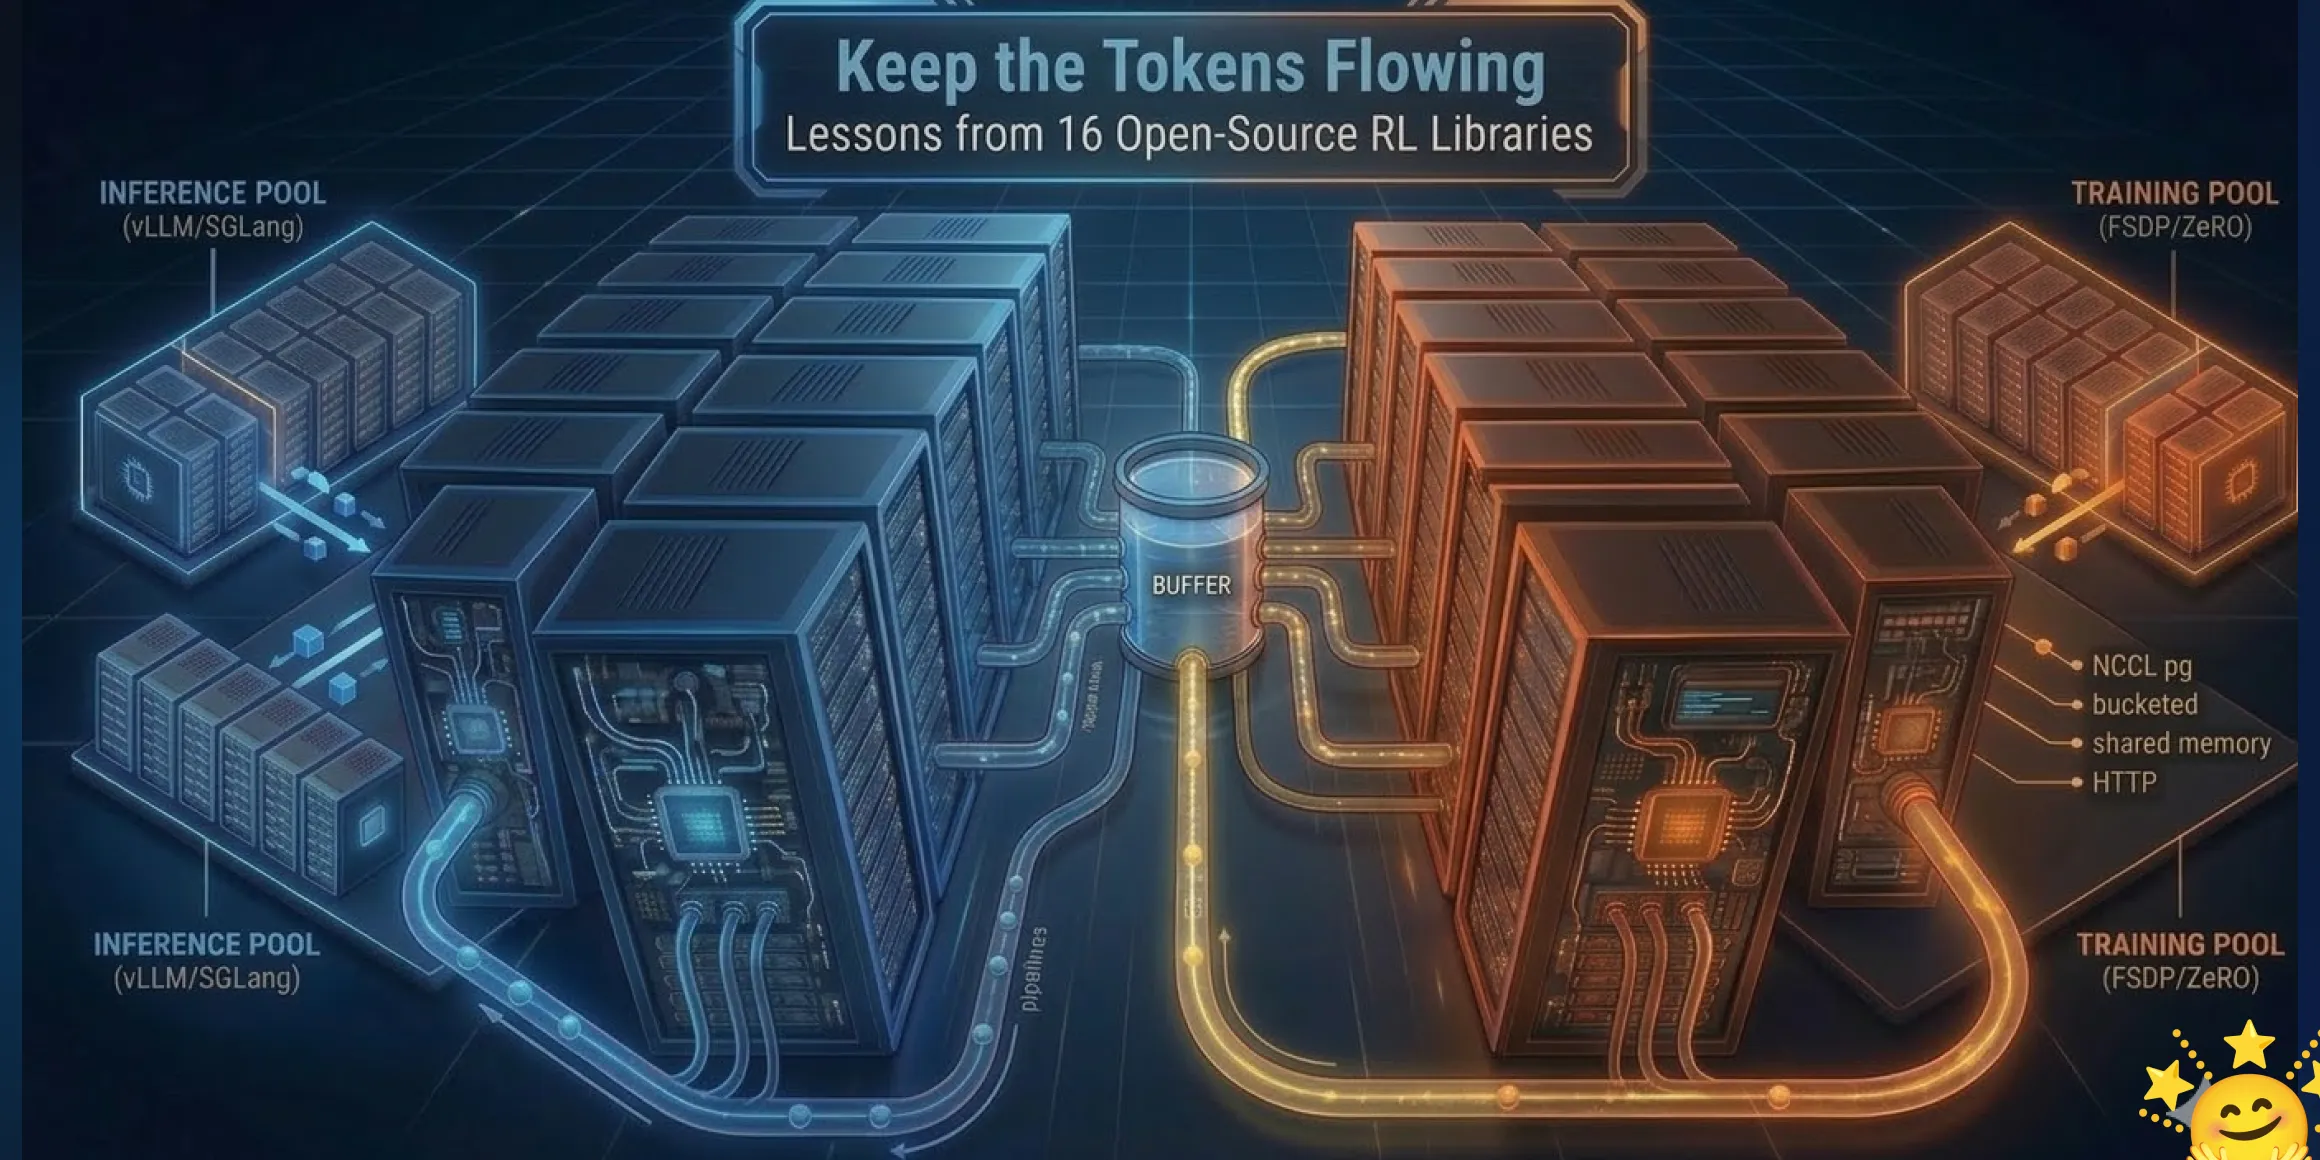
Menținând Fluxul de Token-uri: Lecții din 16 Biblioteci Open-Source de Învățare prin Întărire
O analiză tehnică detaliată a arhitecturilor de învățare prin întărire asincronă, extrăgând principii de design esențiale din 16 biblioteci open-source pentru a optimiza antrenarea modelelor de limbaj de mari dimensiuni.