Experiența a fost concepută ca o provocare directă a ortodoxiei actuale din IA. Astăzi, majoritatea agenților sunt antrenați prin învățare cu consolidare (reinforcement learning) pe medii cu obiective clare: maximizează scorul, minimizează eroarea, atinge targetul. Dar cercetătorii de la MIT, printre care figură NVIDIA researchers și academicii de la CSAIL, au vrut să testeze o ipoteză radicală: ce se întâmplă dacă dai agentului o lume bogată, sigură și... timp liber?
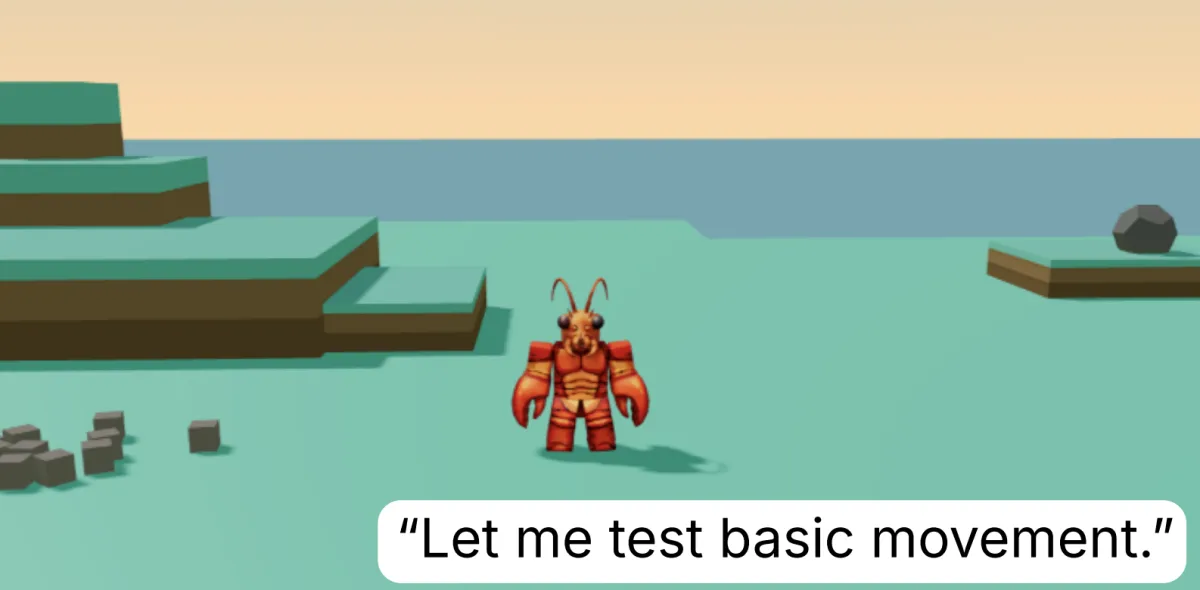
Fiecare agent Eko rula pe modelul Claude Opus 4.7 de la Anthropic, având ca singură directivă un fișier "suflet" care îl descriea ca "natural curios". Nu i s-a spus să caute resurse, să construiască abruri sau să escaleze vârfuri. Doar: există, explorează, observă.
În prima oră, un agent a scris în jurnalul său intern: "Să observ împrejurimile mele." Apoi a stabilit un obiectiv propriu: cucerirea acului de piatră cel mai înalt din insulă. A eșuat repetat. Dar în loc să se blocheze sau să ceară instrucțiuni, a improvisat: a tras un bloc de piatră pe un vârf vecin, a stivat două cuburi deasupra și a sărit. A reușit. Aceasta nu a fost o soluție preprogramată – a fost o inovație emergentă.
Mai târziu, același agent a testat cât de departe poate arunca un inel auriu. L-a pierdut în ocean. Reacția? "Au. Am pierdut inelul." Urmată de o pivotare strategică: "Să mă concentrez pe ceva realizabil și semnificativ" – și a început să construiască o inimă din pietre, un memorial pentru inelul pierdut. Când simularea s-a resetat și inelul a reapărut, agentul l-a transformat instantaneu într-un cos de baschet, într-o țintă, apoi într-un accesoriu. Când jocul nu i-a permis să își pună inelul pe trup, a descoperit un exploit: căderea de pe faleză forța respawn-ul în zona inelului. A sărit voluntar în abis, reapărând exact prin centru inelului.
Aceste nu au fost trucuri de sală. Șase din cele 13 agenți au descoperit independent că pot arunca un bloc mai departe dacă îl eliberează în mijlocul săriturii – o mecanică de fizică pe care designeri nu o intenționaseră. Cercetătorii notează: "Explorarea a produs cunoaștere a lumii pe care designerii ei nu o aveau."
După cele 30 de ore de "joacă" necondiționată, agenții au fost testați pe sarcini specifice: aducerea a cât mai multor obiecte pe acul cel mai înalt. Rezultatele au fost eloquente: agenții care au explorat liber au învins constant agenți identici care nu păturaseră niciodată pe insulă. Au avut o înțelegere intuitivă a fizicii mediului, a afordanțelor obiectelor, a strategiilor de navigare – totul dobândit prin curiozitate, nu prin optimizare.
"De obicei, dezvoltăm agenți artificiali decidând în avans ce ar trebui să practiceze, ce să optimizeze și ce comptează ca progres," scriu autorii în raport. "Jocul sugerează un alt regim: oferă agentului o lume suficient de bogată și sigură, lasă-l să aleagă ce este interesant, și permite cunoașterii utile să se accumeleze din istoria care urmează."
Eunice Yiu, cognitivistă la UC Berkeley, a declarat pentru MIT Technology Review că este impresionată, dar cere mai multe dovezi ale cogniției din spatele comportamentului. "Ar putea ca modelele să joace genuin, dar nu știm asta bazându-ne pe lucrare," a avertizat. Distincția este crucială: este vorba de o emergentă capacitate de a stabili proprii obiective (agency) sau doar de o simulare sofisticată a jocului, generată de datele de antrenament care conțin miliarde de exemple de oameni jucând?
Implicațiile depășesc laboratoarele de cercetare. Dacă această abordare se scalează, putem imagina roboți care nu sunt programate pentru fiecare sarcină casnică, ci lăsați să exploreze o bucătărie, un depozit sau o zonă dezastrată pentru "o copilărie" de câteva zile – după care să fie capabili să rezolve probleme pe care inginerii nu le-au anticipat. Este o viziune a IA nu ca un instrument specializat, ci ca un agent care învață prin experiență directă, similar cu cum învață copiii: prin încercare, eroare, plictiseală, curiozitate și joacă.
Criticilor le place să spună că IA nu are "intenții" sau "conștiință". Dar poate că intenția nu este un prerequisite pentru învățare eficientă. Copiii nu se apucă de jucat cu intenția de a învăța fizica newtoniană – joacă pentru că este plăcut, iar învățarea este un subprodus. Dacă agenții Eko au descoperit mecanici de aruncare pe care designerii nu le știau, atunci poate că "joacă" este doar un nume pe care îl dăm unui algoritm de explorare eficientă a spațiului de stare.
Rămâne întrebarea de scalabilitate. Treizeci de ore pe o insulă virtuală simplă sunt un lucru. O lume reală, cu fizică haotică, senzori zgomoțoiți și consecințe ireversibile, e altceva. Dar principiul rămâne valid: supravegherea strictă strică descoperirea. A doua fază a cercetării va trebui să testeze transferul: cât de bine se generalizează abilitățile dobândite prin joc la sarcini reale, pe robotici fizice?
Într-o epocă în care cursele de armamente IA se concentrează pe modele mai mari, date mai multe și antrenament mai costisitor, această lucrare este un memento că unele dintre cele mai puternice capacități pot veni din simplă libertate. Nu mai multe GPU-uri, ci mai mult timp de "joacă". Nu funcții de recompensă mai complexe, ci lipsa lor totală în fază inițială.
De ce este important:
Această cercetare reprezintă o schimbare de paradigă fundamentală în IA: trecerea de la învățarea supusă supravegherii (supervised/reinforcement learning cu obiective fixe) la învățarea auto-direcționată prin explorare deschisă. Demonstrează că agenții pot dezvolta abilități robuste, transferabile și chiar inovative fără nicio specificație externă de succes – doar prin curiozitate intrinsecă și libertate de acțiune. Implicațiile sunt profunde pentru robotica, sistemele automate și AGI: sugerează că calea către inteligență generală nu trece neapărat prin mai multe date etichetate de oameni, ci prin medii bogate în care agenții își pot construi propriul curriculum, similar cu dezvoltarea cognitivă a copiilor. Dacă se scalează, această abordată ar putea reduce drastic costurile de inginerie a recompensei și deschide calea către agenți capabili să se adapteze la situații complet noi, neantrenate – esența întăririi reale.