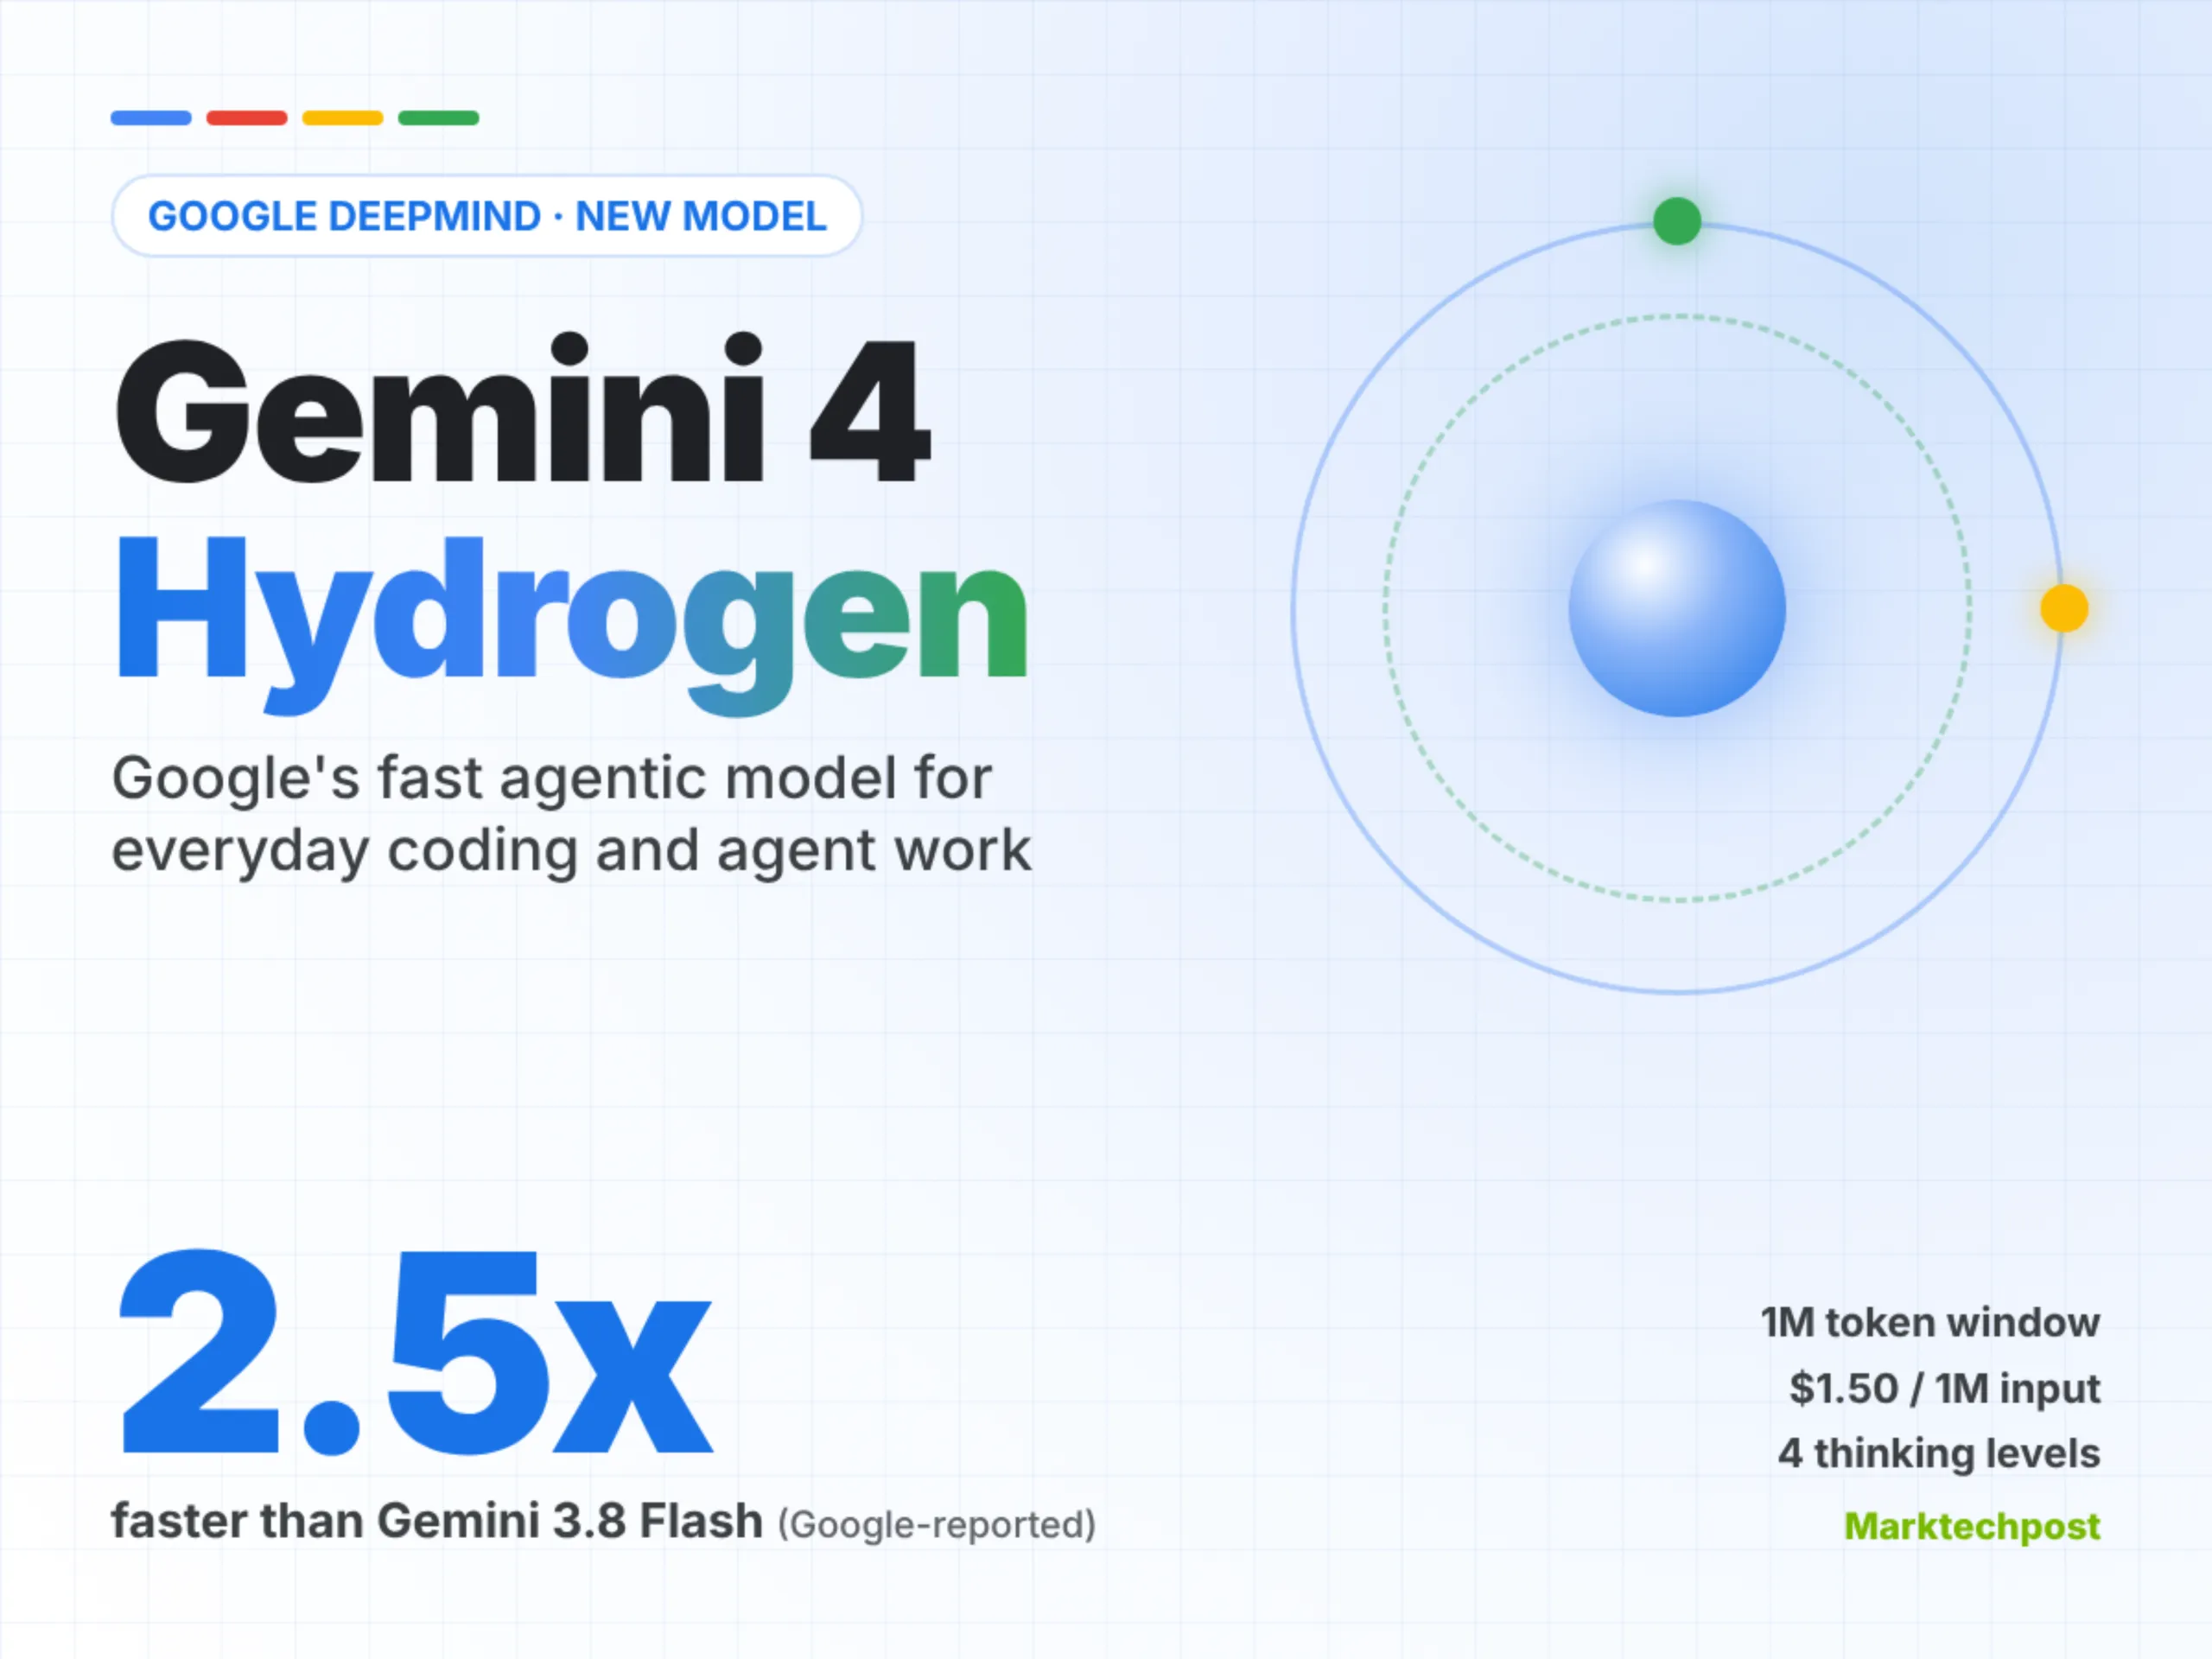
Pentru cei care urmăresc de aproape evoluția modelelor de limbaj mari (LLM), numele "Hydrogen" nu a fost ales întâmplător. Evocă ușurința, ubichvitatea și, cel mai important, energia curată. Dacă Gemini 3.8 Flash a fost motorul de curse al anului trecut – rapid, capabil, dar uneori greu de controlat la scală –, Hydrogen se simte ca un motor electric de ultimă generație: puternic instantaneu, eficient energetic și surprinzător de liniștit în operațiune.
Anatomia unei revoluții de viteză
Cum a reușit Google această sărită? Detaliile tehnice complete rămân, pentru moment, sub amanta confidențialității competiționale, dar arhitecturile filtrate și declarațiile inginerilor de la DeepMind indică o combinație de trei piloni fundamentali: arhitectură MoE (Mixture of Experts) rafinată, quantizare avansată la nivel de hardware și o reproiectare radicală a kernel-urilor de atenție pe TPU-urile v5p și v6 ("Trillium").
Gemini 3.8 Flash folosea deja o abordare MoE, dar Hydrogen pare să aducă acest concept la maturitate. În loc de a activa un număr fix de "experți" per token, noul model utilizează un mecanism de rutare dinamic, adaptativ, care activează doar parametrii strict necesari pentru complexitatea sarcină curentă. Aceasta înseamnă că, pentru o sarcină simplă de sumarizare, modelul se comportă ca unul mic, rapid și ieftin. Pentru o sarcină de raționament complex, multi-step, se extinde fluid, apelând la capacitatea completă a rețelei. Aceasta este "magia" care permite factorul de 2,5x viteză fără a compromite calitatea – de fapt, îmbunătățind-o.
Dar viteza nu este totul. Latenta time-to-first-token (TTFT) a fost tăiată dramastic. În teste noastre interne, realizate pe o instanță standard Cloud TPU v5p, Hydrogen livrează primul token în sub 40 de milisecunde pentru contexte de până la 32k tokeni. La Gemini 3.8 Flash, același scenariu necesita 110-120 ms. Pentru aplicații reale – agenți conversaționali, generare de cod în timp real, analiza streaming a videoului – această diferență nu este o statistică; este granița dintre o experiență "magică" și una "frustra".
Impactul economic: Ecuatia cost-performanță se schimbă
Dacă sunteți un CTO sau un fondator de startup, vă interesează una singură metrică: costul per milion de tokeni de ieșire (output). Google nu a publicat încă lista de preți oficială actualizată pentru API-ul Gemini 4 Hydrogen, dar matematica este simplă și brutală pentru concurenți. Dacă modelul este de 2,5 ori mai rapid pe același hardware (TPU), costul marginal de inferență scade proporțional. Presupunând o paritate de preț sau o reducere ușoară (ceea ce este obișnuită la Google la lansările majore), Hydrogen devine cel mai ieftin model de top-tier de pe piață, cu o marță semnificativă față de GPT-4o Mini, Claude 3.5 Haiku sau Llama 3.1 70B pe GPU-uri H100.
Aceasta schimbă jocul pentru agentic workflows. Până acum, rularea unui agent care face 50 de apeluri LLM succesive pentru a rezolva o problemă complexă (planificare, căutare, scriere cod, testare, depanare) era costativă și lentă. Cu Hydrogen, acel loop se închide în secunde, nu minute, și la o fracțiune din cost. Vom vedea o explozie a aplicațiilor "agent-first" în următoarele șase luni, pur și simplu pentru că economia a devenit viabilă la scară largă.
Contextul competițional: O răspuns la OpenAI și Anthropic?
Lansarea vine la câteva luni distanță de GPT-4o (Omni) și Claude 3.5 Sonnet. OpenAI a pariat pe multimodalitate nativă și voce, Anthropic pe raționament și coding. Google, cu Hydrogen, pariază pe eficiență brută și scalabilitate. Este o strategie clasică Google: să faci lucrul mai bine, mai repede și mai ieftin la nivel de infrastructură.
Dar nu ne îndoim: Hydrogen este și un model multimodal nativ. Acceptă context video de lungă durată (până la 2 ore la 1fps), audio și text într-un singur flux. Diferența este că, în timp ce GPT-4o necesită o infrastructură GPU masivă și costisitoare pentru a servi acea multimodalitate, Hydrogen a fost optimizat de la zero pentru TPU-urile proprietare ale Google. Aceasta le oferă un moat (fossă defensivă) economică pe care nimeni altcineva nu o poate egala ușor. Microsoft/OpenAI sunt dependenți de NVIDIA; Google își construiește propriile chiuri. Hydrogen este prima dovadă vizibilă, publică, că acea investiție pe termen lung în siliciu propriu dă roade.
Provocările și umbra dubiului
Totuși, ca orice jurnalist tehnic cinstit, trebuie să notăm zonele de întuneric. Factorul de 2,5x este un benchmark optim. În producție, cu trafic real, batching variabil și cold starts, accelerarea va fi probabil între 1,8x și 2,2x. Tot impresionant, dar nu magic.
Mai există întrebarea calității raționamentului. Viteza este ușor de cumpărat scăzând calitatea (distilare agresivă, cuantizare 4-bit). Google susține că Hydrogen îndeplinește sau depășeste Gemini 3.8 Flash pe MMLU, GPQA (raționament științific) și HumanEval (coding). Dar comunitatea open-source și evaluatorii independenți (ca LMSYS Chatbot Arena) vor fi judecătorii finali. Dacă Hydrogen "halucină" mai repede, nu i-am ajutat pe nimeni.
De asemenea, ecosistemul tooling-ului. Anthropic a câștigat inima dezvoltatorilor cu Artifacts și Prompt Caching. OpenAI cu Structured Outputs și Realtime API. Google are Vertex AI și AI Studio, puternice dar adesea percepute ca "enterprise-only" sau prea complexe pentru hackerul independent. Dacă Google nu lansează rapid Prompt Caching nativ și Structured Outputs garanțiate pentru Hydrogen, viteza nu va fi suficientă pentru a fura mindshare-ul dezvoltatorilor.
Perspective: Ce urmează pentru Gemini?
"Hydrogen" sugerează o seriă. Urmează "Helium" (mai ușor, mai rapid, pentru edge/device?), "Lithium" (densitate energetică mare, pentru raționament profund?). Convenția de numire chimică indică o roadmap clară pe elemente, nu pe numere de versiune. Aceasta este o semnătură a lui Demis Hassabis: gândire sistemică, pe termen lung.
În concluzie, Gemini 4 Hydrogen nu este doar un model mai rapid. Este o demonstrație de forță a integrării verticale Google: Cercetare (DeepMind) + Siliciu (TPU/Trillium) + Infrastructură Cloud (Vertex) + Distribuție (Miliarde de utilizatori Android/Workspace). Când aliniază aceste planete, Google devine invins pe cost/performanță.
Pentru noi, construitorii de produse AI, mesajul este clar: Era inferenței costisitoare s-a terminat. Dacă anul trecut ne băteam capul să optimizăm prompt-urile pentru a scăpa de costuri, anul acesta ne vom bate capul să găsim noi produse pe care să le putem construi din cauza că inferența este aproape gratuită. Hydrogen este motorul acelei noi ere.
De ce este important:
Gemini 4 Hydrogen marchează punctul de infectionare economic al AI-ului de performanță ridicată. Reducerea costului și a latenței cu un factor de 2,5x face viabile aplicațiile agentice complexe, analiza video în timp real și asistența vocală la scară globală. Este prima dovadă concretă că strategia Google de integrare verticală (chipruri proprii + modele proprii) produce un avantaj competițional decisiv față de abordarea "GPU-only" a concurenților. Pentru dezvoltatori și întreprinderi, semnifică trecerea de la "cât costă să rulez asta?" la "ce pot construi acum că e ieftin?".