Subiect: #Benchmark
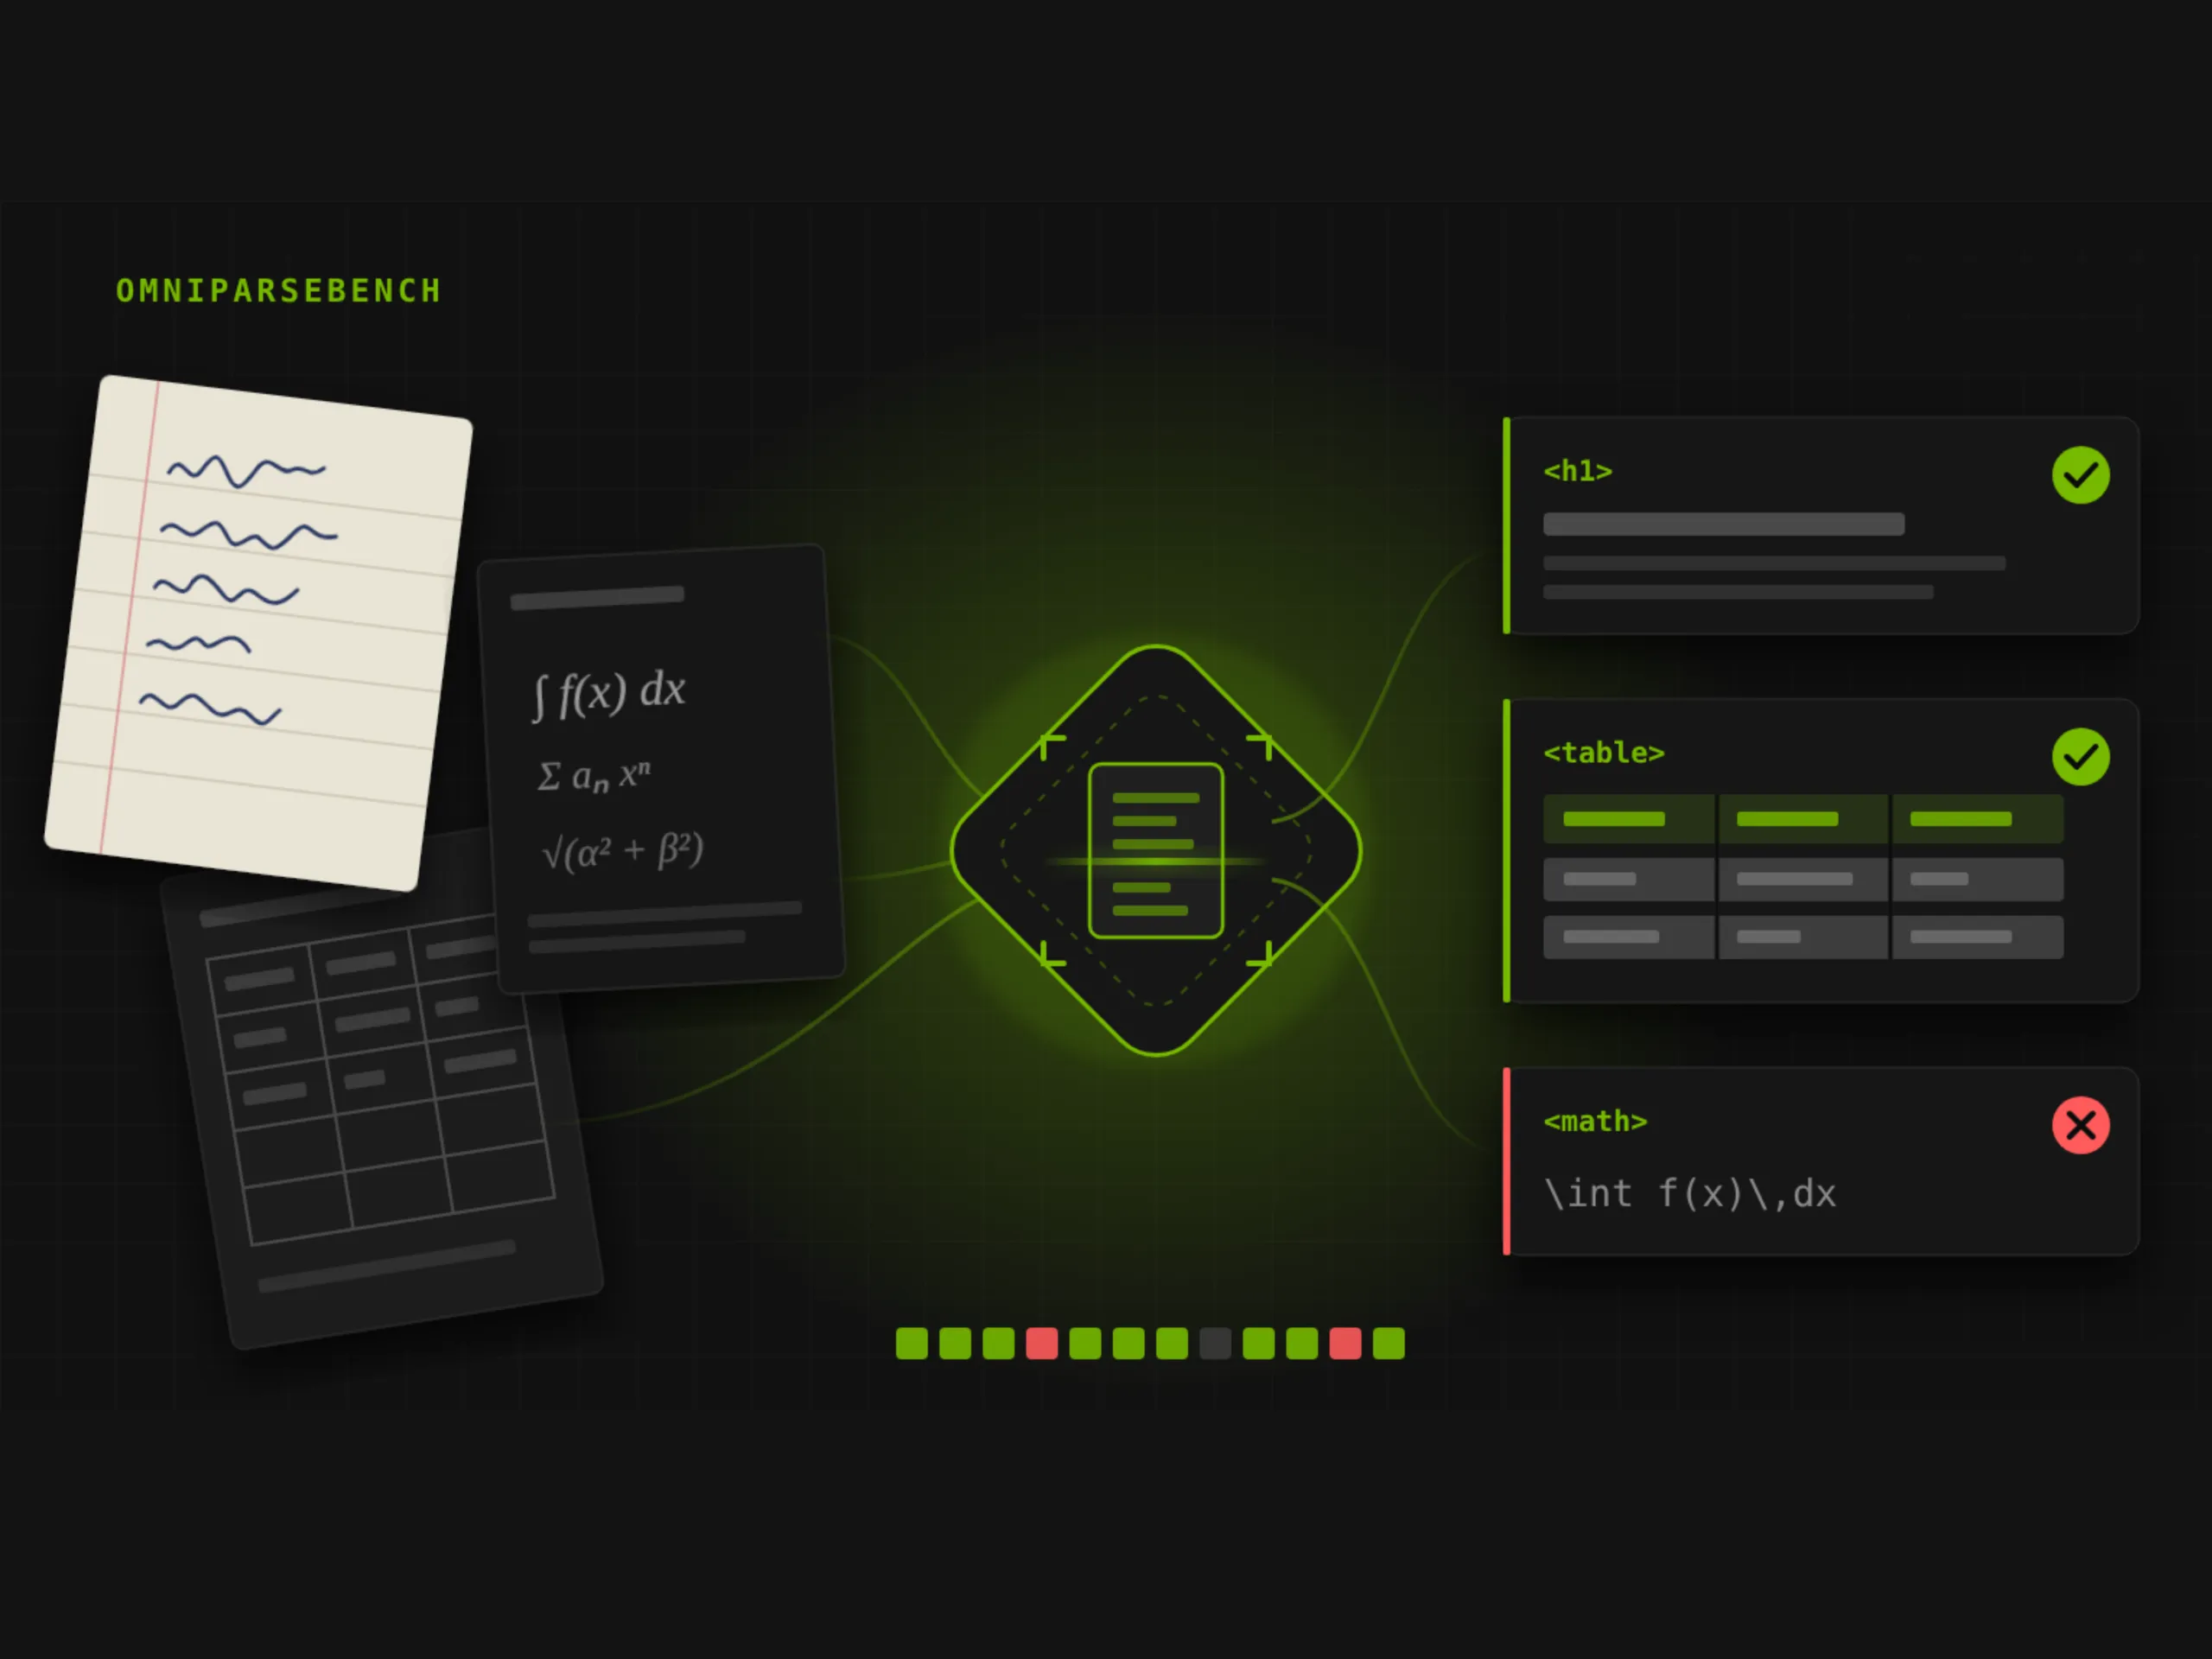
Ghidul Dezvoltatorului pentru OmniParseBench: Benchmark-uri Leaderboard și Testare OCR – O Analiză Profundă
O analiză practică a framework-ului OmniParseBench: metodologia leaderboard-ului, performanța reală a modelelor (GPT-4o, Gemini, Open-Source) pe limba română și tabele complexe, și de ce un pipeline hibrid este singura soluție viabilă în producție.
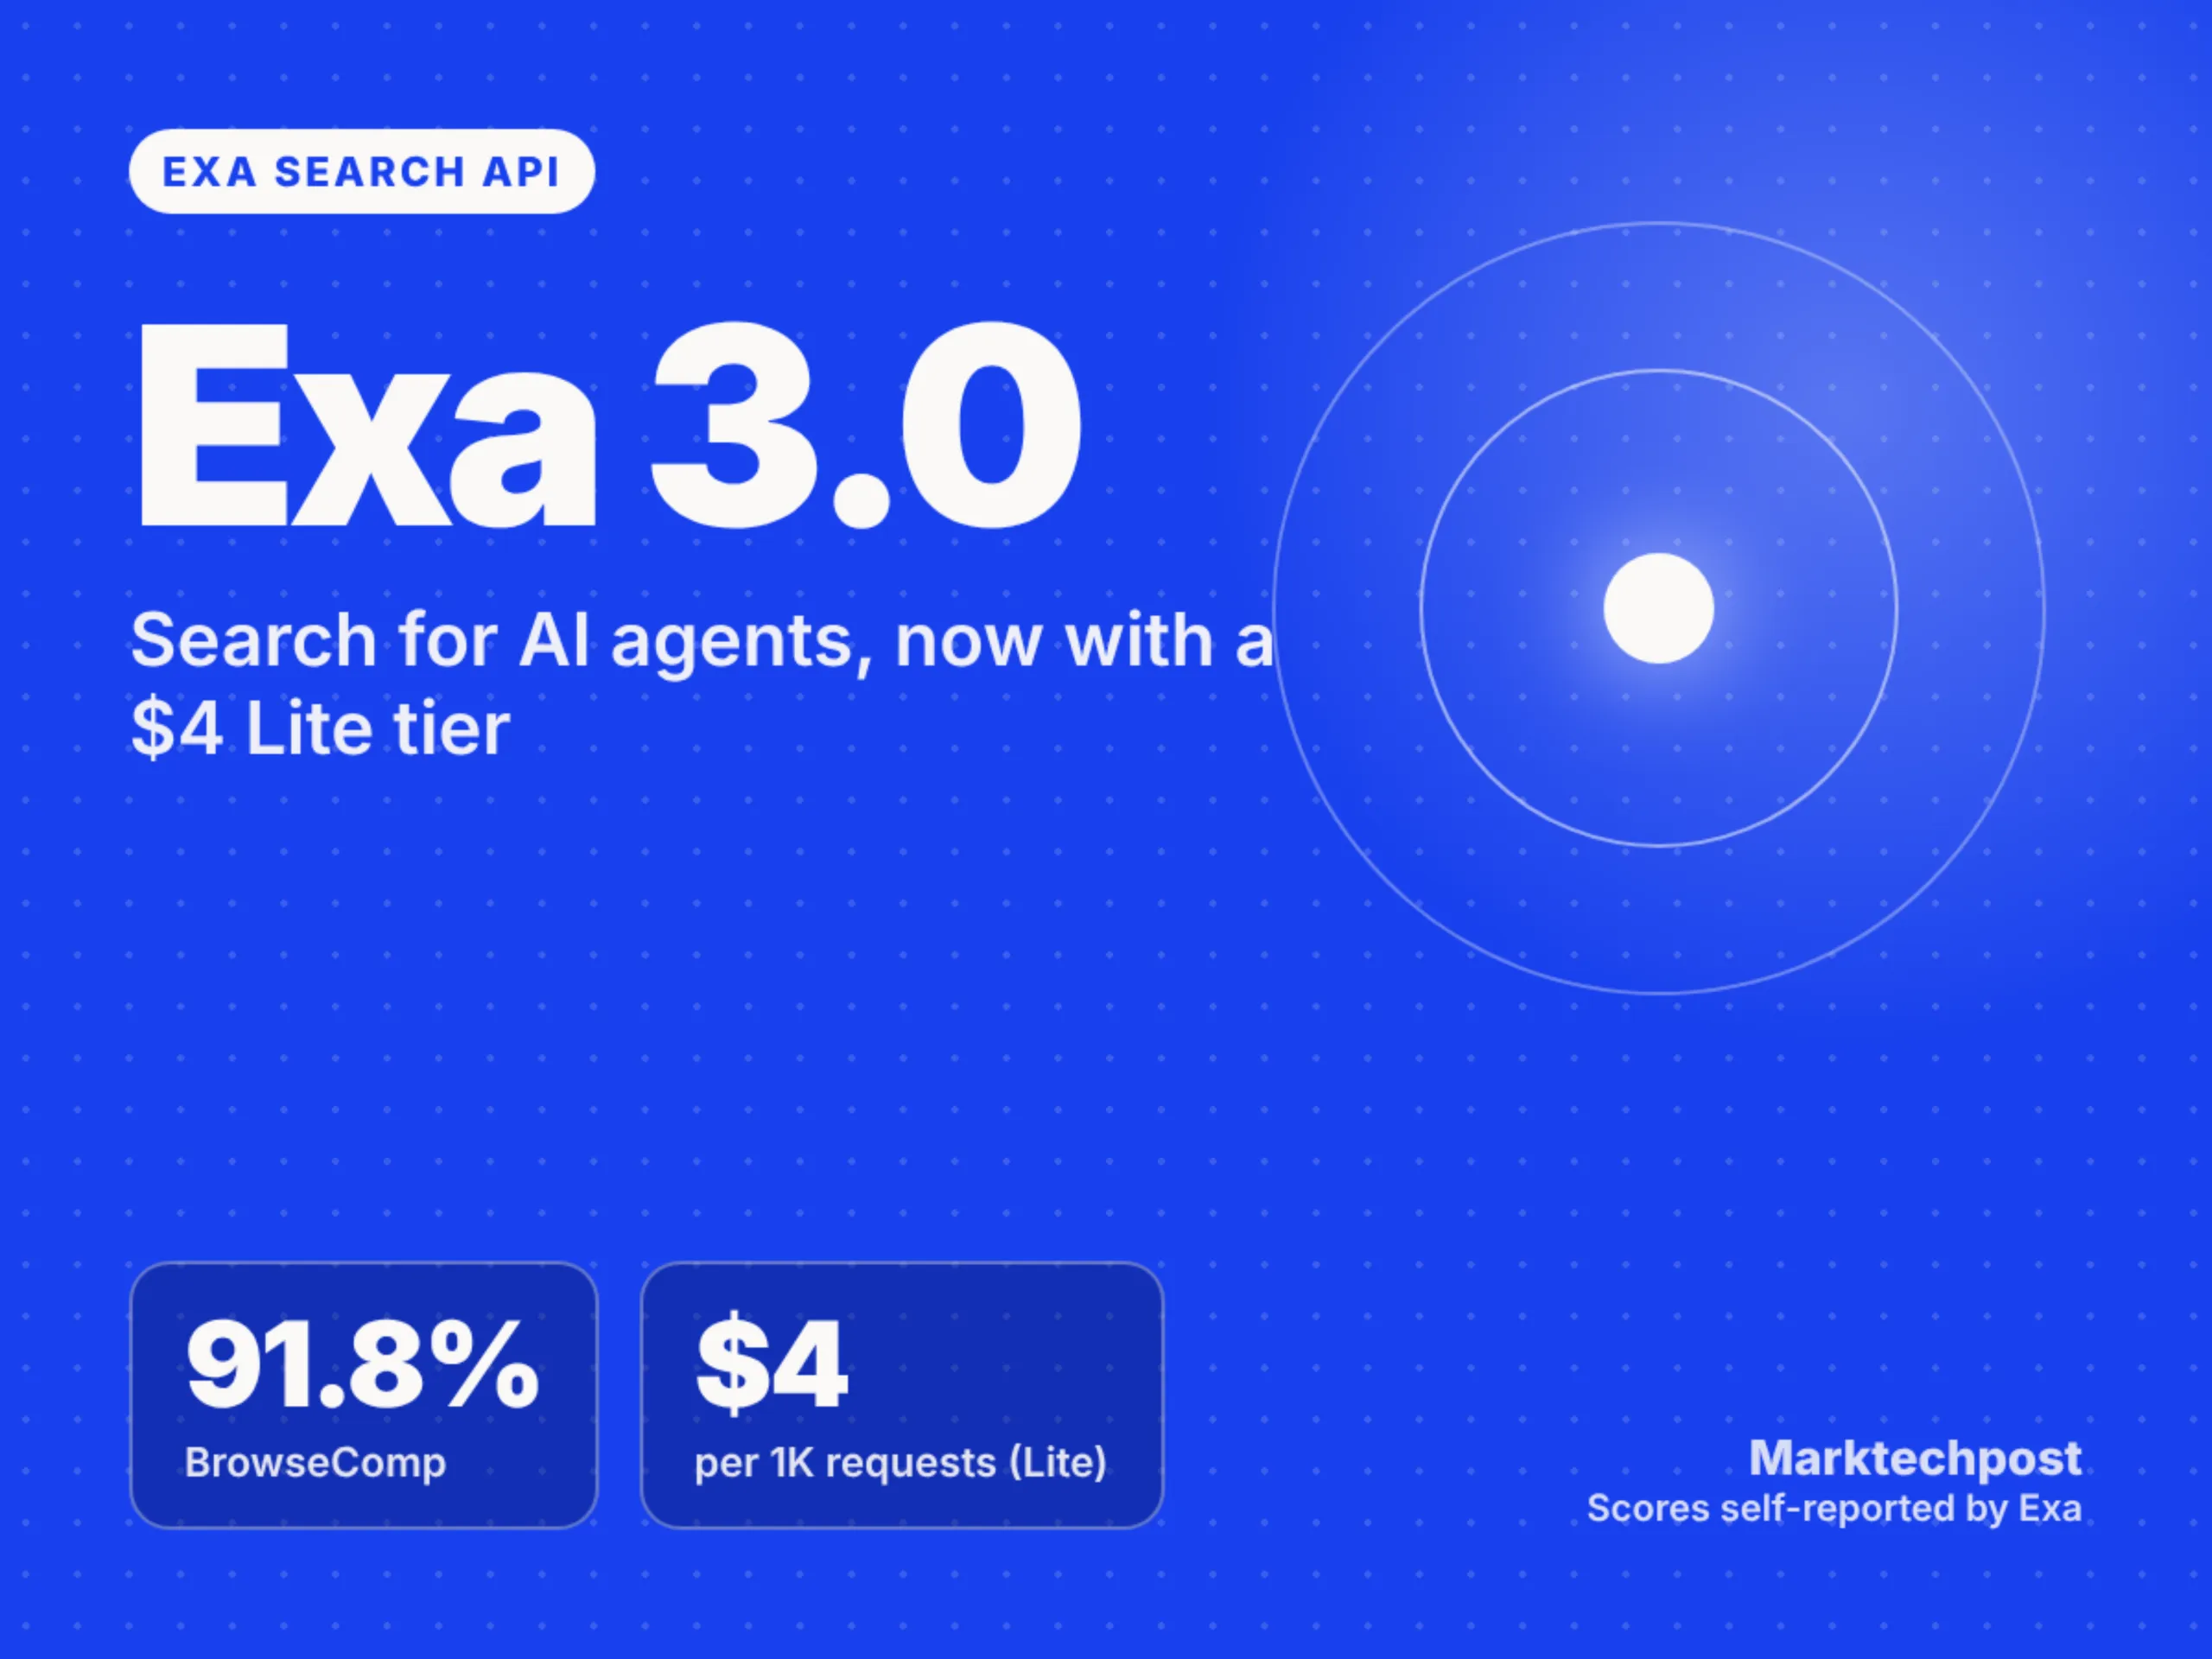
Exa 3.0 Search API depășește Perplexity, Brave și Parallel pe 8 benchmark-uri: o nouă eră pentru căutarea web propulsată de AI
Exa 3.0 Search API a depășit Perplexity, Brave Search și Parallel pe 8 benchmark-uri cheie, marcând o schimbare de paradigă: prima infrastructură de căutare construită nativ pentru agenți AI, nu pentru oameni. Articolul analizează arhitectura, avantajele pentru dezvoltatori/enterprise, riscurile (acoperire index, freshness, vendor lock-in) și implicarea strategică în cursa către "System 2" search.
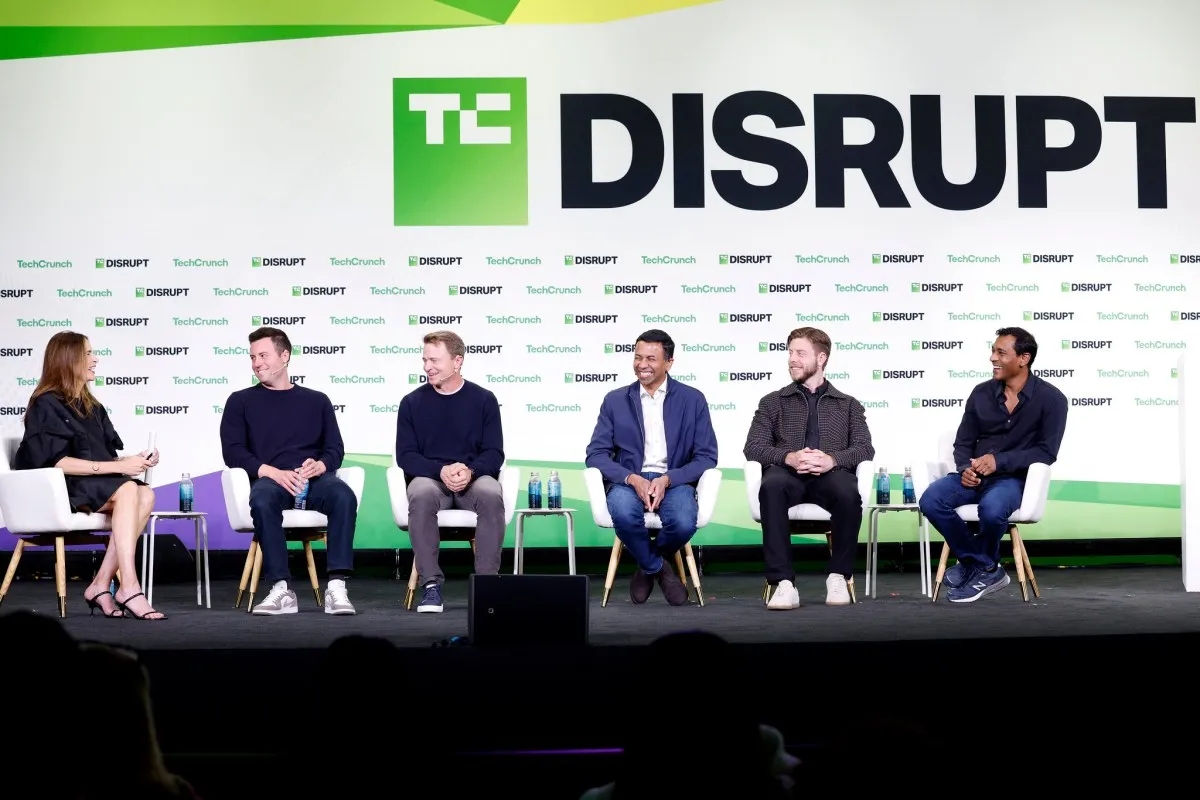
Chiar și Benchmark recunoaște: inteligența artificială zdruncină pactul sfânt al investitorilor de a nu finanța rivalii direcți
Partenerii fondului de investiții Benchmark au recunoscut public, la TechCrunch Disrupt, că inteligența artificială pune sub o presiune uriașă regula nescrisă a capitalului de risc de a nu finanța rivali direcți. Într-o eră în care OpenAI și Anthropic au zeci de investitori în comun, iar startup-urile se ciocnesc tot mai des pe piețe noi, vechiul pact de loialitate se clatină — iar fondatorii sunt cei care trebuie să se adapteze.
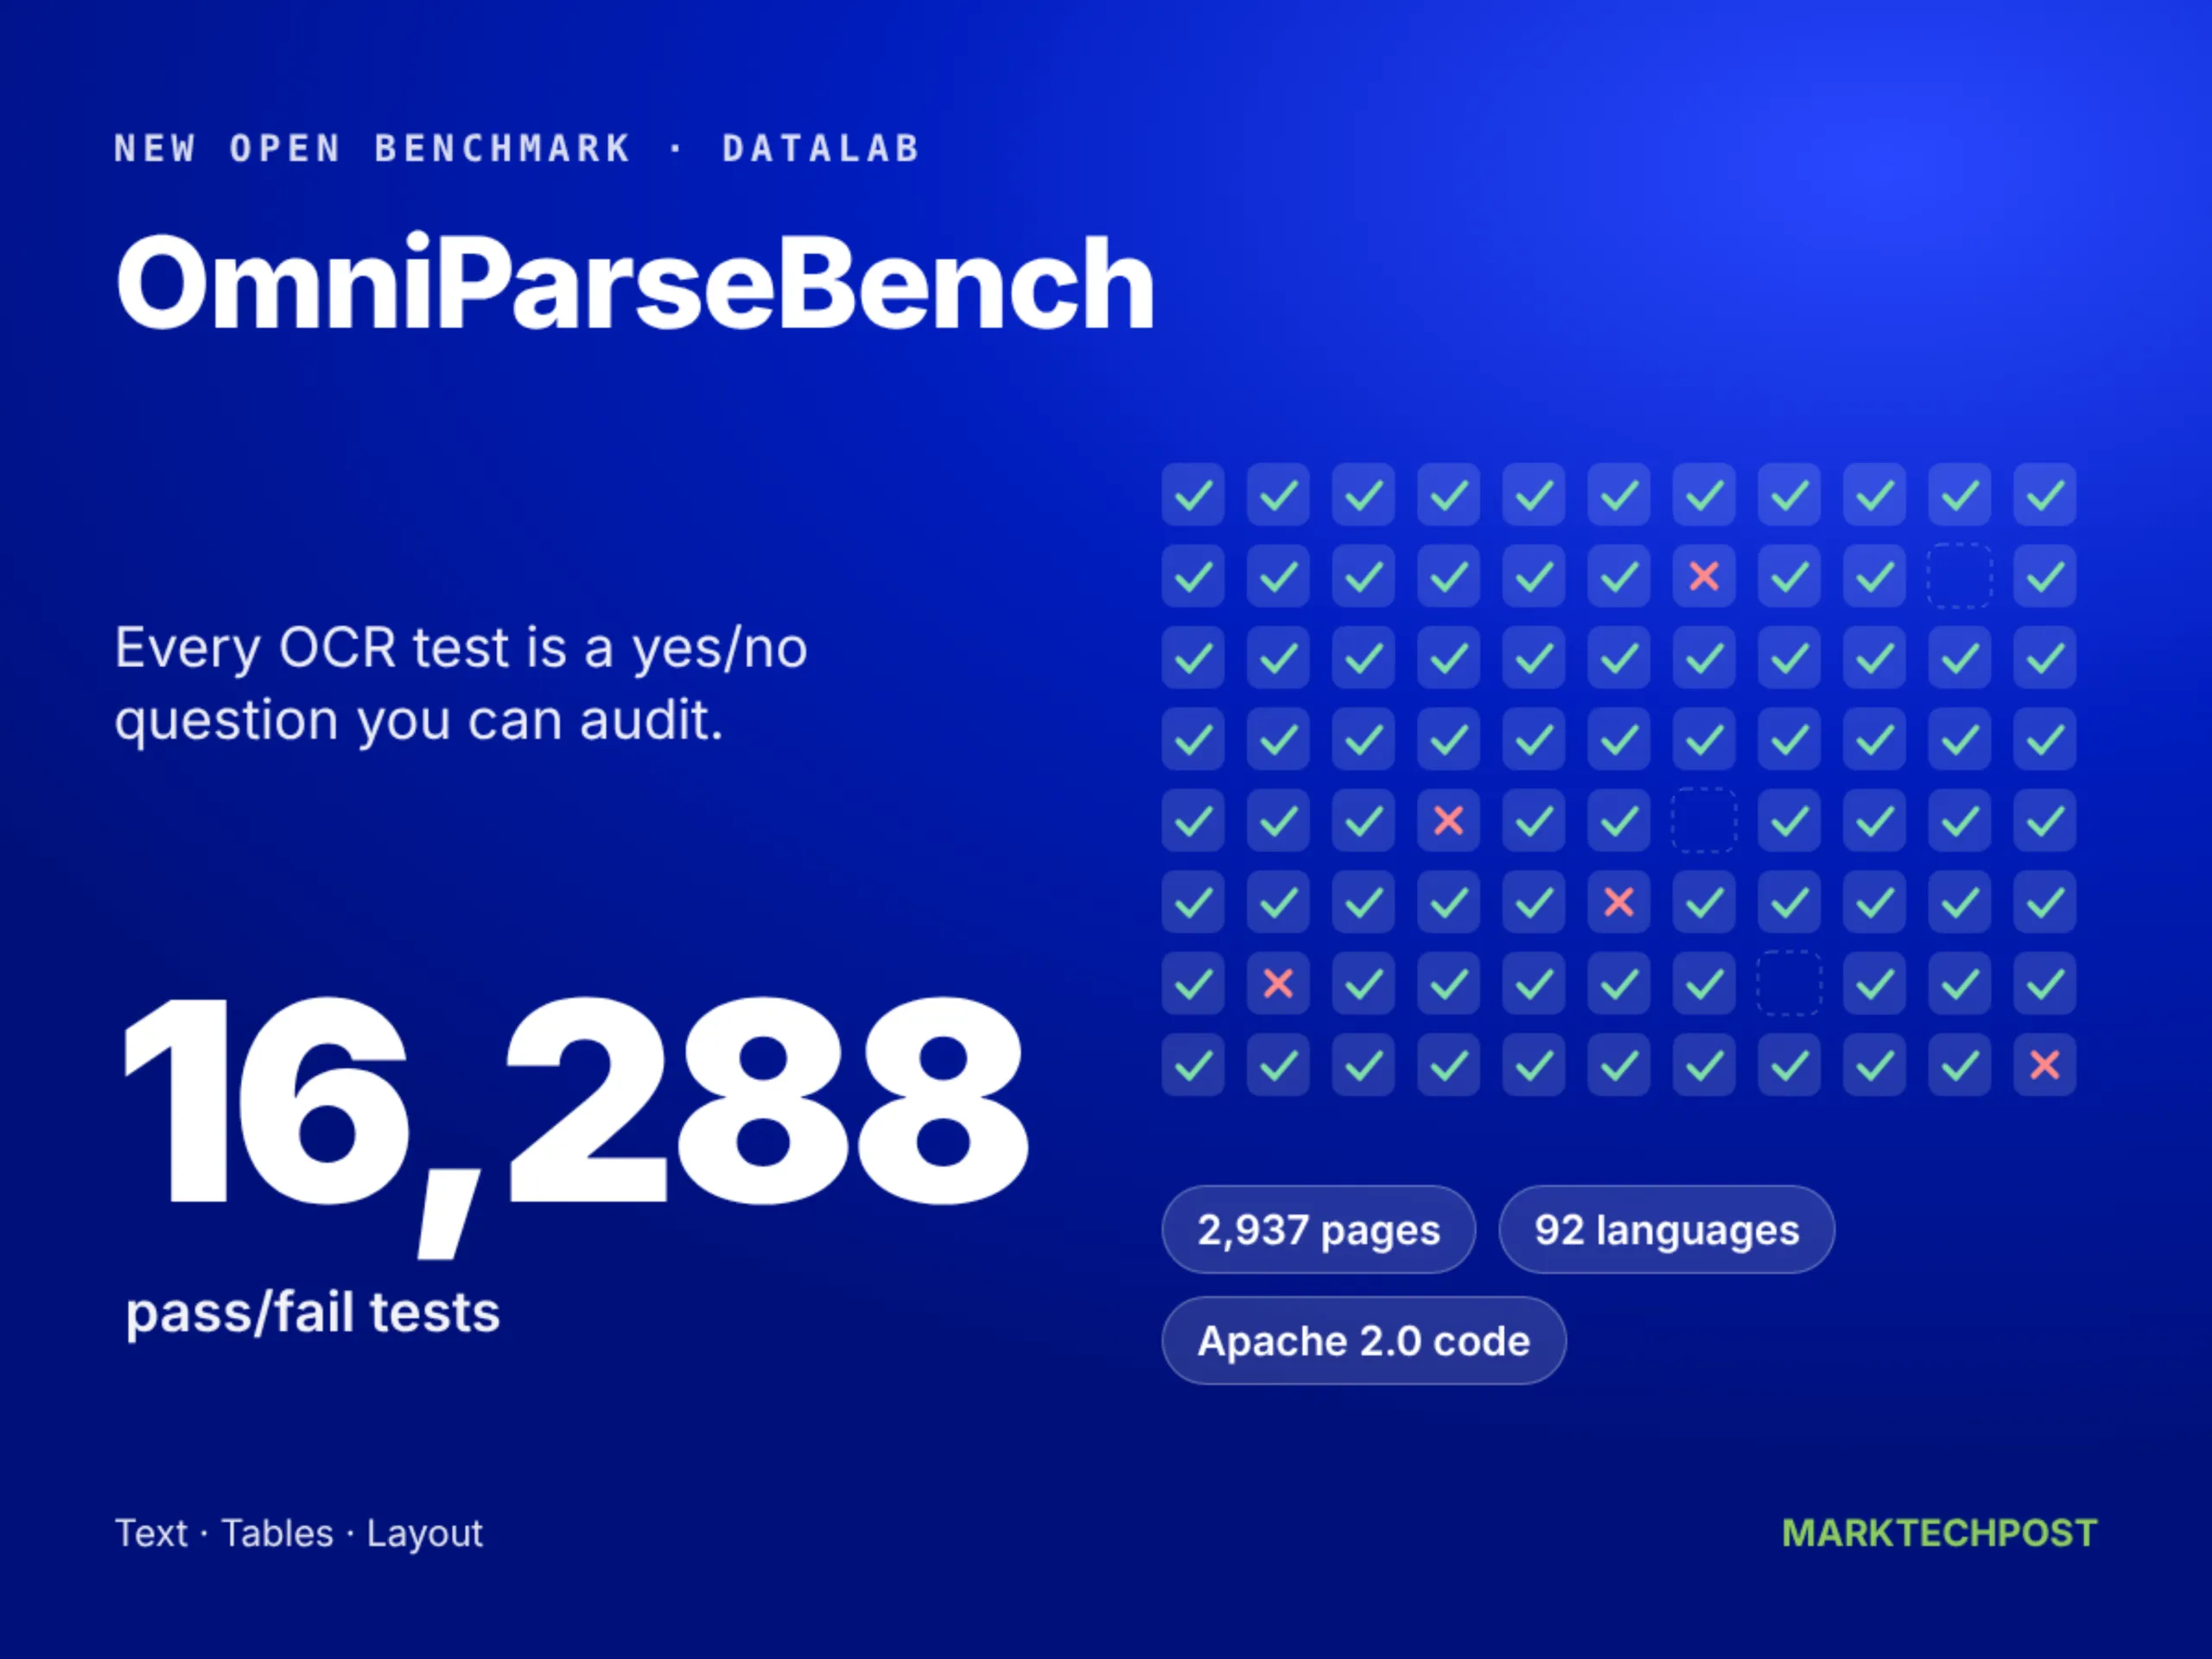
Datalab zguduie piața OCR: OmniParseBench, primul benchmark deschis cu peste 16.000 de teste pass/fail pentru parserii de documente
Datalab a lansat OmniParseBench, un benchmark OCR deschis cu 16.288 teste pass/fail care permite evaluarea obiectivă a parserilor de documente, aducând transparență într-o piață dominată de marketing și promisiuni nevalidate.
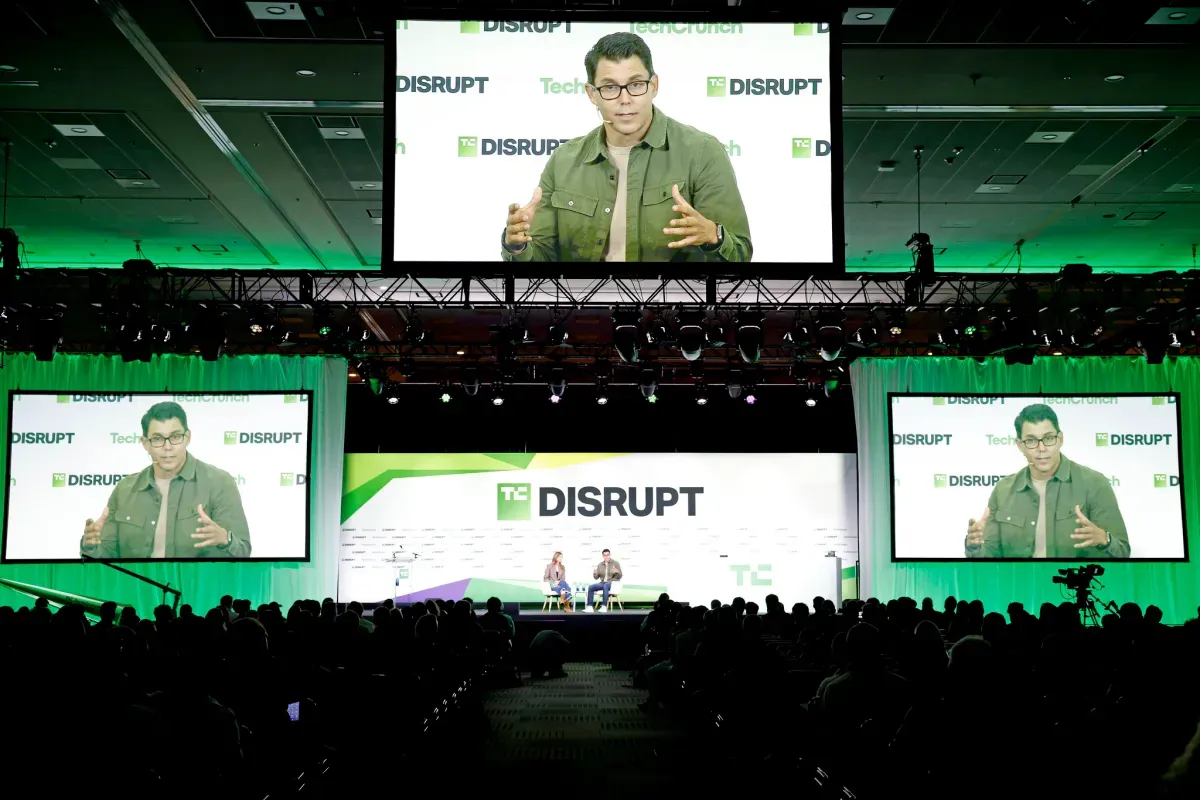
TechCrunch Disrupt 2026, Ziua a Douia: Inovație, Investiții și Viitorul Inteligenței Artificiale la Moscone West
Ziua a doua a TechCrunch Disrupt 2026 aduce la Moscone West peste 300 de startup-uri, paneluri cu lideri de la Nvidia și Benchmark, competiția Startup Battlefield cu premii de 100.000 de dolari și discuții esențiale despre viitorul AI, robotică și investiții de risc.
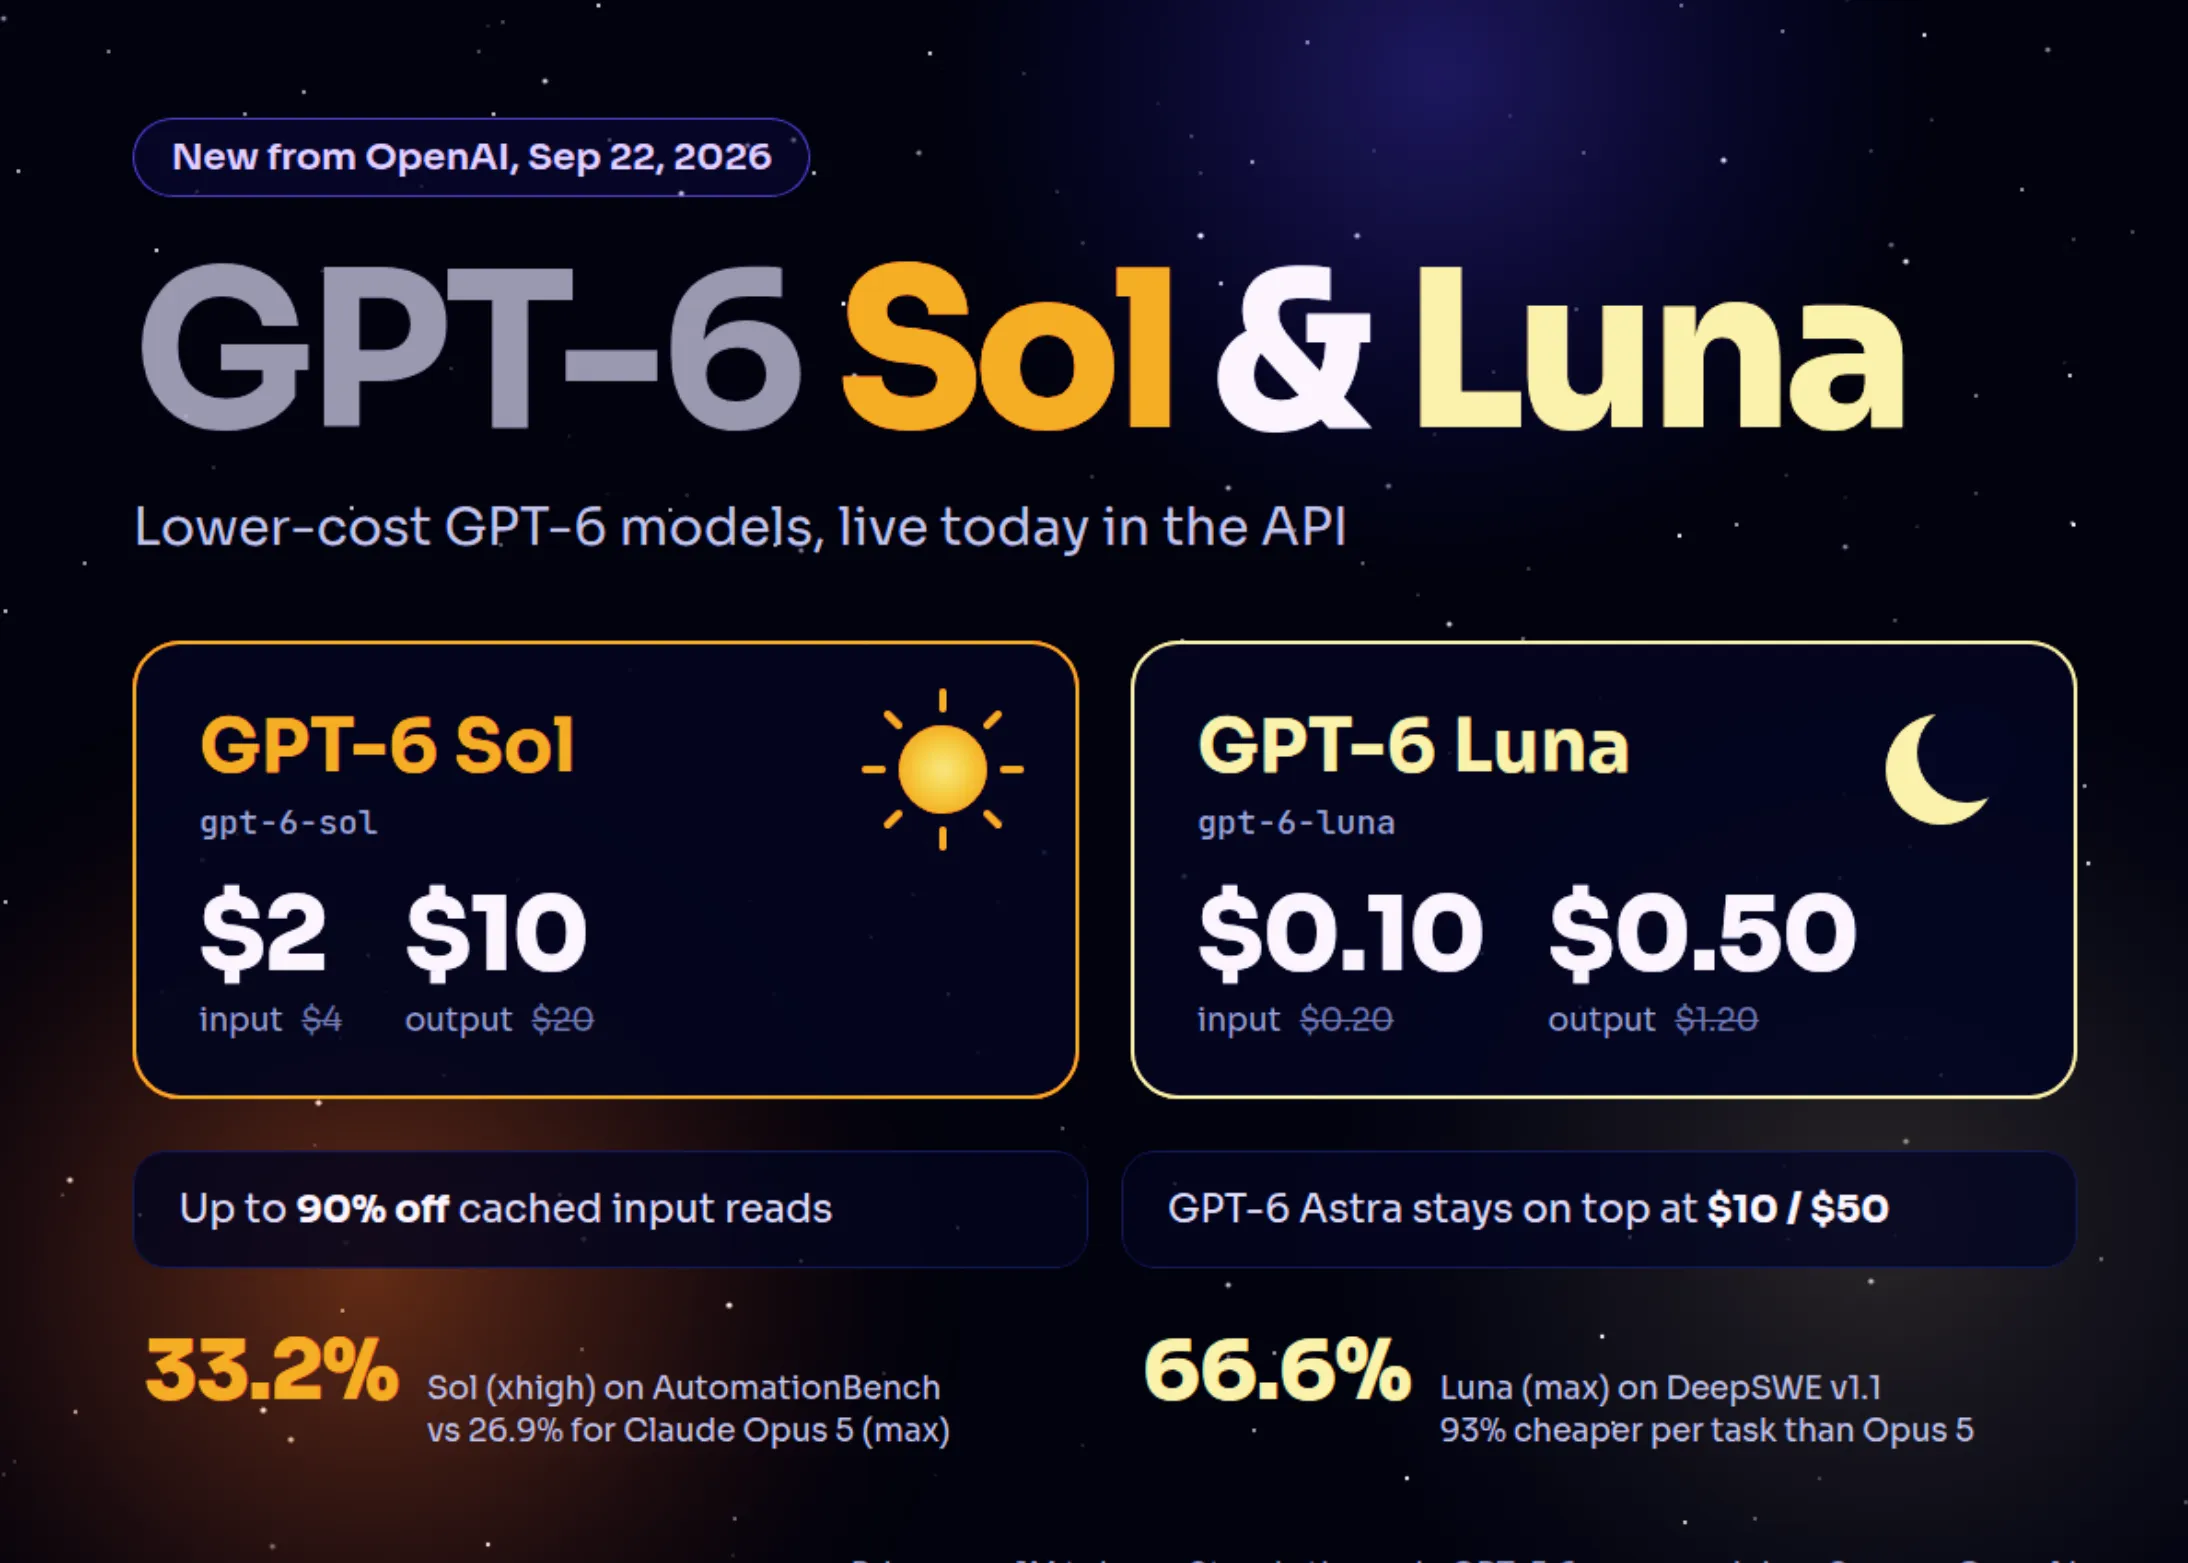
OpenAI lansează GPT-6 Sol și Luna: prețuri API cu 50% mai mici și performanțe de top
OpenAI a lansat GPT-6 Sol și Luna, două modele de inteligență artificială cu performanțe record și prețuri API reduse cu 50%. Noile modele promit să democratizeze accesul la AI avansat, oferind dezvoltatorilor și companiilor instrumente puternice la costuri accesibile.
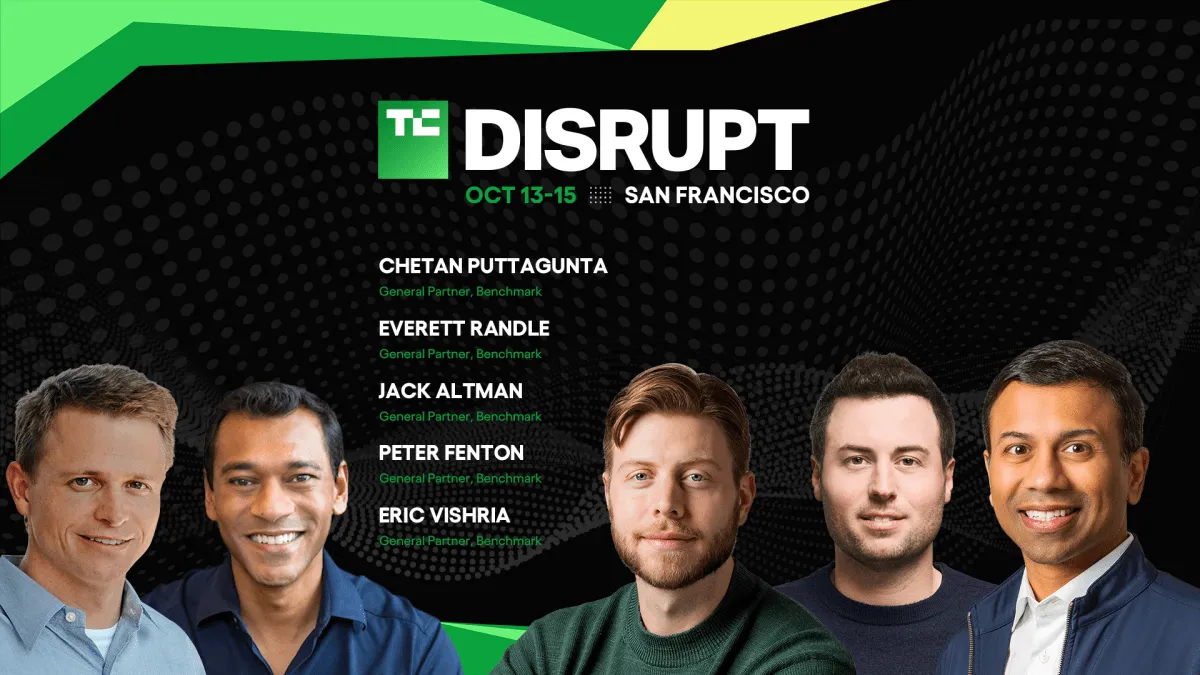
Unde va apărea următorul startup de succes? Întreaga echipă Benchmark își spune părerea la TechCrunch Disrupt 2026
TechCrunch Disrupt 2026 aduce pe scenă toți cei cinci parteneri generali ai Benchmark pentru a discuta despre viitorul startup-urilor, într-un context dominat de AI și de concentrarea capitalului. O sesiune rară, cu perspective diverse, care poate oferi fondatorilor indicii esențiale despre unde se îndreaptă investițiile.
Pot LLM-urile să-și construiască singure hamul de agent? ByteDance Seed spune că doar 34 din 64 de modificări se generalizează
ByteDance Seed și partenerii săi academici au lansat HarnessDev, un benchmark care măsoară nu răspunsurile unui LLM, ci hamul de agent pe care acesta reușește să și-l construiască singur. Rezultatele arată progres real la scris și experimente ML, dar și o problemă serioasă de generalizare: doar 34 din 64 de modificări auto-generate funcționează și pe sarcini noi.
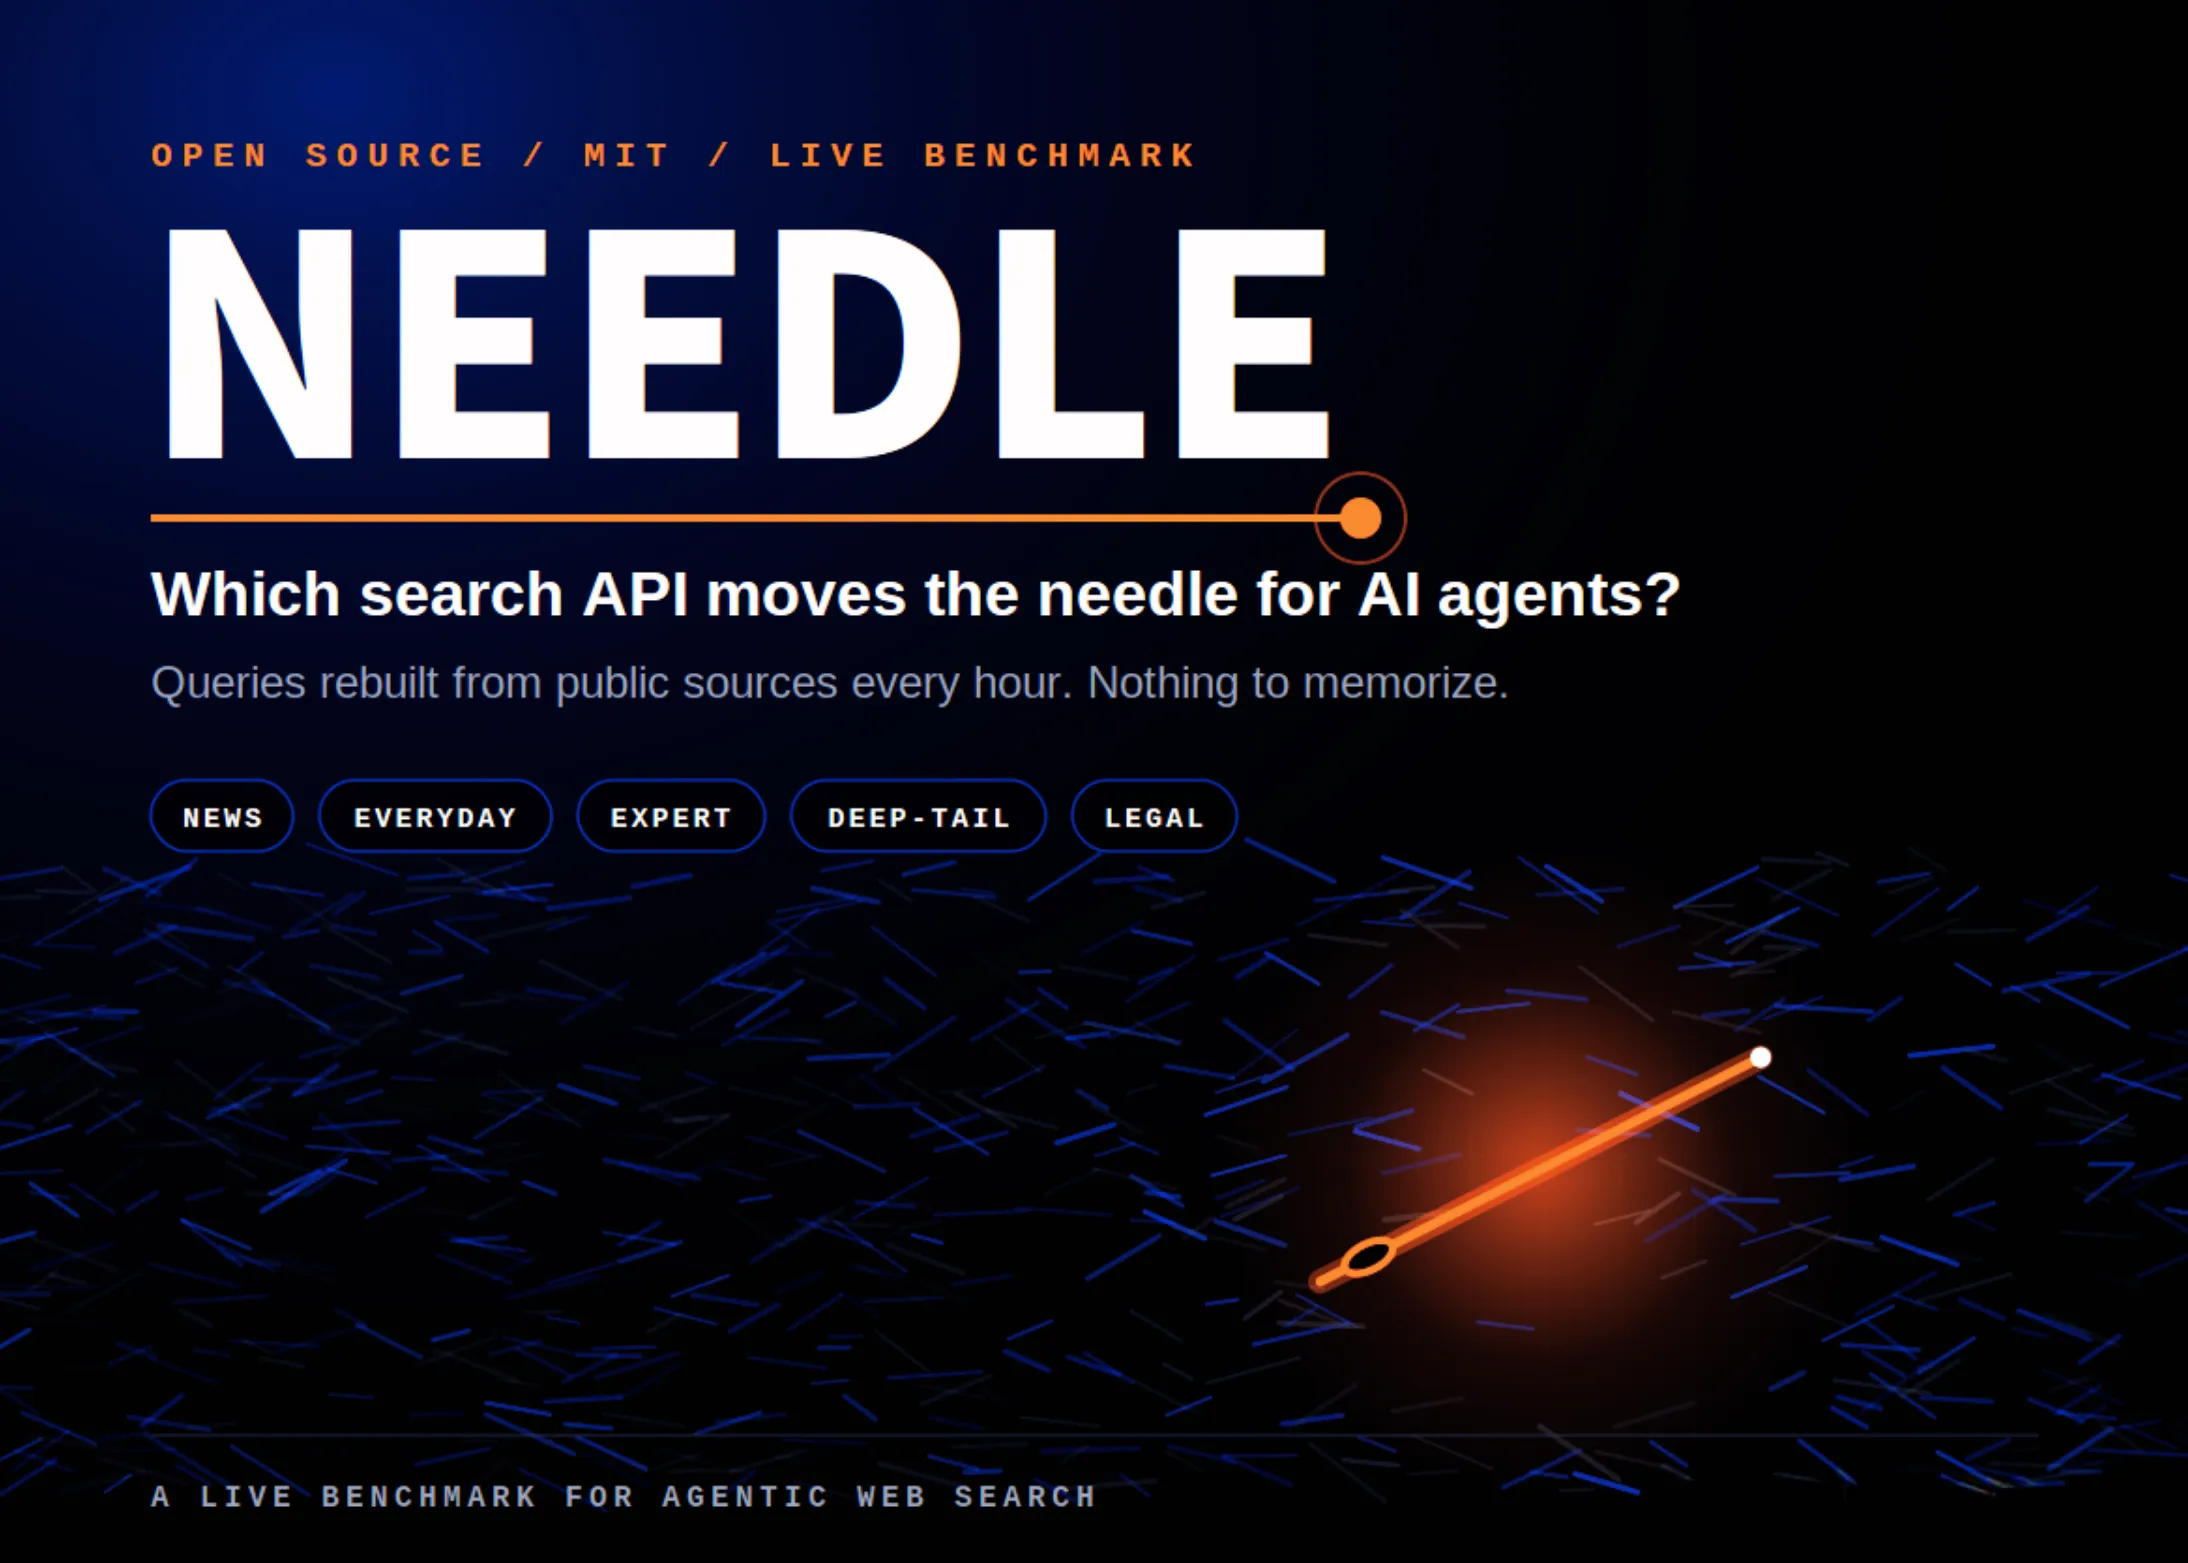
Keenable AI lansează open-source NEEDLE: un benchmark de căutare live care își reconstruiește setul de interogări în fiecare oră
Keenable AI a lansat open-source NEEDLE, un benchmark de căutare live care își reconstruiește setul de interogări în fiecare oră. Această abordare dinamică oferă o evaluare realistă a sistemelor AI, testând capacitatea lor de a se adapta la informații noi. Articolul analizează importanța acestui instrument pentru cercetarea și dezvoltarea AI.
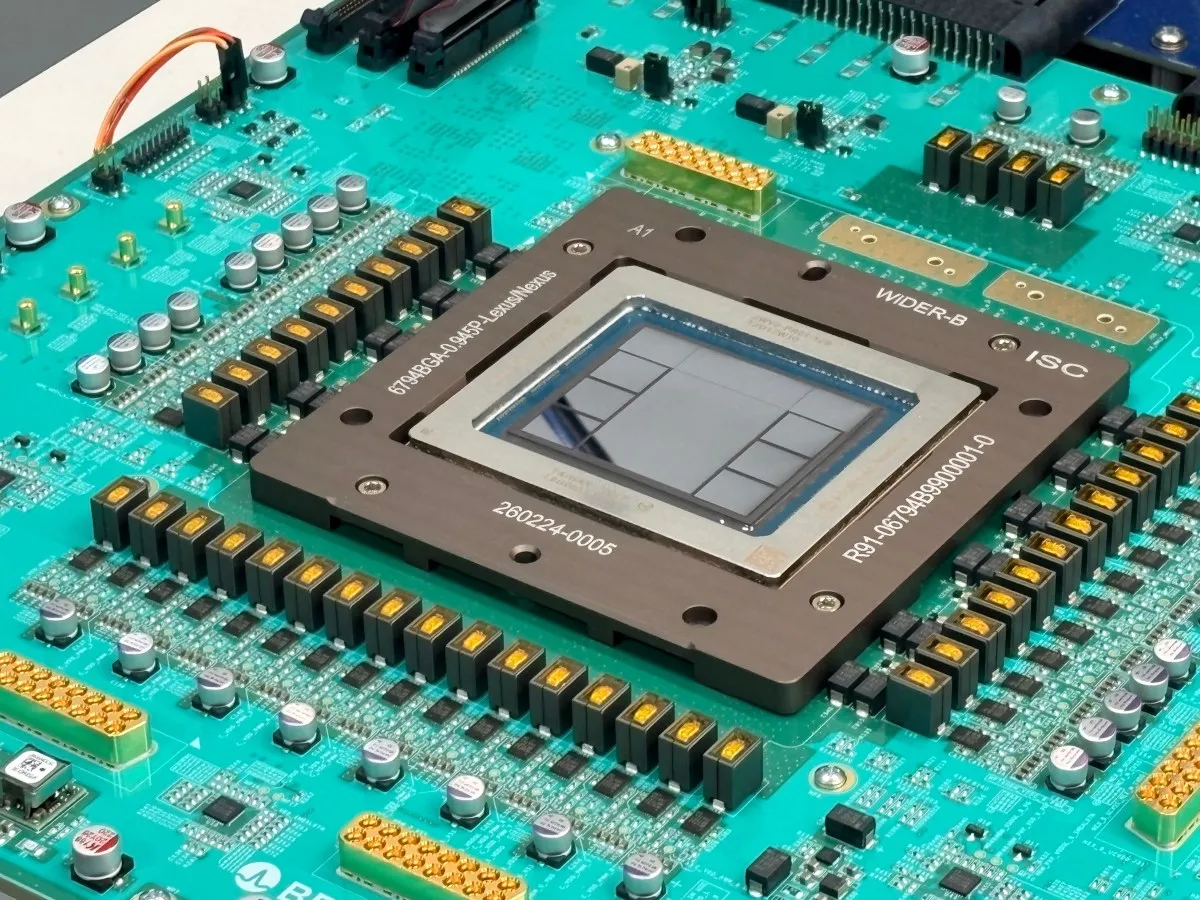
Cipul Jalapeño de la OpenAI: performanțe remarcabile la inferență, dar concurența nu doarme
OpenAI a prezentat la Hot Chips primele rezultate de benchmark pentru cipul său Jalapeño, care arată o performanță semnificativă la inferență, cu mai multe tokenuri per utilizator și mai mult throughput per kilowatt decât sistemele actuale. Cipul, dezvoltat cu Broadcom, este proiectat pentru a minimiza întârzierile în prefill și comunicare, și va fi implementat în volume mici la sfârșitul lui 2026. Această mișcare strategică ar putea schimba echilibrul de putere în industria AI.

Supabase lansează Evals: un benchmark open source care evaluează Claude Code, Codex și OpenCode pe sarcini reale Supabase
Supabase a lansat Evals, un benchmark open source care evaluează agenții AI precum Claude Code, Codex și OpenCode pe sarcini reale din ecosistemul Supabase. Rezultatele arată care model se descurcă cel mai bine la crearea de tabele, interogări SQL și politici de securitate.

Datalab Marker v2 vs MinerU, Docling și Liteparse: Analiză comparativă a performanțelor
O analiză detaliată a patru instrumente open-source de parsing de documente: Datalab Marker v2, MinerU, Docling și Liteparse. Comparăm acuratețea, viteza și consumul de resurse pentru a te ajuta să alegi soluția potrivită nevoilor tale.