Subiect: #GPU
Cipul Vera de la Nvidia: pariul de 200 de miliarde de dolari pe care Jensen Huang nu vrea să-l ignori
Nvidia a raportat venituri record, dar adevărata știre este cipul Vera, care vizează o piață de 200 de miliarde de dolari în inferență AI. CEO-ul Jensen Huang mizează pe acest procesor pentru a contracara concurența din partea Google, Amazon și Microsoft, care își construiesc propriile cipuri. Cu toate acestea, problemele de aprovizionare și scăderea acțiunilor după anunț arată că pariul este departe de a fi câștigat.
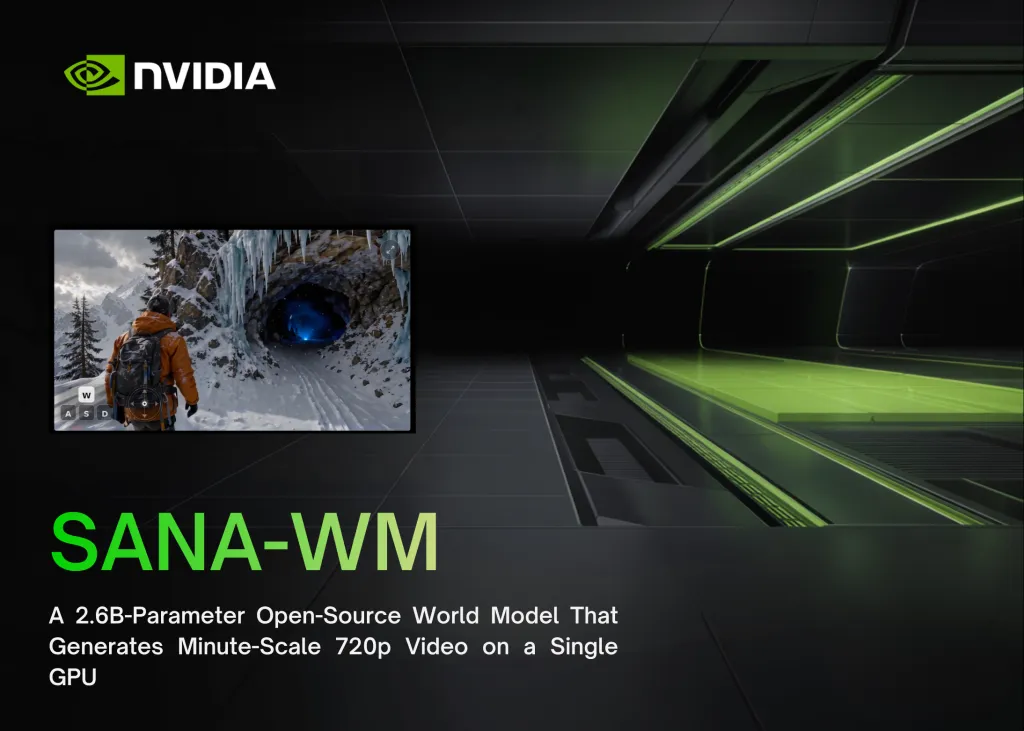
NVIDIA lansează SANA-WM: modelul mondial open-source cu 2,6 miliarde de parametri care generează videoclipuri de 720p la scară de minute pe un singur GPU
NVIDIA a lansat SANA-WM, un model mondial open-source cu 2,6 miliarde de parametri, capabil să genereze videoclipuri de 720p de până la un minut pe un singur GPU. Articolul explică tehnologia, comparațiile cu Sora, aplicațiile și impactul asupra democratizării generării video.
NVIDIA lansează cuda-oxide: un compilator experimental Rust-to-CUDA care compilează kernel-uri SIMT direct în PTX
NVIDIA a lansat cuda-oxide, un backend experimental de compilare care transformă kernel-uri SIMT scrise în Rust direct în PTX, deschizând calea către programarea GPU-urilor cu siguranța și performanța oferite de Rust.
OpenAI lansează MRC (Multipath Reliable Connection): Un nou protocol de rețea deschis pentru clusterele de antrenare AI la scară largă
OpenAI, în parteneriat cu AMD, Broadcom, Intel, Microsoft și NVIDIA, lansează MRC (Multipath Reliable Connection), un protocol de rețea deschis care îmbunătățește performanța și reziliența clusterelor de antrenare AI, permițând distribuirea pachetelor pe sute de căi simultan și recuperarea în microsecunde după defecțiuni.
ScaleOps atrage 130 de milioane de dolari pentru a revoluționa eficiența computațională în era cererii masive pentru AI
Startup-ul ScaleOps a ridicat 130 de milioane de dolari într-o rundă Series C, evaluând compania la 800 de milioane de dolari, pentru a aborda ineficiența critică din infrastructura AI. Fondat de un fost inginer Run:ai, ScaleOps oferă o soluție software autonomă care promite reducerea costurilor cloud cu până la 80%, gestionând în timp real resursele precum GPU-urile, memoria și rețelele pentru giganți precum Adobe și Salesforce.
Inferență rapidă cu LoRA pentru Flux utilizând Diffusers și PEFT: Ghid complet de optimizare
Un ghid tehnic detaliat despre optimizarea inferenței modelului Flux.1-Dev folosind LoRA, Diffusers și PEFT, acoperind strategii de la hotswapping fără recompilare până la rularea eficientă pe GPU-uri de consum precum RTX 4090.
Accelerate ND-Parallel: Ghid complet pentru antrenarea eficientă pe mai multe GPU-uri
Pe măsură ce modelele de inteligență artificială cresc la dimensiuni de zeci sau sute de miliarde de parametri, provocarea principală devine gestionarea memoriei și comunicarea între dispozitive. Acest ghid explorează strategiile de paralelism — de la Data Parallelism la tehnici avansate precum Tensor Parallelism și Fully Sharded Data Parallelism — oferind o perspectivă detaliată asupra modului în care acestea pot fi combinate pentru a optimiza antrenarea modelelor la scară largă.
Optimizarea spațiilor ZeroGPU prin compilarea ahead-of-time: Ghid complet pentru performanță maximă
Compilarea ahead-of-time (AoT) revoluționează performanța modelelor ML în spațiile ZeroGPU de la Hugging Face, eliminând timpii de pornire la rece și oferind accelerări de 1.3×-1.8×. Acest ghid detaliază implementarea tehnică, de la capturarea intrărilor până la integrarea în pipeline, explorând și tehnici avansate precum cuantizarea FP8 și FlashAttention-3.
Trucuri de la OpenAI gpt-oss pe care TU 🫵 le poți utiliza cu transformers
Lansarea GPT-OSS de la OpenAI aduce o serie de inovații tehnice în ecosistemul open-source. Acest articol explorează integrarea acestora în biblioteca `transformers`, de la kernel-e zero-build și Flash Attention 3, până la cuantizarea MXFP4 și paralelismul tensorial, oferind un ghid detaliat pentru optimizarea inferenței modelelor de limbaj de mari dimensiuni.
Construirea și Partajarea Simplă a Kernel-elor ROCm prin Ecosistemul Hugging Face
Acest ghid detaliat explorează modul în care dezvoltatorii pot construi și partaja kernel-uri ROCm de înaltă performanță folosind ecosistemul Hugging Face. Focalizându-se pe exemplul kernel-ului GEMM RadeonFlow, câștigătorul premiului AMD Developer Challenge 2025, articolul explică structura proiectului, configurarea fișierelor de build și integrarea nativă în PyTorch, simplificând procesul complex de optimizare pe GPU-urile AMD.