Subiect: #MoE

Kimi K3 vs DeepSeek V4 Pro vs GLM-5.2: Comparație între modelele MoE de scară trilionară – benchmark-uri, licențe și costuri de servire
Comparație detaliată între trei modele MoE de scară trilionară: Kimi K3, DeepSeek V4 Pro și GLM-5.2. Analizăm benchmark-uri, licențe și costuri de servire pentru a te ajuta să alegi cel mai potrivit model pentru proiectele tale.
Thinking Machines Lab lansează Inkling: un model multimodal MoE cu 975 de miliarde de parametri, 41 de miliarde activi și efort de gândire controlabil
Thinking Machines Lab a lansat Inkling, un model AI deschis cu 975 de miliarde de parametri, 41 de miliarde activi și efort de gândire controlabil. Disponibil sub licență Apache 2.0, Inkling se poziționează ca o bază de personalizare, nu ca cel mai puternic model, oferind transparență și flexibilitate comunității.

Consorțiul Soofi lansează Soofi S 30B-A3B: un model fundamental hibrid Mamba-Transformer MoE, open-source, pentru germană și engleză
Consorțiul Soofi a lansat Soofi S 30B-A3B, un model fundamental open-source hibrid Mamba-Transformer MoE, specializat pentru limbile germană și engleză. Cu 30 de miliarde de parametri totali și doar 3 miliarde activi per inferență, oferă performanță ridicată la costuri reduse, fiind ideal pentru cercetători și companii.

Nemotron Labs 3 Puzzle 75B A9B: Un model lingvistic hibrid MoE comprimat care oferă o performanță de 2,03 ori mai mare pe server
Nemotron Labs a lansat modelul lingvistic Nemotron Labs 3 Puzzle 75B A9B, un LLM hibrid MoE comprimat care oferă o creștere de 2,03 ori a debitului pe server, permițând rularea pe un singur GPU și reducând costurile de infrastructură.
NVIDIA lansează Nemotron-Labs-3-Puzzle-75B-A9B: un model lingvistic hibrid MoE comprimat care oferă o performanță de server de 2,03 ori mai mare la același debit per utilizator
NVIDIA a lansat Nemotron-Labs-3-Puzzle-75B-A9B, un model lingvistic hibrid MoE comprimat, care oferă o performanță de server de 2,03 ori mai mare decât predecesorul său, la același debit per utilizator. Modelul folosește o tehnică inovatoare de compresie structurală iterativă, reducând parametrii de la 120,7B la 75,3B, și permite o concurență de 8 ori mai mare pe un singur GPU H100.

Tencent lansează Hy3: un model MoE deschis cu 295 de miliarde de parametri, 21 de miliarde activi și context de 256K
Tencent a lansat Hy3, un model open-source de tip Mixture-of-Experts cu 295 de miliarde de parametri, dintre care doar 21 de miliarde sunt activi, și o fereastră de context de 256.000 de tokeni. Modelul promite eficiență și accesibilitate pentru cercetători și dezvoltatori din întreaga lume.

Meituan lansează LongCat-2.0: Un model MoE deschis cu 1,6 trilioane de parametri și context nativ de 1 milion de tokeni
Meituan a lansat LongCat-2.0, un model MoE open-source cu 1,6 trilioane de parametri și context nativ de 1 milion de tokeni, folosind atenția rară LongCat. Este un pas major spre democratizarea AI-ului de ultimă generație.
Prime Intellect lansează prime-rl 0.6.0: un cadru deschis pentru antrenarea modelelor MoE de trilioane de parametri prin învățare prin întărire agentică
Prime Intellect a lansat prime-rl 0.6.0, un cadru open-source pentru învățare prin întărire asincronă pe modele MoE de trilioane de parametri. Cu optimizări precum inferența FP8, paralelism expert larg și disociere prefill/decode, a antrenat GLM-5 pe sarcini SWE cu performanțe remarcabile pe doar 28 de noduri H200.
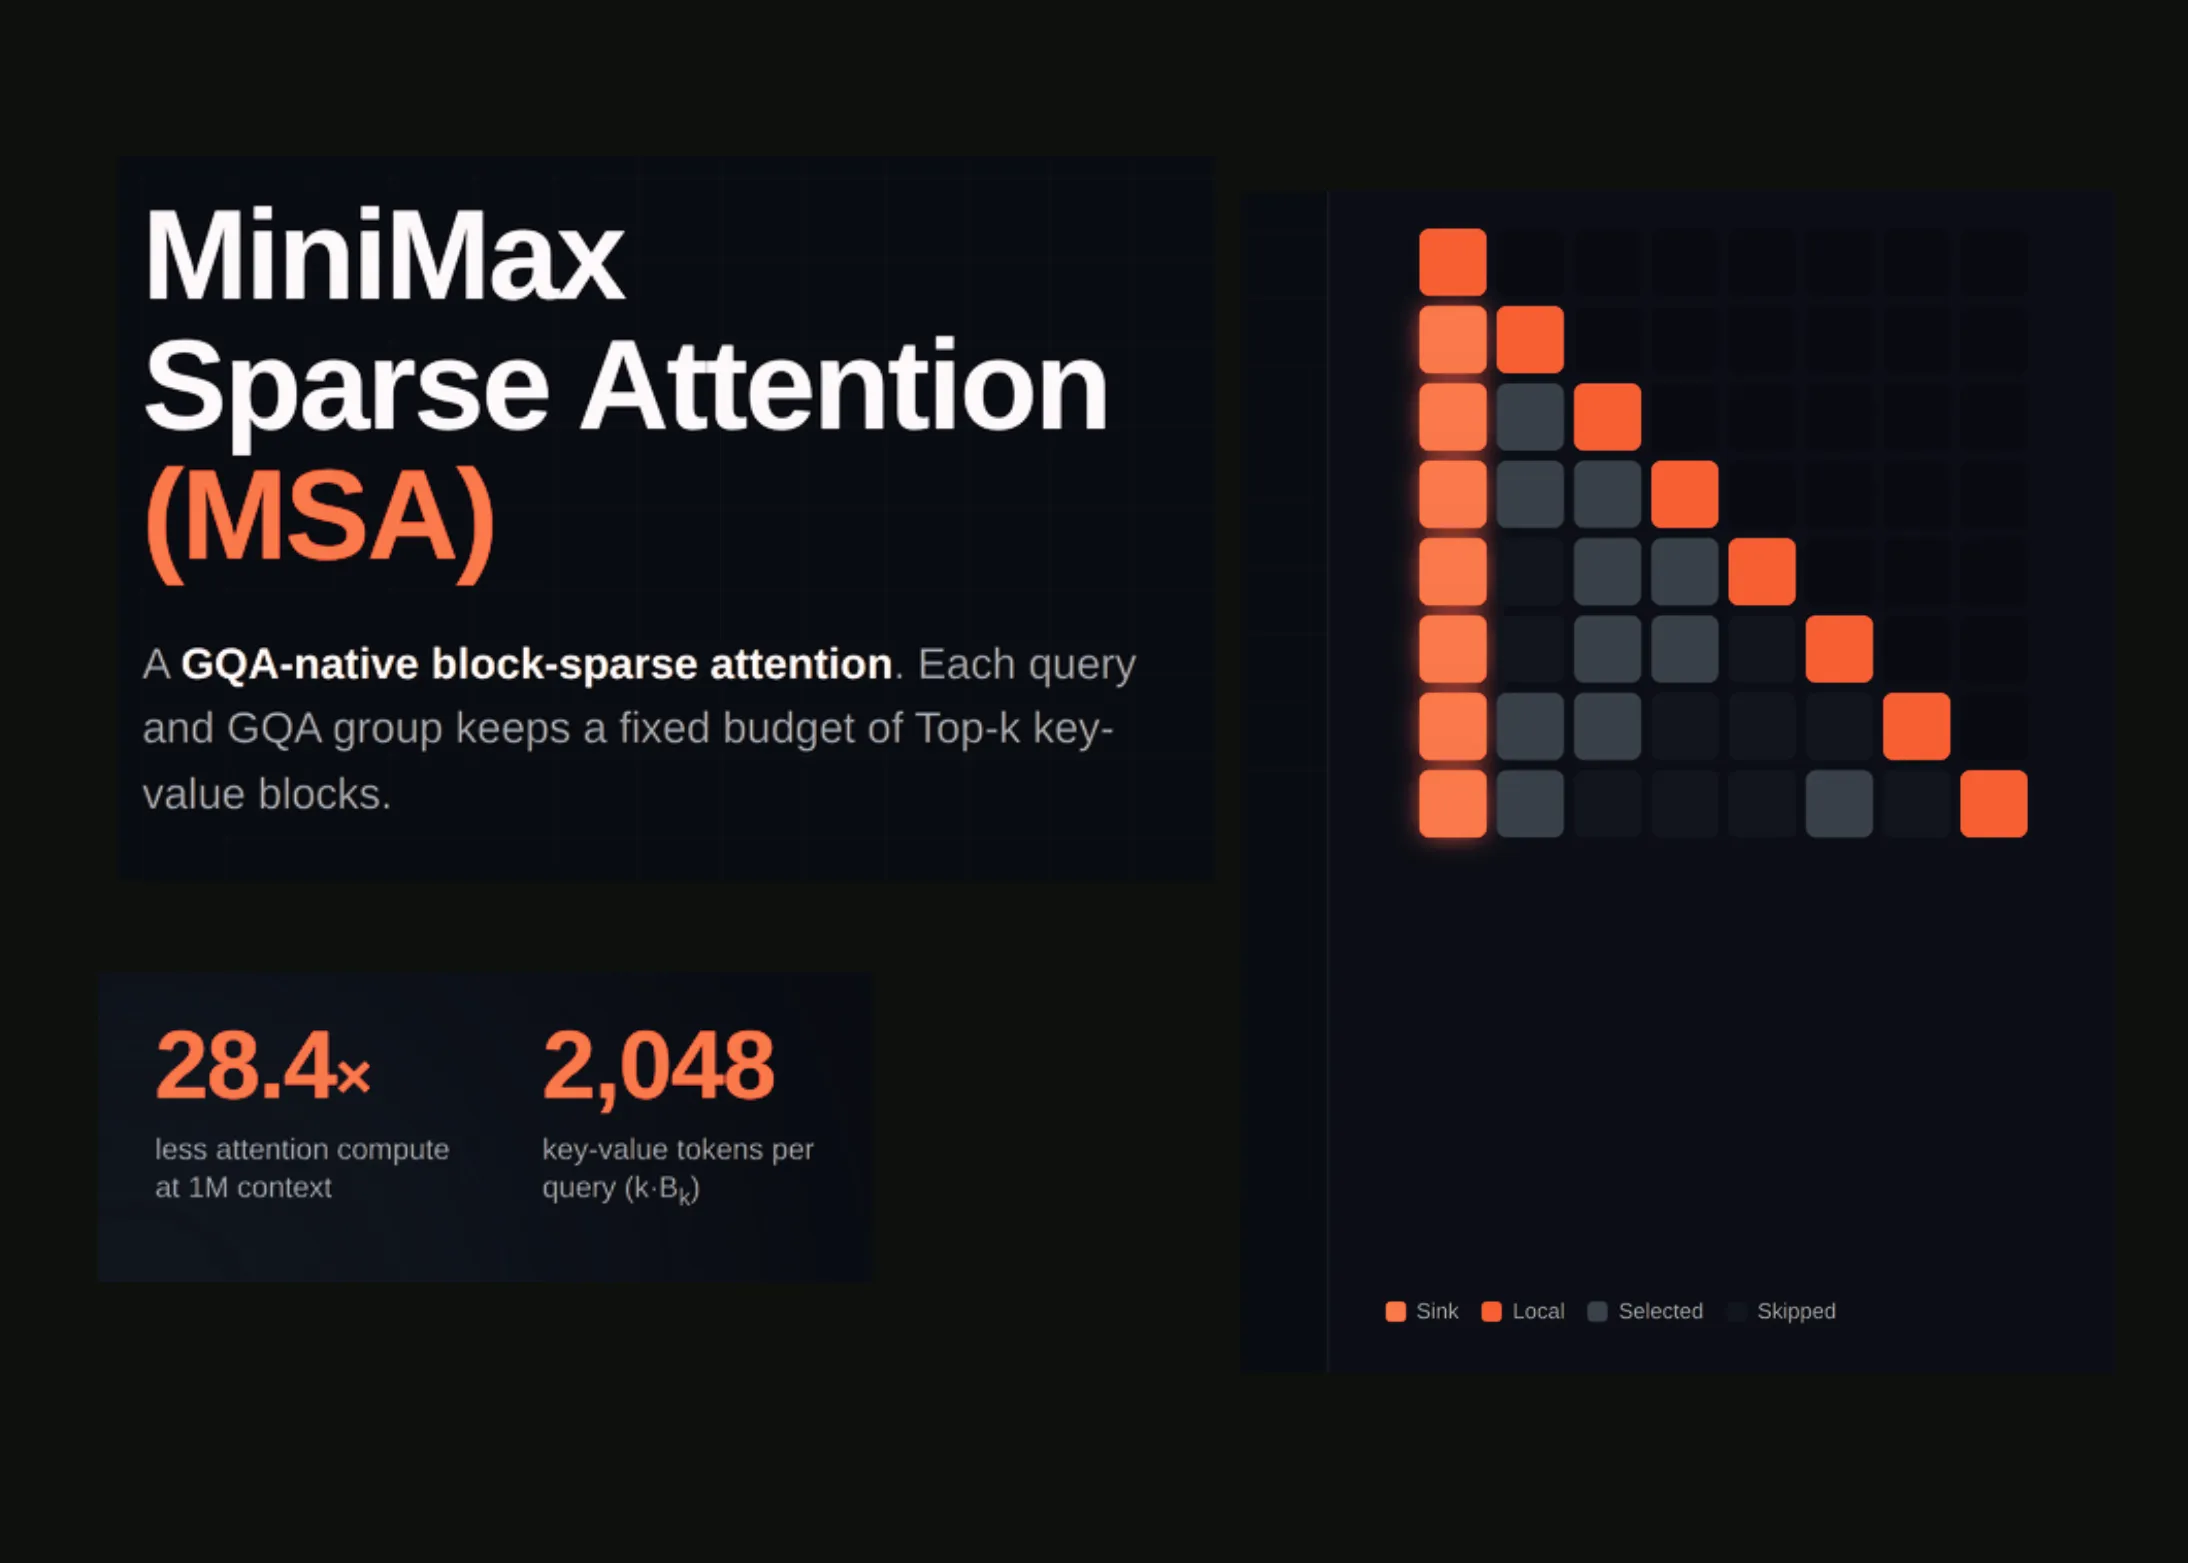
MiniMax Sparse Attention (MSA): O Revoluție în Atenția Dispersată cu Două Ramuri, Antrenată pe un Model MoE de 109 Miliarde de Parametri cu un Buget de 3 Tiloane de Token-uri
MiniMax Sparse Attention (MSA) este o arhitectură inovatoare de atenție dispersată cu două ramuri, antrenată pe un model MoE de 109 miliarde de parametri cu un buget de 3 trilioane de token-uri. MSA combină atenția locală și globală pentru a reduce costul computațional, permițând modelelor să gestioneze contexte mai lungi eficient. Această tehnologie ar putea democratiza accesul la AI și permite aplicații noi.
JetBrains lansează Mellum2: modelul de 12 miliarde de parametri care promite să schimbe regulile jocului în conductele AI multimodel
JetBrains a lansat Mellum2, un model MoE de 12 miliarde de parametri, conceput pentru sarcini rapide și specializate în conductele AI multimodel. Articolul analizează arhitectura, poziționarea competitivă și impactul asupra dezvoltatorilor.
Liquid AI lansează LFM2.5-8B-A1B: Un model MoE pentru dispozitive cu 8,3 miliarde de parametri totali și doar 1,5 miliarde activi
Liquid AI a lansat LFM2.5-8B-A1B, un model MoE cu 8,3 miliarde de parametri totali și doar 1,5 miliarde activi, optimizat pentru rulare pe dispozitive. Articolul explică arhitectura, beneficiile pentru edge computing și impactul asupra confidențialității și performanței.
Cohere lansează Command A+: Un model MoE de 218B parametri pentru fluxuri de lucru agentice, care rulează pe doar două GPU-uri H100
Cohere lansează Command A+, un model de 218 miliarde de parametri cu arhitectură Mixture of Experts, capabil să ruleze pe doar două GPU-uri H100. Modelul este optimizat pentru fluxuri de lucru agentice, stabilind noi recorduri de performanță și democratizând accesul la AI avansat.