Subiect: #MoE
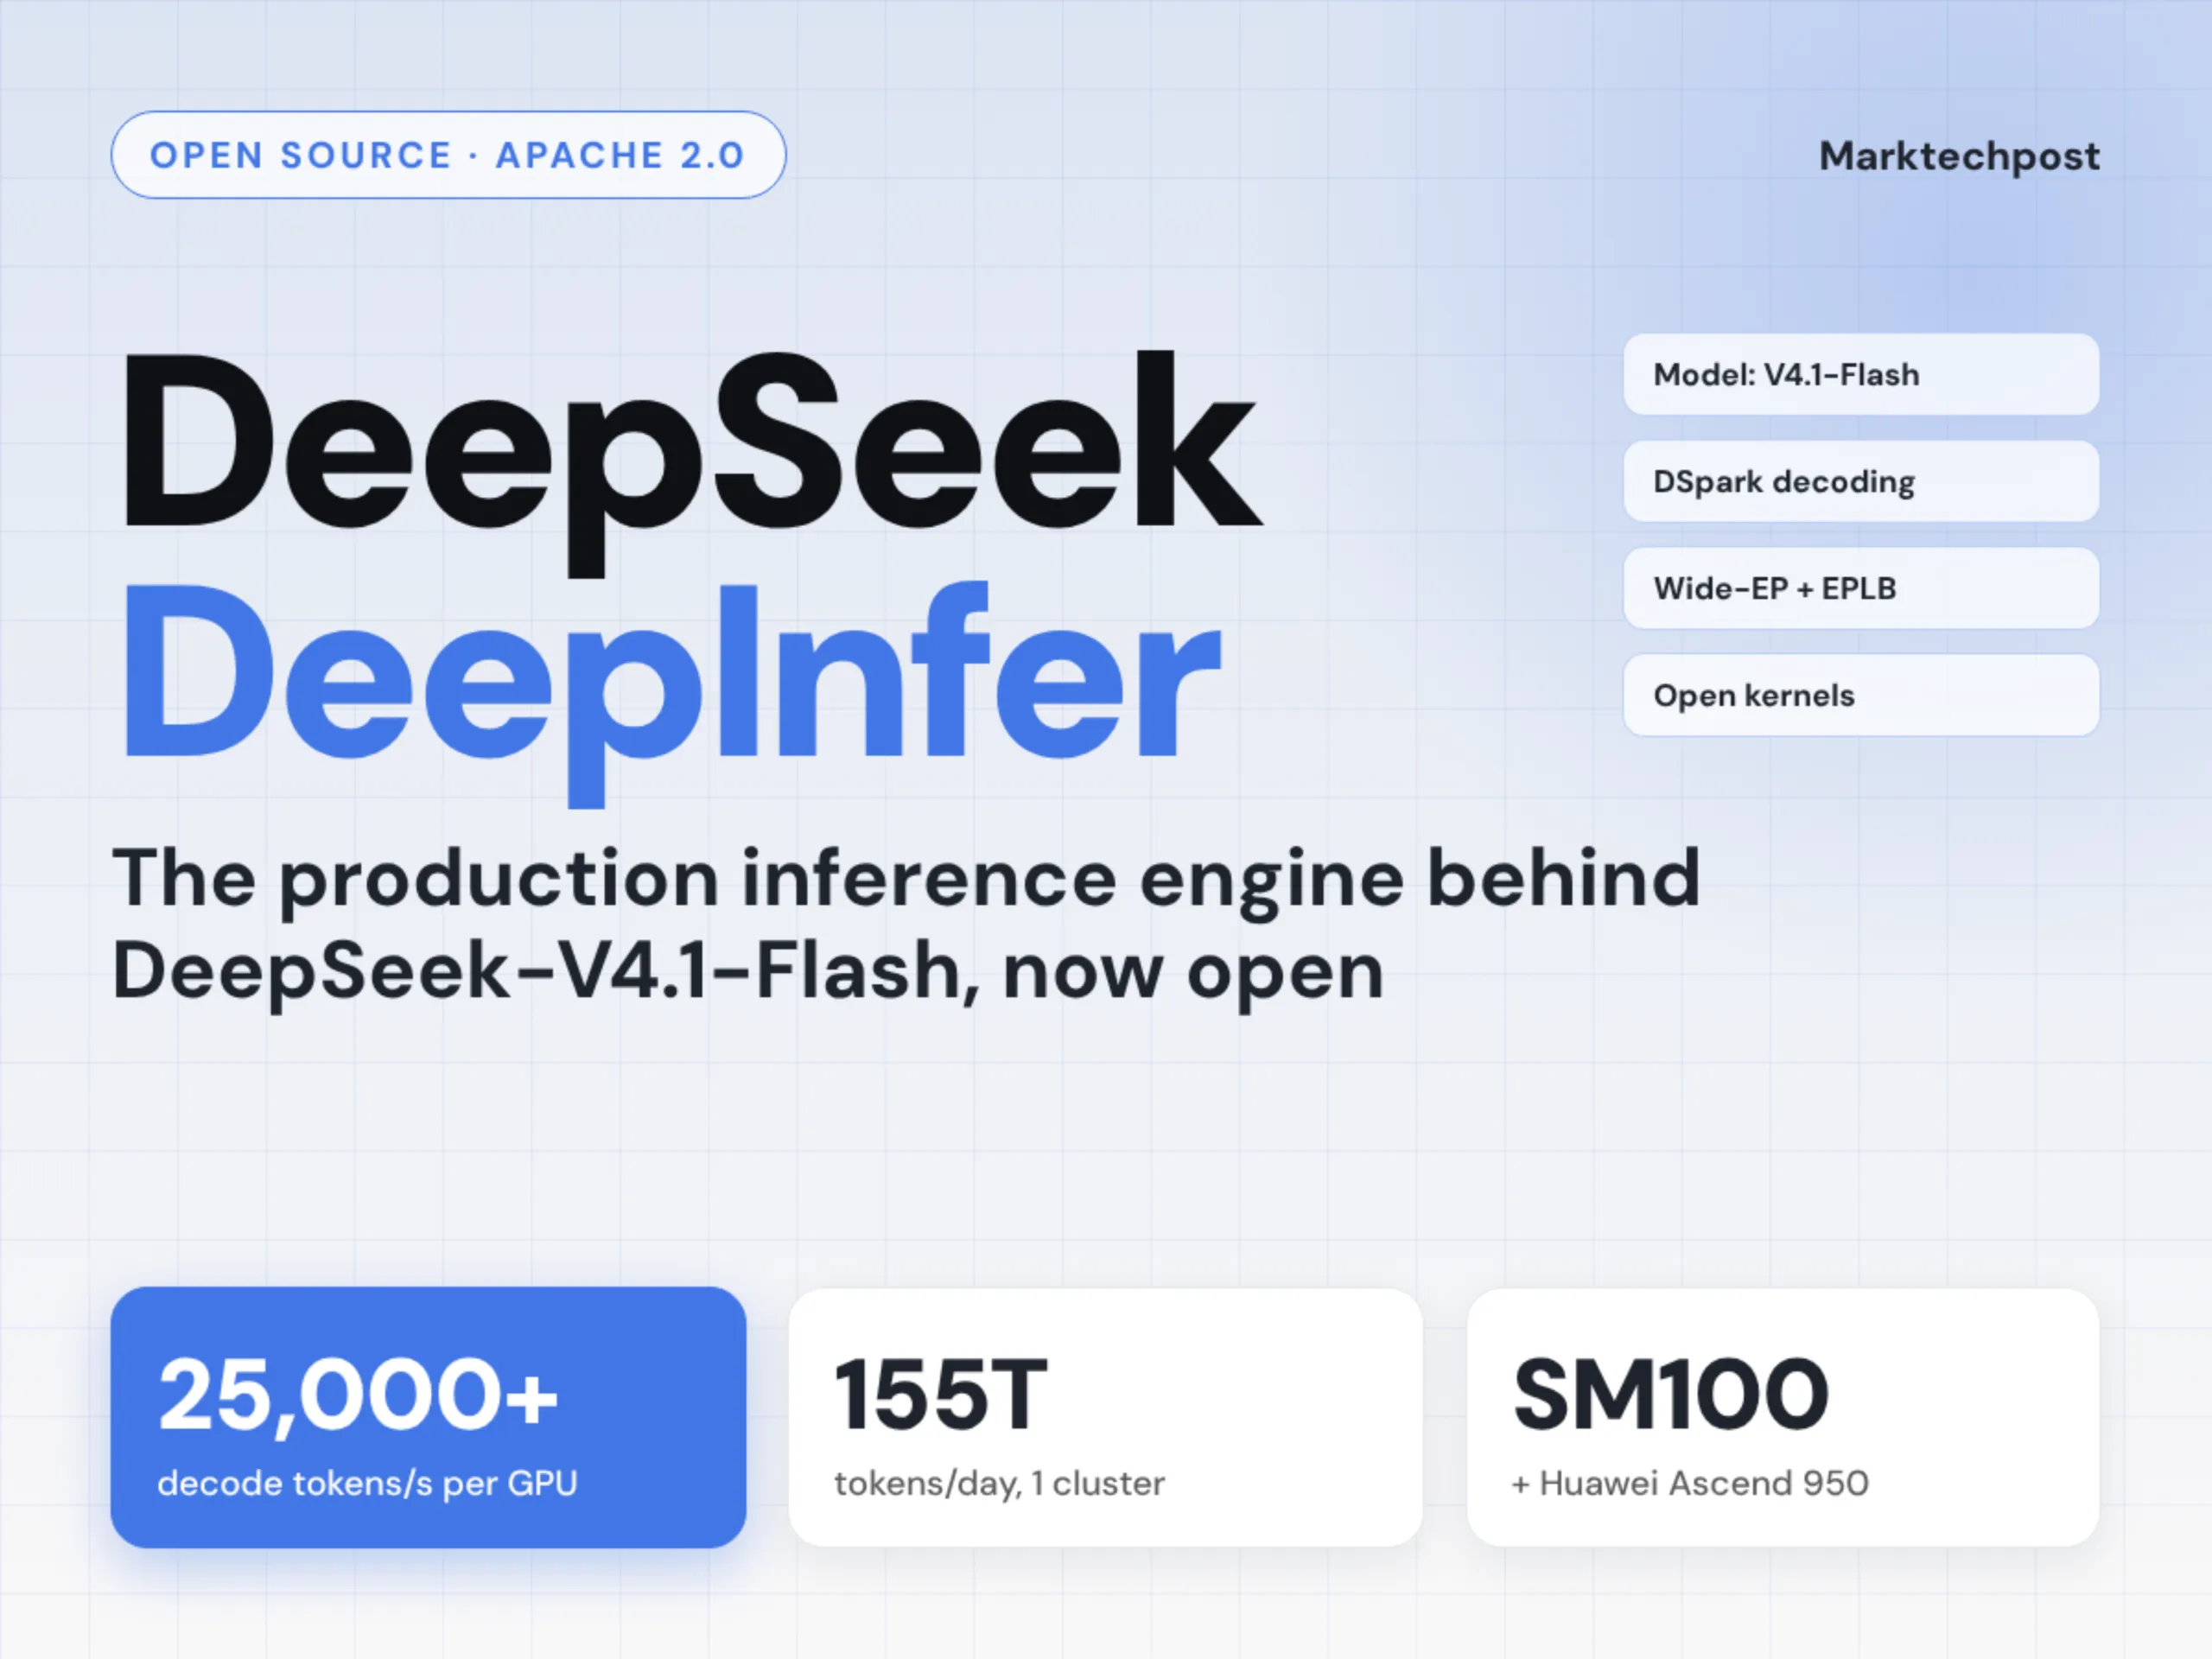
DeepSeek deschide codul sursă al framework-ului DeepInfer: motorul invizibil care alimentează V4.1-Flash și schimbă regulile jocului în inferența AI
DeepSeek lansează DeepInfer open-source: framework-ul de inferență care alimentează V4.1-Flash și reduce costurile de 3-5x pe hardware commoditizat. O analiză profundă a arhitecturii, a implicațiilor geopolitice și a oportunităților pentru dezvoltatorii europeni.
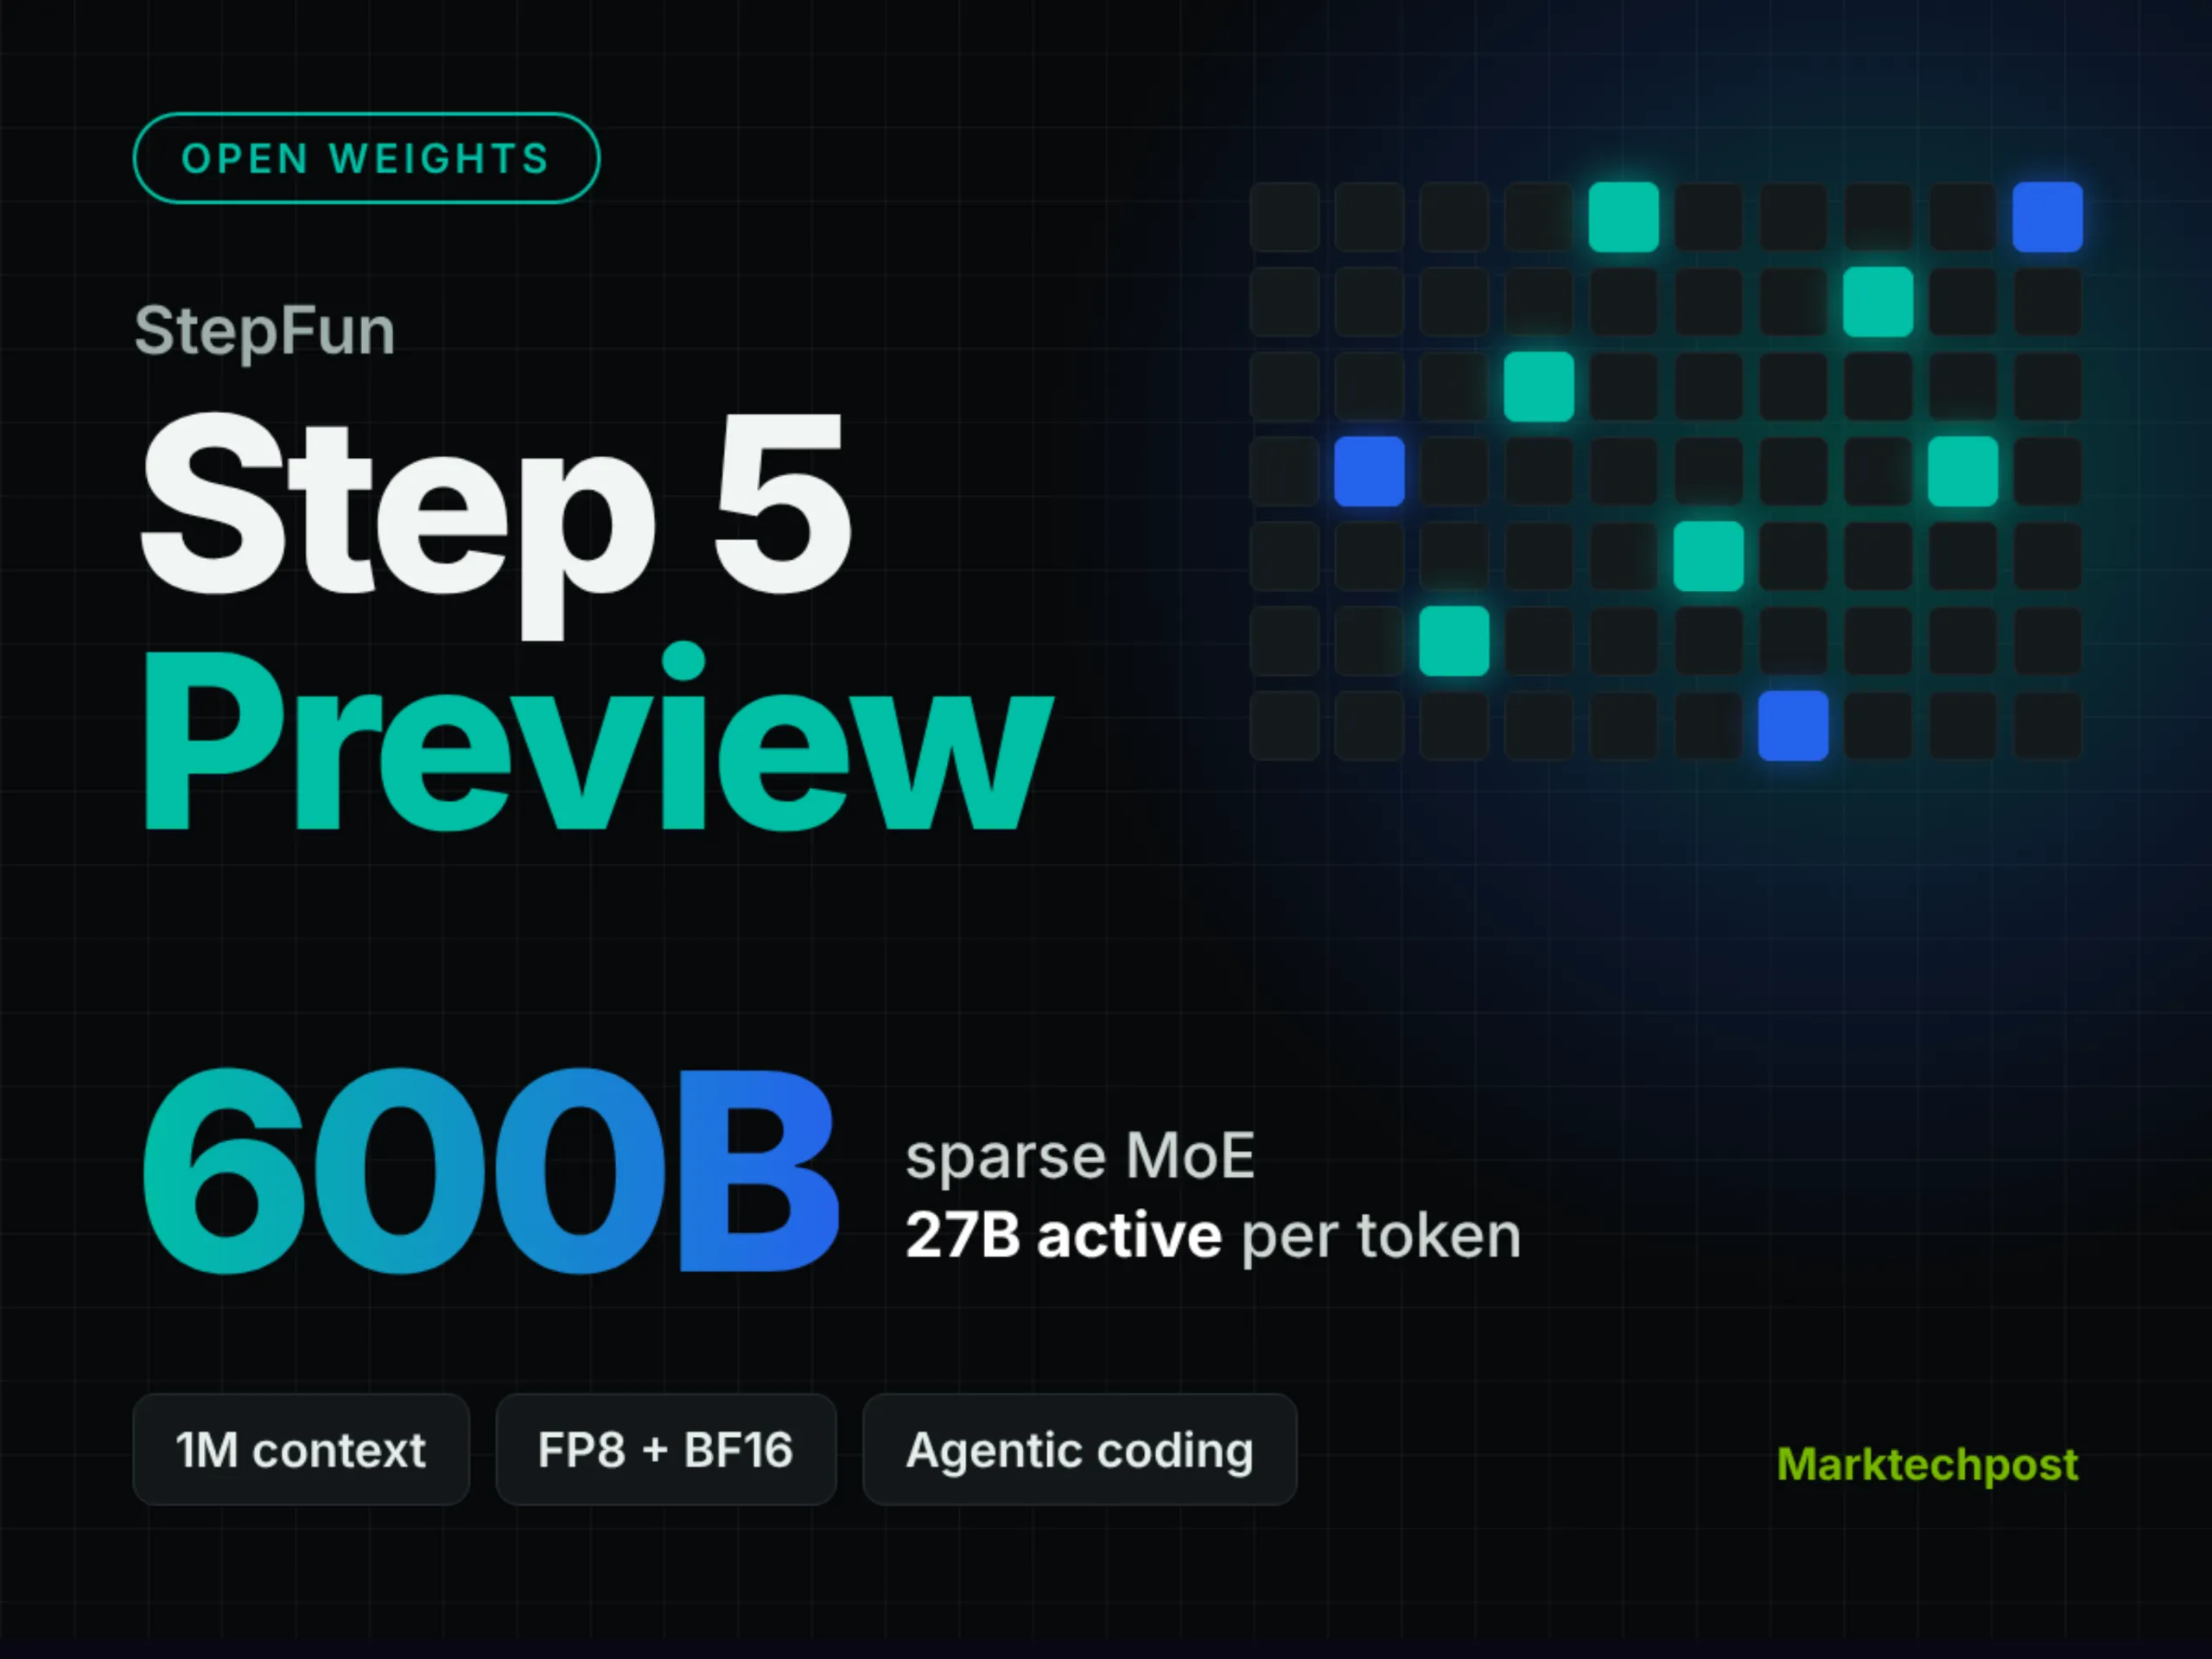
StepFun lansează Step 5 Preview cu ponderi deschise: 600 miliarde de parametri MoE, 27 miliarde activi și context de 1 milion de token-uri
StepFun, compania chineză de inteligență artificială, a lansat varianta preliminară a modelului Step 5 cu ponderi deschise. Modelul de tip Mixture of Experts dispune de 600 de miliarde de parametri totali, 27 de miliarde activi și o fereastră de context impresionantă de 1 milion de token-uri, poziționându-se ca un competitor serios în ecosistemul open-source.
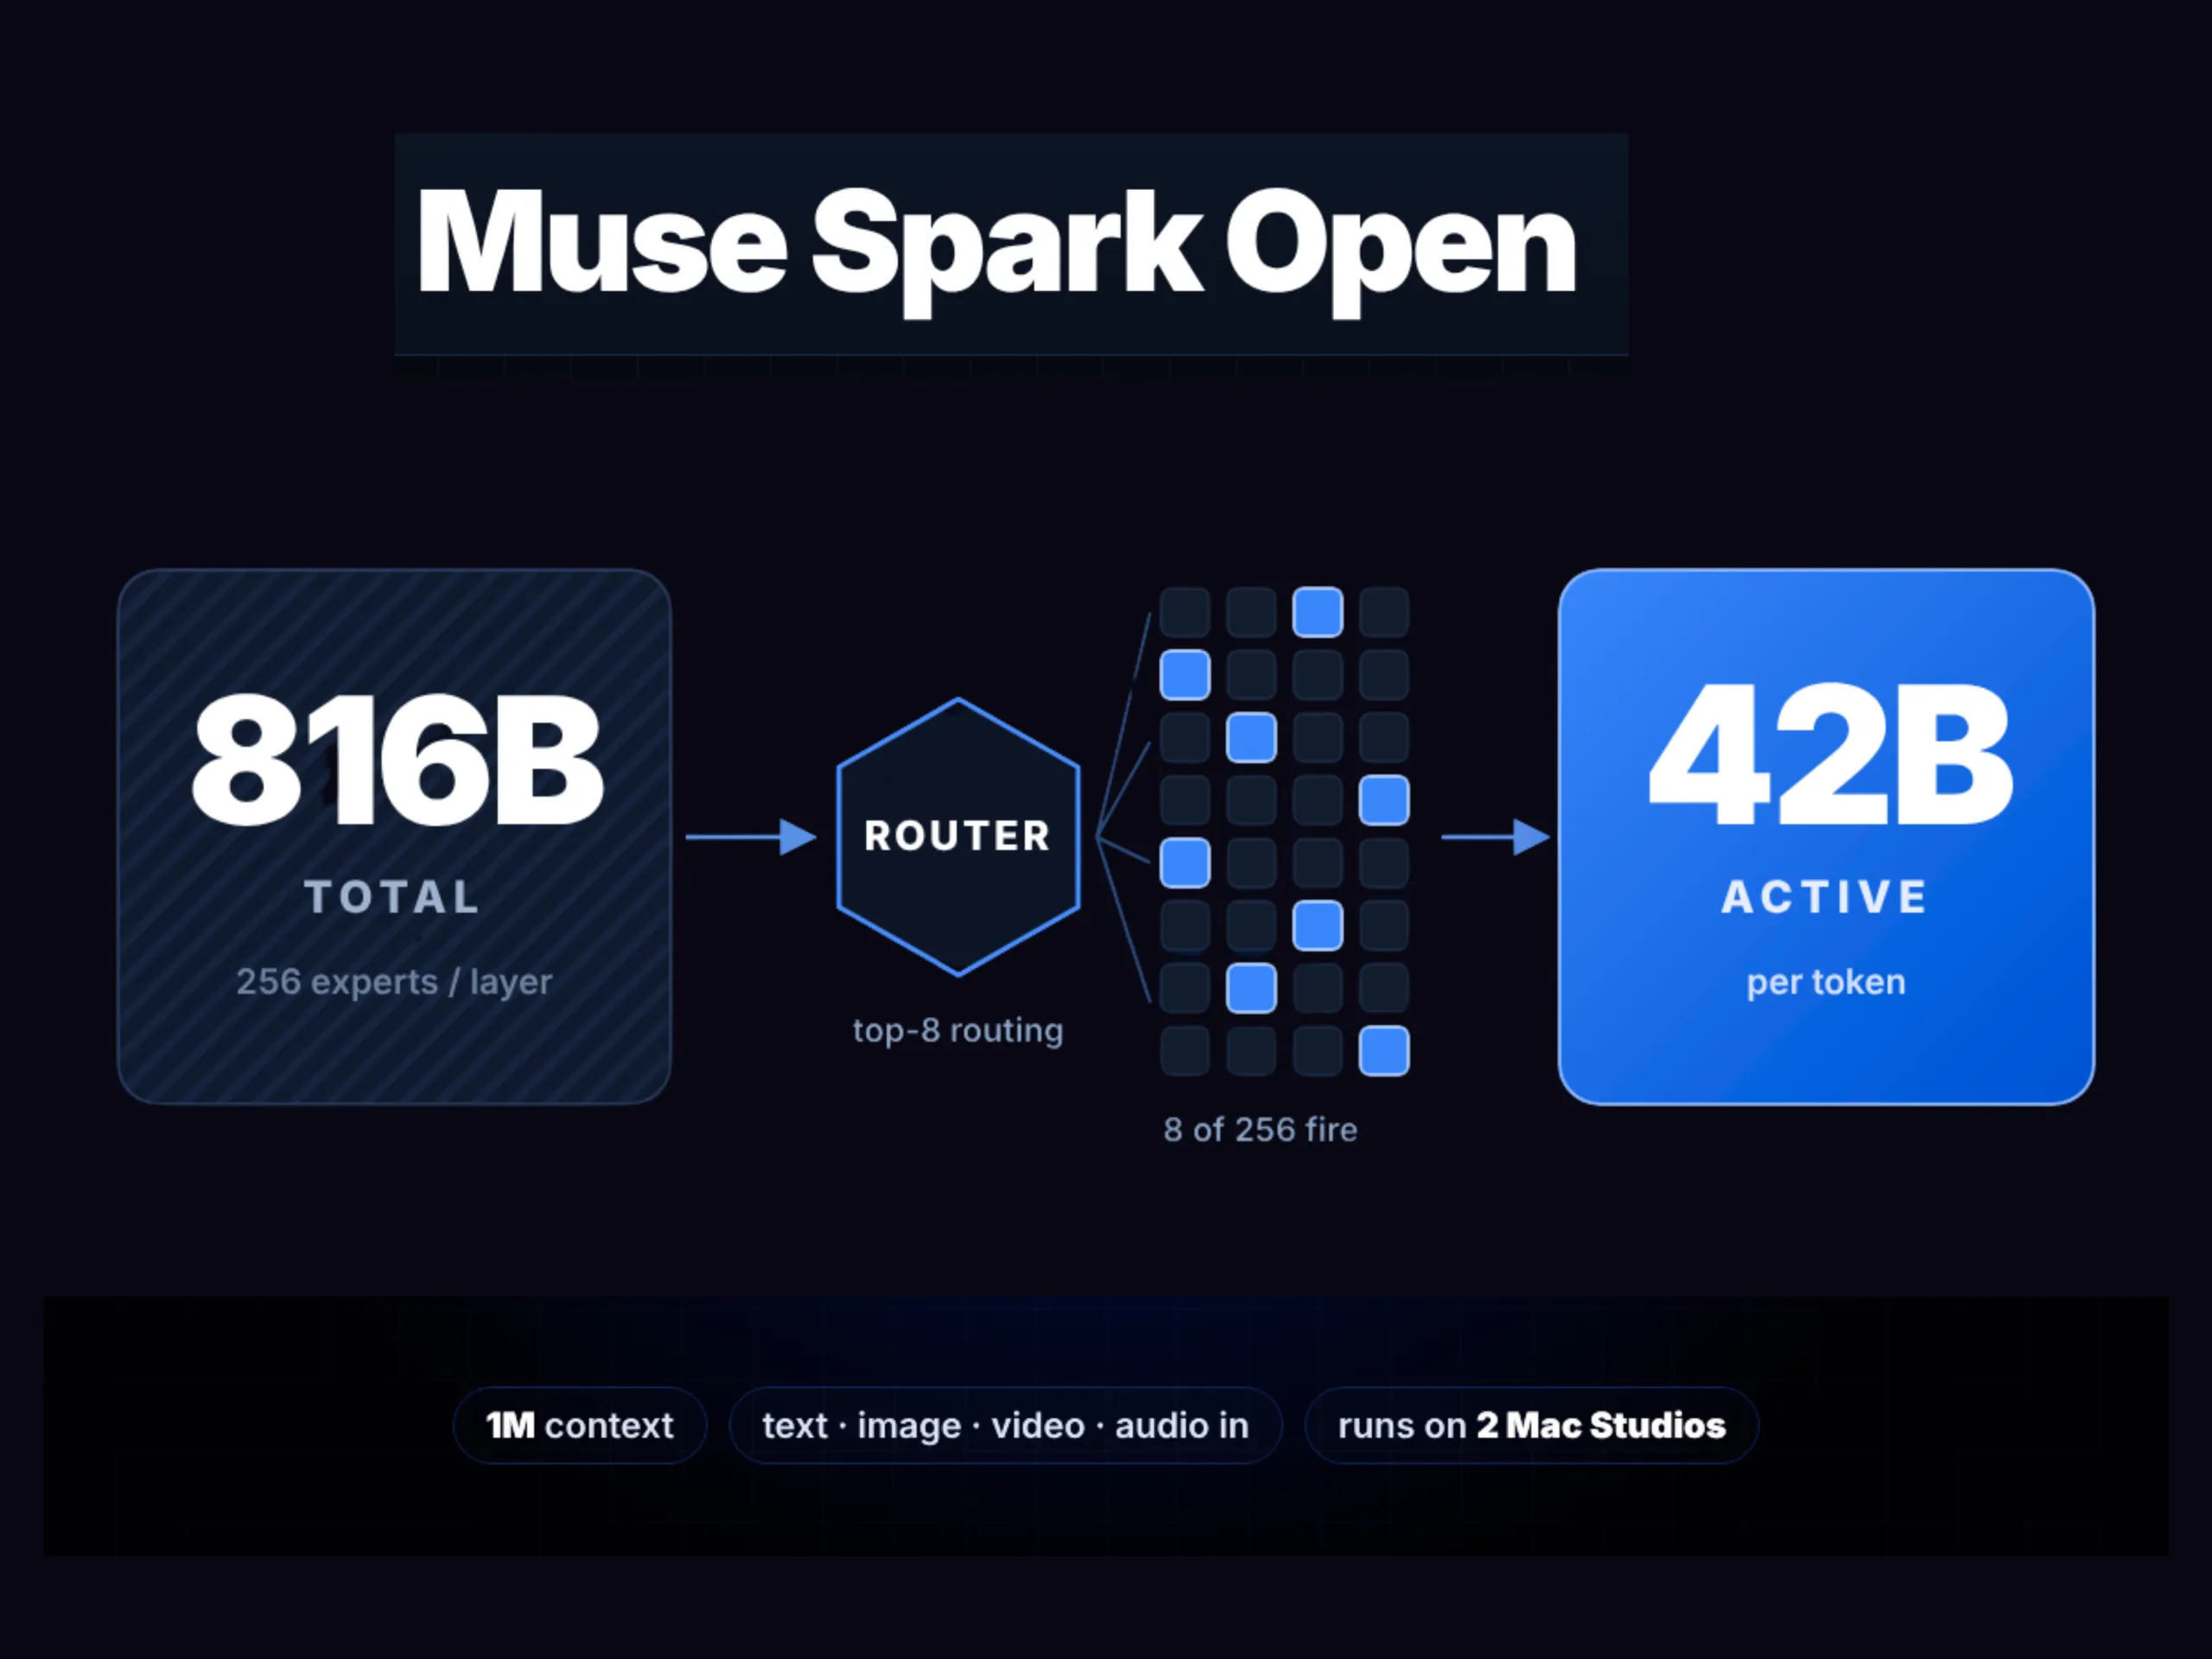
Meta lansează Muse Spark Open: un colos de 816 miliarde de parametri cu fereastră de context de 1 milion de token-uri
Meta a lansat Muse Spark Open, un model MoE cu 816 miliarde de parametri și fereastră de context de 1 milion de token-uri, disponibil cu acces deschis. Articolul analizează implicațiile tehnice, strategice ale acestei mutări în contextul cursei globale pentru supremația AI.
Fish Audio lansează Drama 3: modelul TTS cu 35 de miliarde de parametri care zguduie piața de voce artificială
Fish Audio lansează Drama 3, un model TTS cu 35 de miliarde de parametri, arhitectură MoE și greutăți deschise publicului. Calitate de nivel ElevenLabs, suport pentru limba română și oportunități majore pentru dezvoltatorii independenți.
Liquid AI lansează LFM2.5-24B-A2B: modelul MoE cu doar 2 miliarde de parametri activi care vrea să cucerească dispozitivele noastre
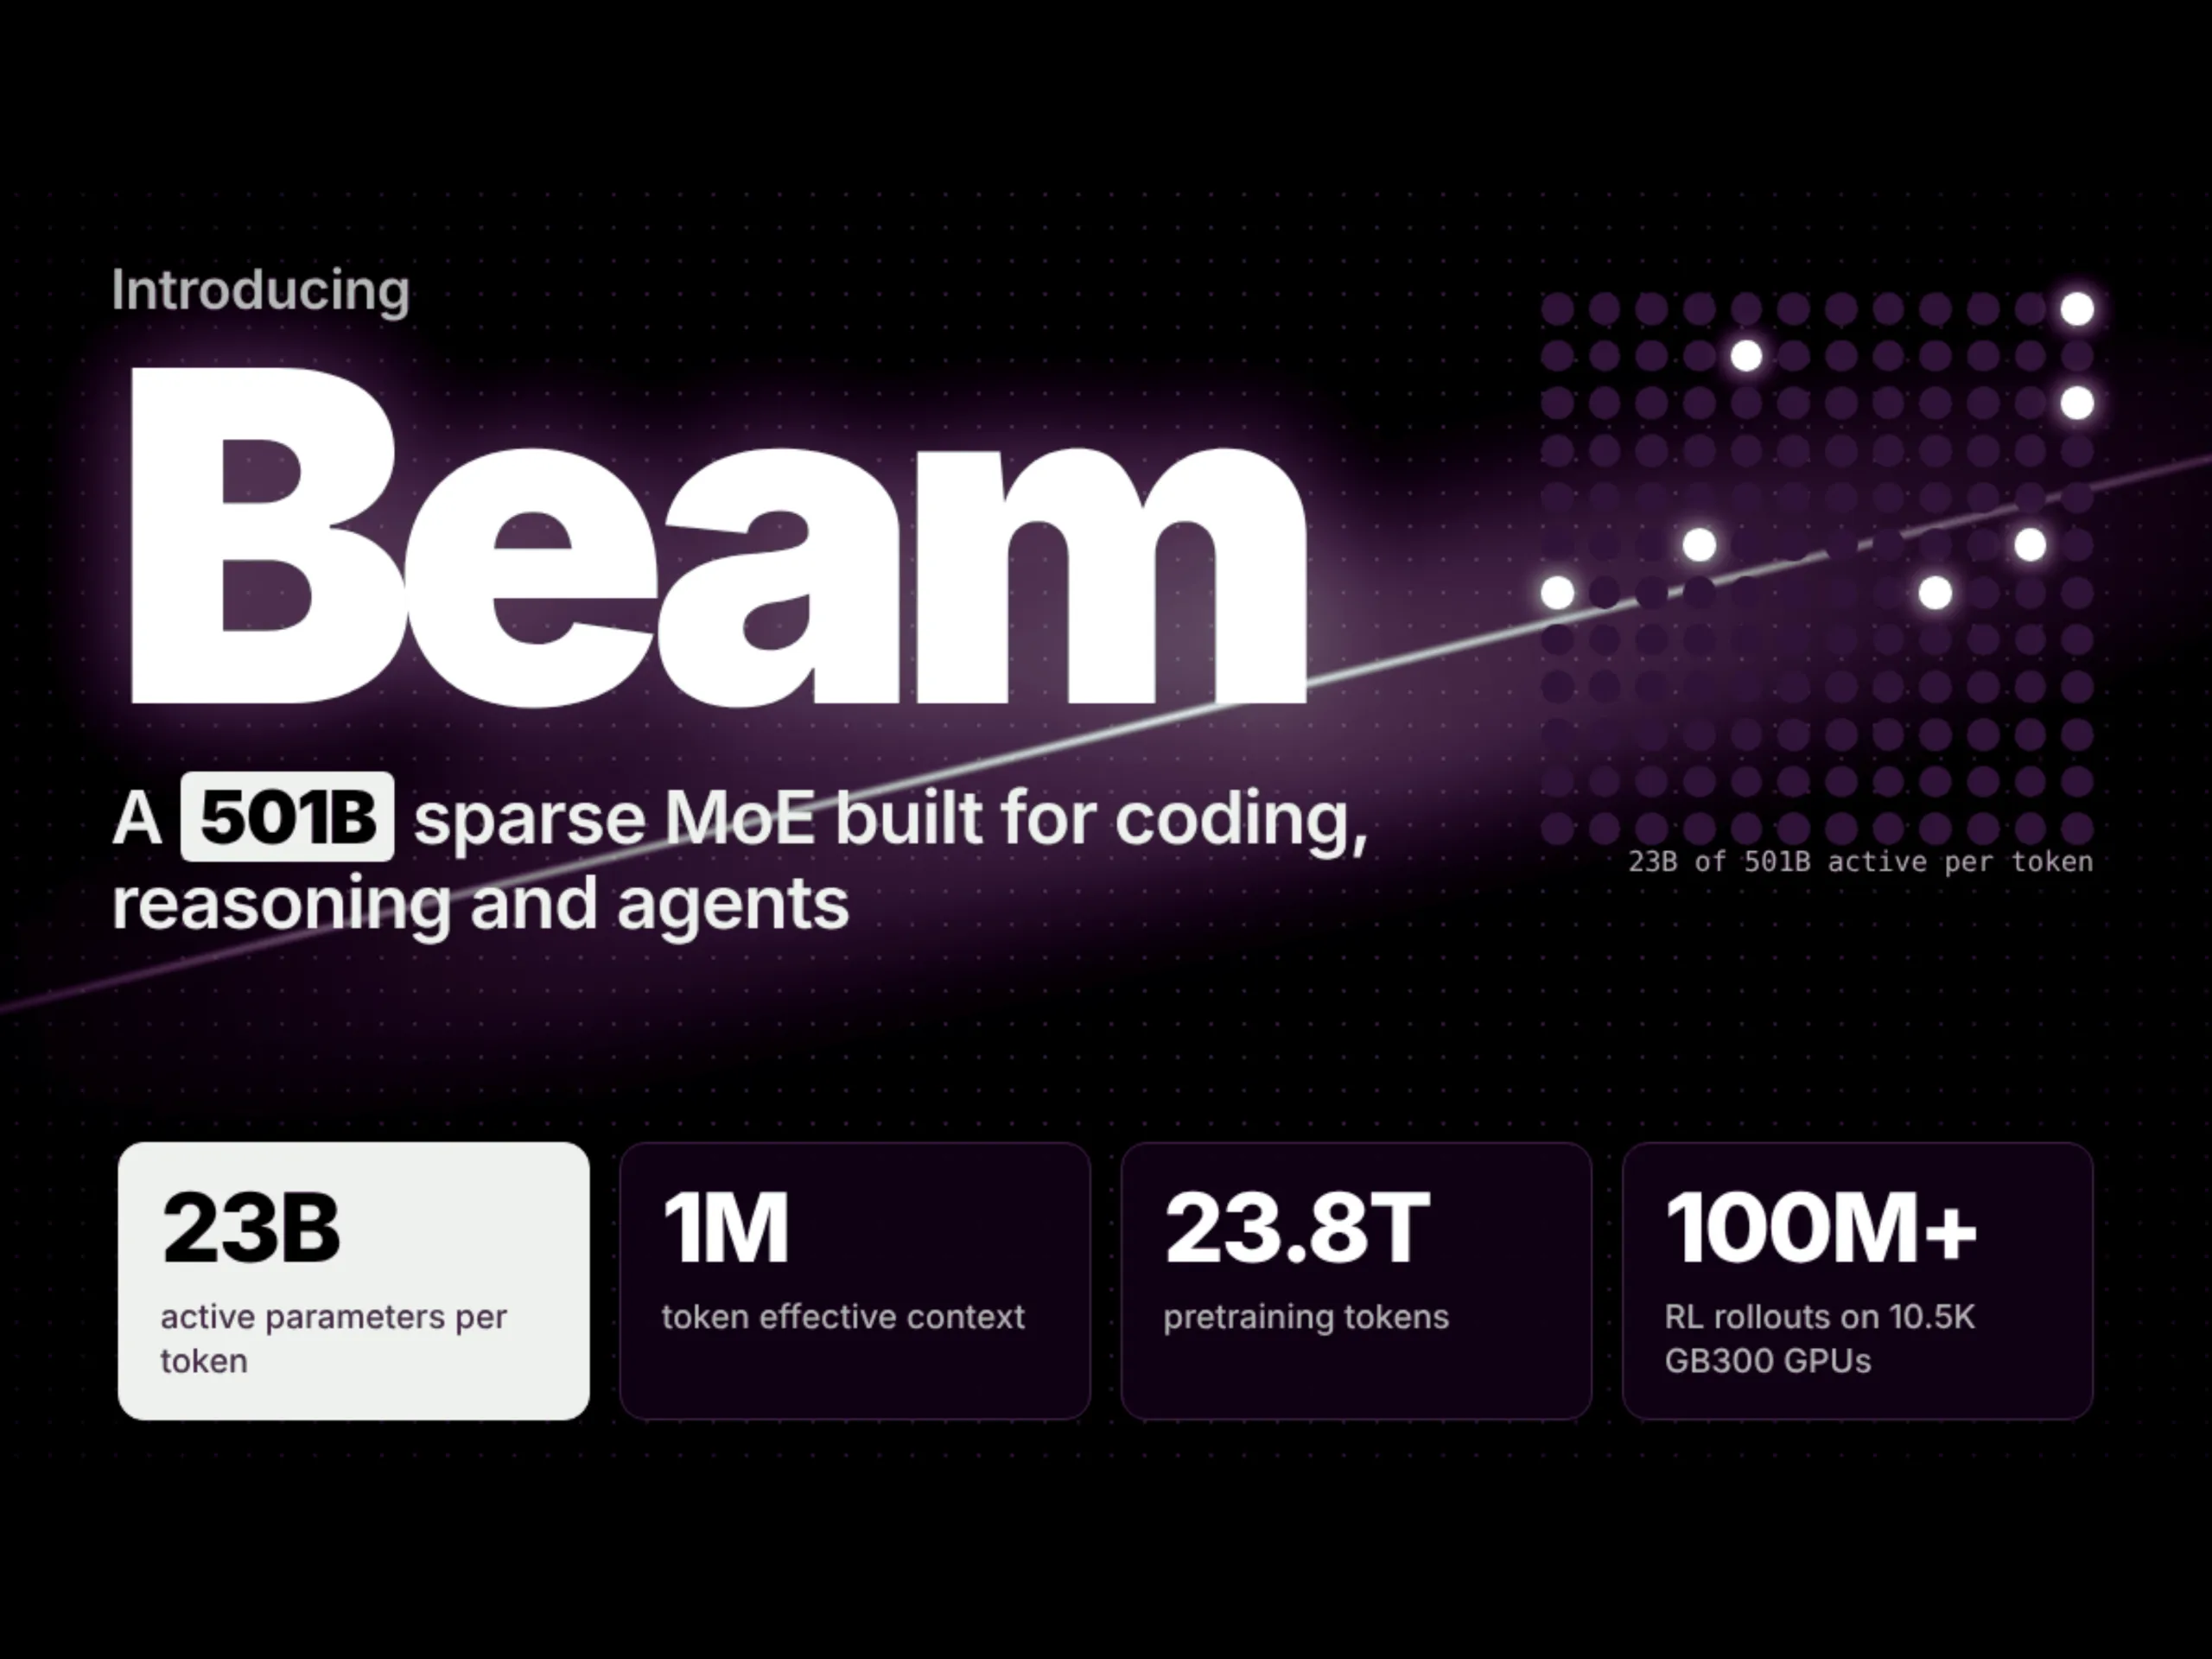
Reflection AI lansează Beam: un model MoE open-weight de 501 miliarde de parametri, cu doar 23 de miliarde activi, gândit pentru cod și agenți autonomi
Reflection AI a lansat Beam, un model open-weight de tip Mixture of Experts cu 501 miliarde de parametri totali și doar 23 de miliarde activi, optimizat pentru programare și agenți autonomi. O lovitură importantă pentru tabăra open-source, care promite performanțe de top la costuri de rulare mult mai mici.
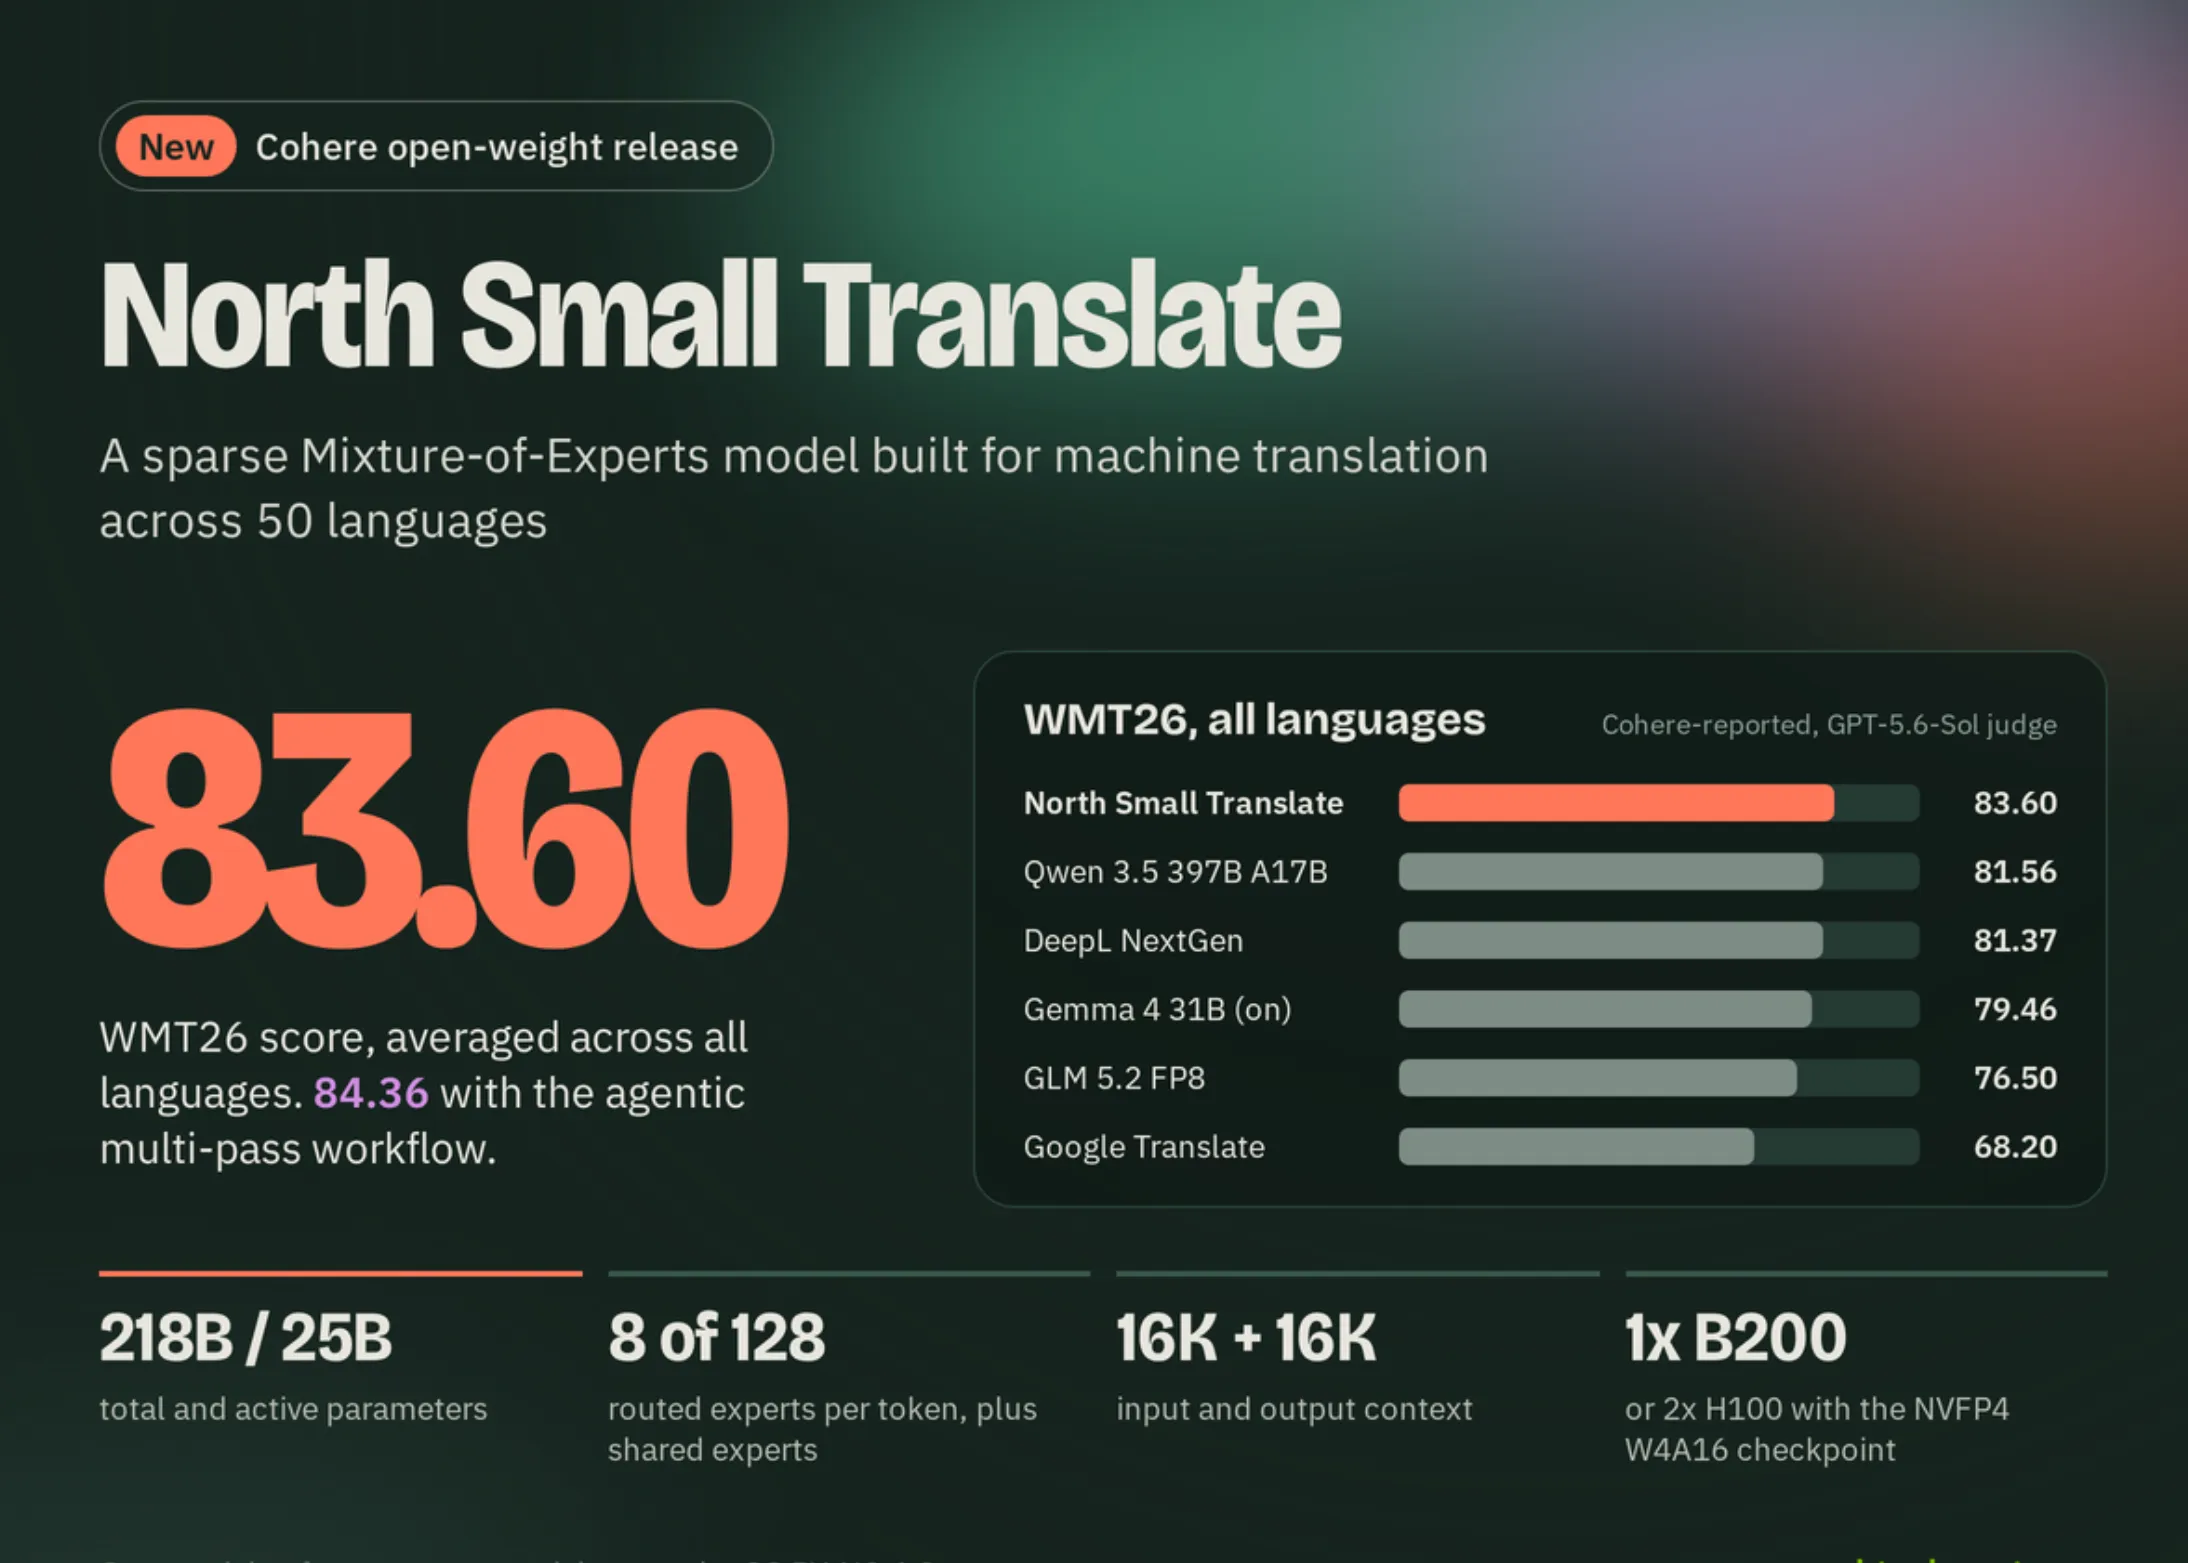
Cohere lansează North Small Translate: un model de traducere cu 218B parametri care obține 83,6 pe WMT26 în 50 de limbi
Cohere a lansat North Small Translate, un model de traducere cu 218B parametri și arhitectură MoE, care obține 83,6 pe WMT26 și suportă 50 de limbi. Acest model promite să revoluționeze traducerea automată prin acuratețe, viteză și accesibilitate.
FreeToken: Motorul de servire MoE care rulează GLM-5.2 de 753B pe un singur GPU de workstation
FreeToken este un motor de servire open-source care rulează modelul GLM-5.2 de 753 de miliarde de parametri pe un singur GPU de workstation, folosind tehnici avansate de offloading și cuantizare. Acest lucru democratizează accesul la AI de ultimă generație și face posibilă rularea locală a modelelor complexe.

NVIDIA lansează Nemotron 3.5 Lightning: un model MoE open source cu 30B parametri și doar 3B activi, plus routerul NeMo Switchyard
NVIDIA a lansat Nemotron 3.5 Lightning, un model open source cu arhitectură MoE de 30B parametri, dar doar 3B activi, alături de routerul NeMo Switchyard. Această combinație promite eficiență și accesibilitate, democratizând accesul la AI de ultimă generație.

Cursor lansează open-source Mixture-of-Kittens (MoK): un megakernel deterministic pentru antrenamentul MoE pe rack-urile GB300 NVL72
Cursor a deschis codul sursă pentru Mixture-of-Kittens (MoK), un megakernel deterministic pentru antrenamentul modelelor MoE pe rack-urile GB300 NVL72. Soluția promite reproductibilitate și performanță superioară, fiind un pas important pentru cercetarea AI open-source.

Alibaba Qwen lansează Qwen3.8-Max: un model MoE cu 2,4 trilioane de parametri, cel mai puternic din familia Qwen până în prezent
Alibaba a lansat Qwen3.8-Max, un model de limbaj MoE cu 2,4 trilioane de parametri, cel mai puternic din familia Qwen. Articolul analizează arhitectura, performanța, impactul și provocările acestui model, subliniind importanța sa în competiția globală pentru inteligența artificială.
Tencent lansează open-source AngelSpec: un cadru unificat de antrenament pentru decodarea speculativă MTP și bloc-paralelă pe modele Hy3
Tencent a deschis codul sursă al AngelSpec, un cadru unificat de antrenare pentru decodarea speculativă pe modele Hy3. Include DFly, un draftor bazat pe difuzie bloc, și D-cut, un modul de bugetare adaptivă, oferind o accelerare de până la 2,40× față de decodarea autoregresivă standard.