Subiect: #Deep Learning
NeRF Ierarhic cu JAX3D: Revoluția Randării Volumetrice, Sintezei Vizualizărilor Noi și Reconstrucției 3D
Analiză profundă a NeRF-ului ierarhic implementat cu JAX3D: cum combinarea randării volumetrice neuronale cu compilarea JIT și diferențierea automată revoluționează sinteza vizualizărilor noi și reconstrucția 3D la scară largă, oferind performanță, modularitate și accesibilitate fără precedent pentru cercetători și industrii.
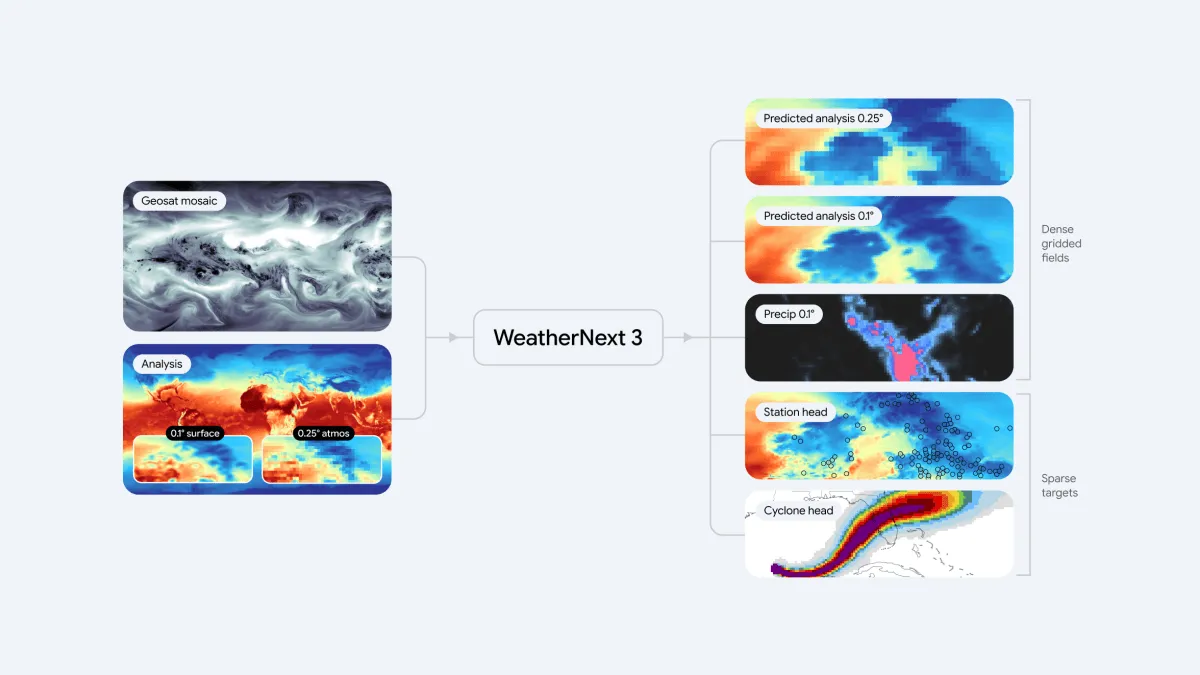
Google DeepMind lansează WeatherNext 3: noul model AI care prezică vremea cu o precizie fără precedent și te scutură de uite-ți umbrela acasă
Google DeepMind lansează WeatherNext 3, un model AI de prognoză meteo care bate modelele guvernamentale și celelalte sisteme de deep learning, oferind rezoluție de 5 km, actualizări orare și integrare directă a datelor brute satelitale. Articolul analizează implicațiile pentru utilizatori, industrie și viitorul meteorologiei.

Proiectarea kernel-urilor GPU de înaltă performanță cu TileLang: GEMM pe Tensor-Core, Softmax fuzionat, FlashAttention și autotuning
TileLang este un limbaj și compilator specializat pentru kernel-uri GPU de înaltă performanță, care simplifică utilizarea Tensor Cores, fuzionarea operațiilor precum Softmax, implementarea FlashAttention și autotuning-ul. Acest articol explorează cum TileLang revoluționează dezvoltarea de kernel-uri pentru inteligența artificială.

Moonshot AI lansează Kimi K3: Un model MoE deschis cu 2,8 trilioane de parametri, atenție Kimi Delta și context de 1 milion
Moonshot AI a lansat Kimi K3, un model open-source MoE cu 2,8 trilioane de parametri, atenție Kimi Delta și context de 1 milion de tokeni, depășind multe modele închise și deschizând noi posibilități în AI.

NeuroVFM: Revoluționarea imagisticii medicale cu un model fundațional antrenat pe volume MRI și CT necurate
NeuroVFM este un model fundațional de neuroimagistică antrenat cu metoda Vol-JEPA pe volume MRI și CT necurate, capabil să învețe reprezentări anatomice fără adnotări. Acesta atinge performanțe de top în segmentare și clasificare, fiind robust la variațiile clinice reale și reducând dependența de date etichetate.
Ghid practic pentru programarea GPU pe bază de tile-uri: de la cuTile și Triton la Flash Attention
Un ghid practic pentru programarea GPU pe bază de tile-uri folosind cuTile, Triton și Flash Attention, cu exemple de kernel-uri și verificare în PyTorch. Învață cum să optimizezi operații precum adunarea vectorială, GELU, softmax, înmulțirea matricelor și atenția eficientă.

NVIDIA lansează Cosmos 3: un model fundamental cu două turnuri și amestec de transformatori care unifică raționamentul fizic, generarea de lumi și generarea de acțiuni
NVIDIA a prezentat Cosmos 3, un model fundamental cu arhitectură two-tower și mixture-of-transformers, care unifică raționamentul fizic, generarea de lumi și generarea de acțiuni. Acest articol analizează inovațiile tehnice, implicațiile pentru robotică și viitorul AI.
Cum să accelerezi antrenarea Transformer-elor cu NVIDIA Apex și torch.amp: Ghid practic pentru performanță maximă pe GPU
Ghid complet pentru accelerarea antrenării Transformer-elor folosind NVIDIA Apex (FusedAdam, FusedLayerNorm) împreună cu torch.amp. Include explicații practice, exemple de cod și strategii de optimizare pentru GPU-uri NVIDIA moderne.
mKernel: Biblioteca de kerneluri fuzionate pentru comunicare GPU multi-GPU și multi-nod
mKernel este o bibliotecă open-source care revoluționează comunicarea între GPU-uri multiple, rulând kerneluri fuzionate direct pe placă grafică, fără a mai trece prin CPU. Rezultatul: antrenare mai rapidă a modelelor AI, latență redusă și suport nativ pentru medii multi-nod.
Părtinirea de frecvență a Gradientului Descendent Stocastic (SGD) și cum o rezolvă Adam
Gradientul Descendent Stocastic (SGD) are o părtinire de frecvență care favorizează tiparele rare în detrimentul celor frecvente. Optimizatorul Adam corectează această problemă prin adaptarea ratei de învățare per-parametru, normalizând gradienții în funcție de varianță. Articolul explică mecanismul și importanța sa practică.
De ce zigzaghează Gradient Descent și cum îl corectează Momentum
Gradient descent zigzaghează din cauza diferențelor mari de magnitudine ale gradientilor pe diferite direcții. Momentum, inspirat din fizică, netezește oscilațiile și accelerează convergența, fiind esențial în antrenarea rețelelor neuronale.

Implementarea codificării pentru decodarea cerebrală completă de la semnale MEG folosind NeuralSet și Deep Learning pentru predicția caracteristicilor lingvistice
Un studiu recent prezintă o implementare completă a decodării semnalelor MEG pentru predicția caracteristicilor lingvistice, folosind arhitectura NeuralSet și deep learning. Sistemul atinge o acuratețe de peste 70% și are potențialul de a revoluționa interfețele creier-calculator.