Subiect: #LLM
PrismML și visul unui AI mic de tot: cum ar putea un model de 5,9 GB să schimbe felul în care folosim inteligența artificială
PrismML, un startup fondat de cercetători de la Caltech, a lansat Bonsai 2 27B, un model de inteligență artificială comprimat la doar 5,9 GB, care poate rula pe PC-uri și smartphone-uri. Cu o performanță de 98% față de original, compania vrea să demonstreze că modelele mari nu trebuie să fie neapărat uriașe, aducând AI-ul direct pe dispozitivele utilizatorilor.
Modelul Lingvistic Muscă (FLM): Conectomul complet al muștei de fructe integrat într-un LLM de 1,2 miliarde de parametri, dar propriile teste arată că nu ajută
Modelul Lingvistic Muscă (FLM) integrează conectomul complet al muștei de fructe într-un LLM înghețat de 1,2 miliarde de parametri, dar propriile controale arată că această cablare nu aduce niciun beneficiu. Analizăm arhitectura, rezultatele și implicațiile pentru viitorul IA.
Google Research lansează ToolGrad: Framework-ul "Răspunsul Întâi" care atinge 99,8% rată de succes în generarea datelor pentru utilizarea uneltelor
Google Research lansează ToolGrad, un framework ACL 2026 care inversează generarea datelor pentru tool-use: construiește mai întâi lanțurile de API verificate, apoi generează întrebările. Rezultatul: 99,8% pass rate pe ToolBench (vs 63,8% DFS) și un Gemma-3-12B fintunat pe 500 de exemple care egalizează Gemini 2.5 Pro pe BFCL. Totul este open-source (Apache 2.0).
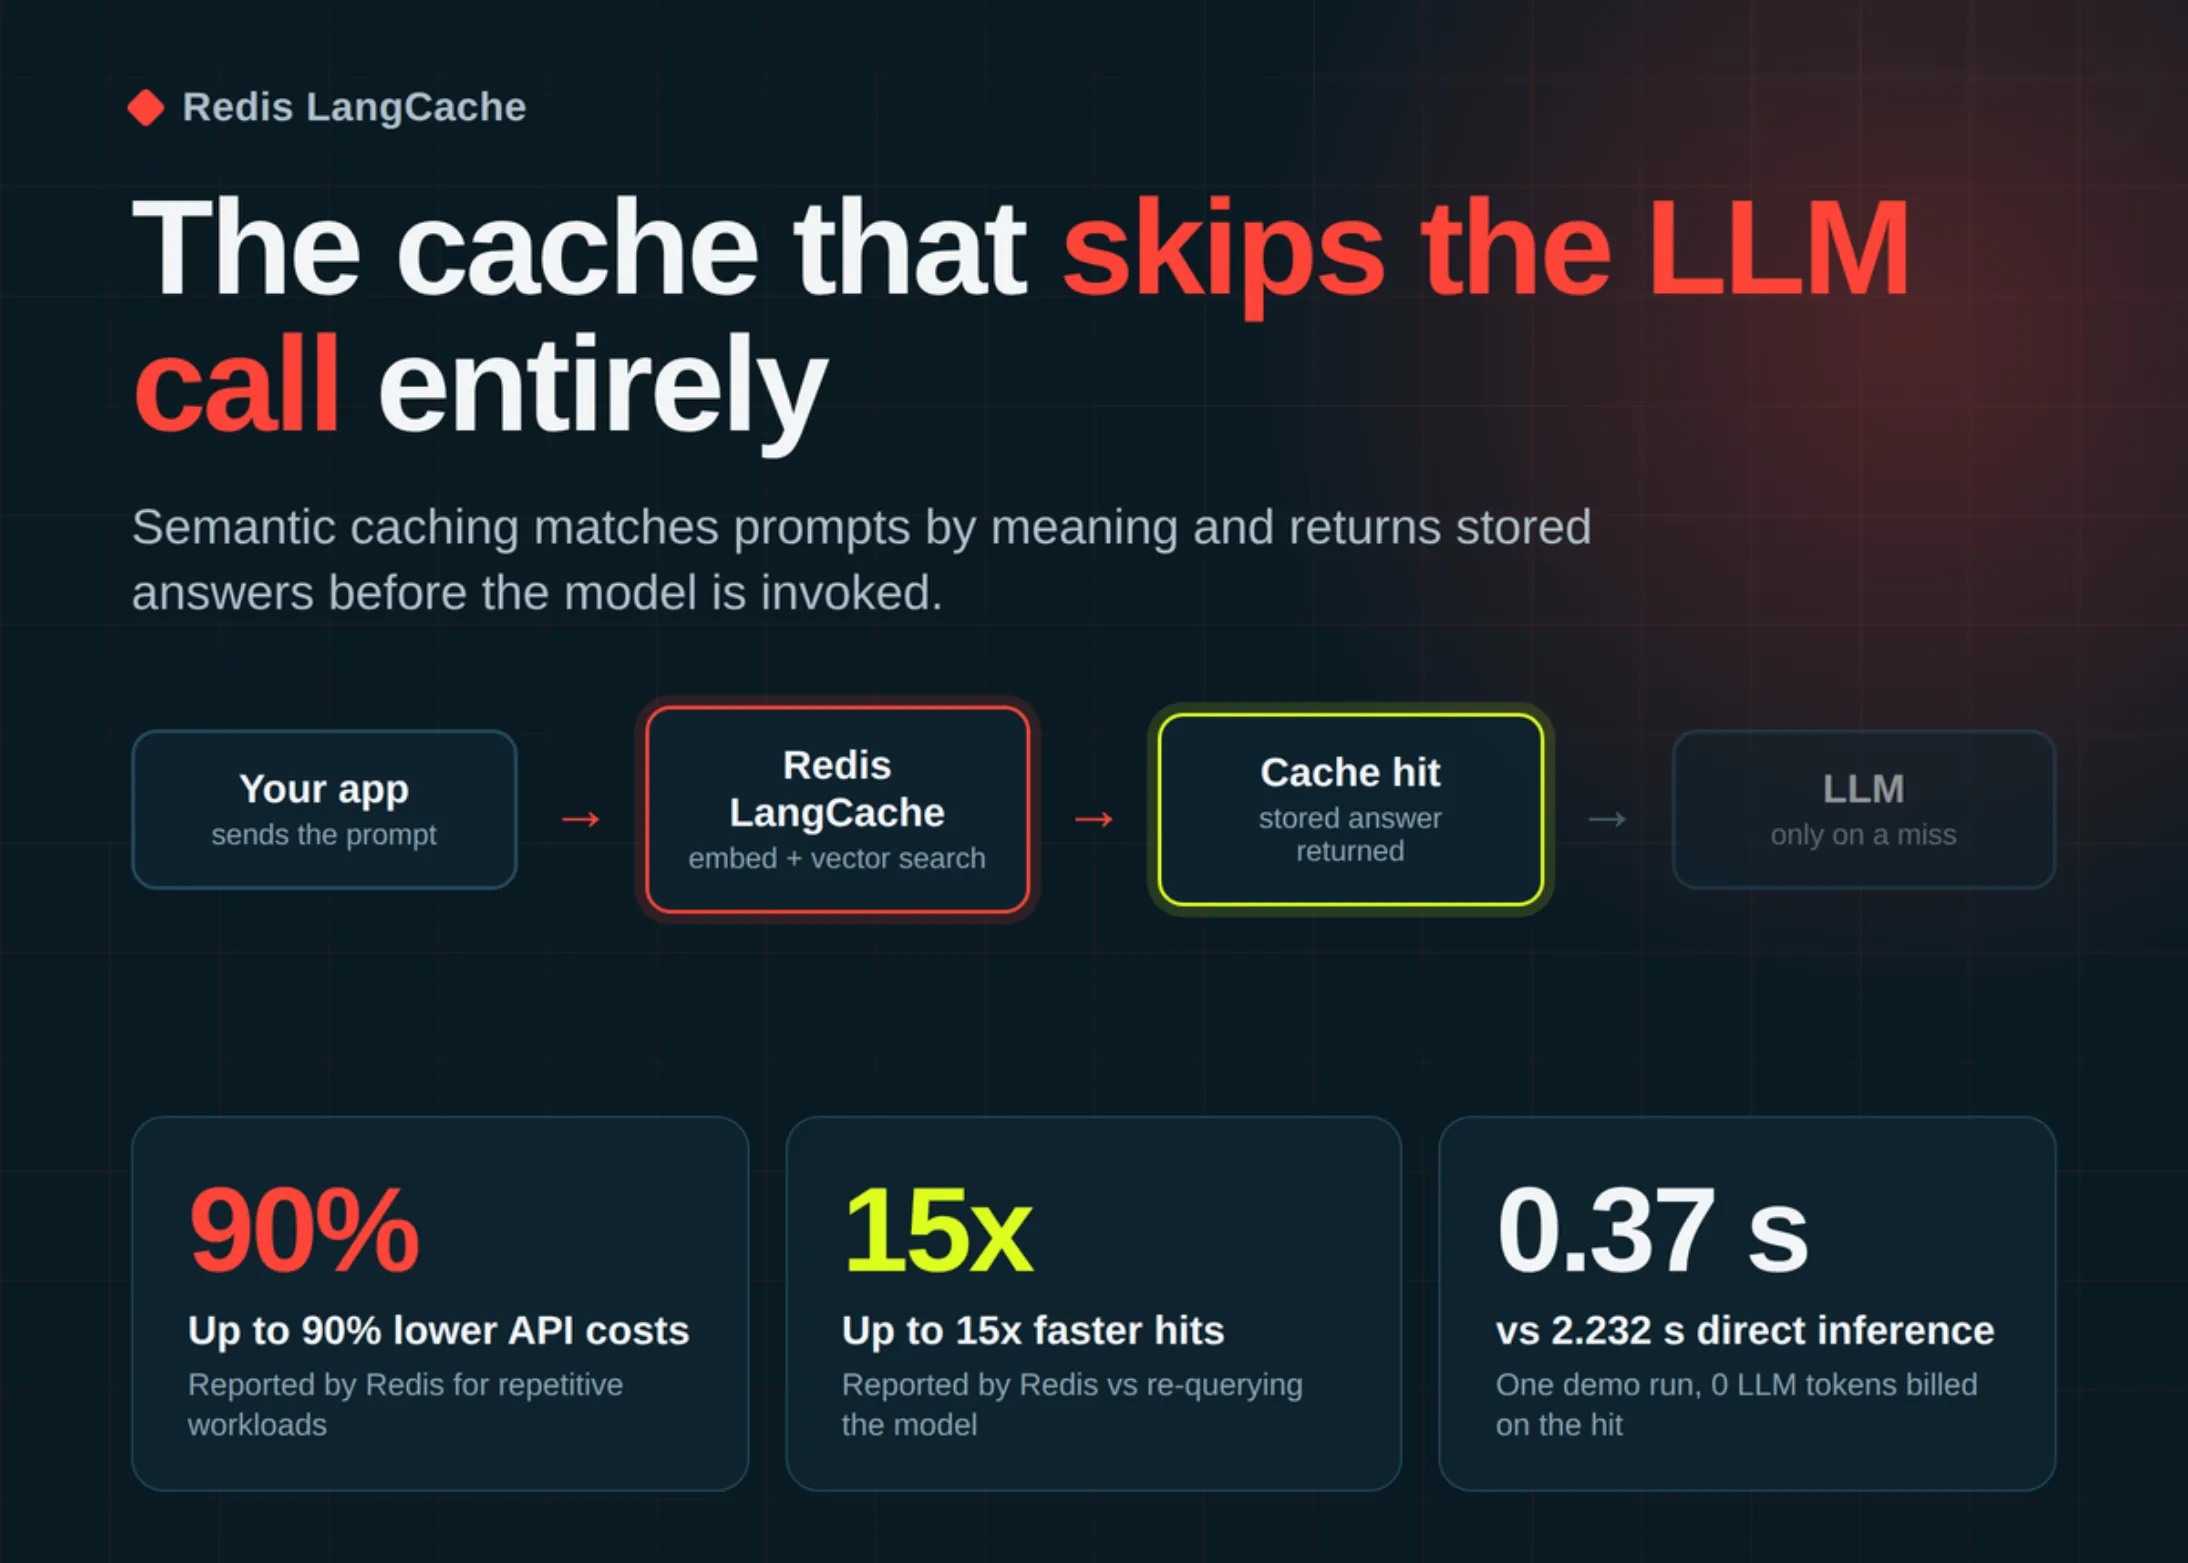
Redis LangCache: Cache-ul semantic care taie până la 90% din factura la API-urile LLM și răspunde de 15 ori mai repede
Redis a lansat LangCache, un serviciu gestionat de caching semantic care promite să reducă factura la API-urile LLM cu până la 90% și să livreze răspunsuri de până la 15 ori mai rapide. Iată cum funcționează, ce înseamnă pentru dezvoltatori și care sunt compromisurile de care trebuie să ții cont.
Pot LLM-urile să-și construiască singure hamul de agent? ByteDance Seed spune că doar 34 din 64 de modificări se generalizează
ByteDance Seed și partenerii săi academici au lansat HarnessDev, un benchmark care măsoară nu răspunsurile unui LLM, ci hamul de agent pe care acesta reușește să și-l construiască singur. Rezultatele arată progres real la scris și experimente ML, dar și o problemă serioasă de generalizare: doar 34 din 64 de modificări auto-generate funcționează și pe sarcini noi.
Adaption Labs lansează 'Invent a Dataset': Date de antrenament generate dintr-o simplă descriere a sarcinii, fără corpus inițial
Adaption Labs revoluționează pregătirea datelor pentru IA cu 'Invent a Dataset', un instrument care generează seturi de date de antrenament structurate, diverse și gata de folosit (JSONL, CSV, Parquet) direct dintr-o descriere în limbaj natural a sarcinii, eliminând nevoia de corpus inițial, scheme rigide sau echipe de anotare. Integrarea directă cu AutoScientist închide bucla 'intent-to-trained-model', accelerând dramatic ciclu de dezvoltare a modelelor ML.
Anthropic lansează Claude Fable 5.1 și Mythos 5.1: Performanțe de top în știință și costuri tăiate cu trei sferturi pentru cache
Anthropic lansează Claude Fable 5.1 (public) și Mythos 5.1 (restrâns, Project Glasswing). Același model, două straturi de siguranță. Fable 5.1 atinge 52,6% pe Terminal-Bench-Science (vs 24,7% la v5), are 1M tokeni context și reduce costul cache reads cu 75% (la $0,25/M token). API-ul suferă 3 breaking changes majore, incluzând eliminarea forced tool use. O analiză profundă a impactului economic și arhitectural.
EnvHarness: Cum transformă Google AI mediile statice în lumi de antrenament adaptive
EnvHarness, lansat de Google Cloud AI Research, transformă mediile statice de antrenament în lumi adaptive, folosind un LLM pentru a modifica automat provocările. Rezultatele arată îmbunătățiri de până la 9 puncte și o eficiență crescută cu 9.8%.
Ghidul dezvoltatorului pentru NeMo Guardrails: Siguranța AI la nivel enterprise
Descoperă cum NeMo Guardrails de la NVIDIA oferă o arhitectură stratificată pentru siguranța aplicațiilor LLM în enterprise, incluzând redacția PII, filtrarea recuperării, mascarea ieșirii și controlul instrumentelor, cu accent pe auditabilitate și cost-eficiență.

O vulnerabilitate fundamentală face modelele de limbaj mari extrem de susceptibile la atacuri
Cercetătorii au descoperit o vulnerabilitate fundamentală în modelele de limbaj mari: acestea nu pot distinge corect între rolurile textului, ceea ce le face susceptibile la atacuri prin falsificarea lanțului de gândire. Chiar și modelele avansate pot fi păcălite să ofere informații periculoase, iar problema pare imposibil de rezolvat complet.

Kog: Cum să obții inferență AI de 30 de ori mai rapidă pe GPU-urile pe care le ai deja
Startup-ul francez Kog promite o inferență AI de 30 de ori mai rapidă pe GPU-urile standard, printr-o optimizare software profundă. Cu o demonstrație de 3.000 de tokeni pe secundă și un fondator cu background în fizică și hacking, Kog atrage deja interesul pieței, vizând în special ingineria software.
Cum să construiești un model de limbaj axat pe raționament: ghid practic pentru streaming, curatare și fine-tuning cu SupraLabs
Un ghid practic pentru construirea unui model de limbaj mic, dar specializat în raționament, folosind streaming-ul datelor SupraLabs, filtrarea calității și fine-tuning cu LoRA pe SmolLM2-135M-Instruct. Articolul analizează fiecare etapă și subliniază importanța accesibilității în AI.