Subiect: #LLM

10 platforme AI open-source fără cod pentru aplicații LLM, sisteme RAG și agenți AI
Descoperă zece platforme open-source fără cod care îți permit să construiești aplicații cu LLM-uri, sisteme RAG și agenți AI, fără să scrii cod. De la Flowise la Dify, aceste instrumente democratizează inteligența artificială.

Google Cloud lansează Agentul de Memorie Permanentă: sfârșitul RAG și al încorporărilor clasice cu Gemini 3.1 Flash-Lite
Google Cloud a lansat un agent de memorie permanentă care înlocuiește RAG și încorporările clasice, folosind consolidarea continuă a LLM-urilor pe modelul Gemini 3.1 Flash-Lite. Articolul explică tehnologia, avantajele, provocările și impactul asupra dezvoltării aplicațiilor AI.

Nemotron Labs 3 Puzzle 75B A9B: Un model lingvistic hibrid MoE comprimat care oferă o performanță de 2,03 ori mai mare pe server
Nemotron Labs a lansat modelul lingvistic Nemotron Labs 3 Puzzle 75B A9B, un LLM hibrid MoE comprimat care oferă o creștere de 2,03 ori a debitului pe server, permițând rularea pe un singur GPU și reducând costurile de infrastructură.
NVIDIA lansează Nemotron-Labs-3-Puzzle-75B-A9B: un model lingvistic hibrid MoE comprimat care oferă o performanță de server de 2,03 ori mai mare la același debit per utilizator
NVIDIA a lansat Nemotron-Labs-3-Puzzle-75B-A9B, un model lingvistic hibrid MoE comprimat, care oferă o performanță de server de 2,03 ori mai mare decât predecesorul său, la același debit per utilizator. Modelul folosește o tehnică inovatoare de compresie structurală iterativă, reducând parametrii de la 120,7B la 75,3B, și permite o concurență de 8 ori mai mare pe un singur GPU H100.

Reddit folosește modele lingvistice mari pentru a rezolva o problemă pe care tot ele au creat-o
Reddit folosește modele lingvistice mari (LLM-uri) pentru a combate spamul generat tot de LLM-uri. Platforma blochează 23 de milioane de vizualizări de spam pe zi și a redus expunerea utilizatorilor cu 20% într-un trimestru. O soluție ironică, dar necesară în era AI.

Platforma de vibe coding Base44 își lansează propriul model AI: start-up-urile caută defensibilitate într-un peisaj dominat de giganți
Base44, platforma de vibe coding achiziționată de Wix, lansează propriul model AI (Base1) pentru a reduce costurile și a crește defensibilitatea. Într-un peisaj dominat de giganți, start-up-ul pariază pe specializare și date proprii pentru a concura cu modelele de frontieră.
Sakana AI lansează Sakana Fugu: modelul de orchestrare care direcționează sarcinile către un grup interschimbabil de LLM-uri de frontieră
Sakana AI a lansat Sakana Fugu, un model de orchestrare care direcționează sarcinile către cel mai potrivit LLM dintr-un grup interschimbabil, reducând costurile și îmbunătățind performanța. Descoperiți cum funcționează și de ce este revoluționar.
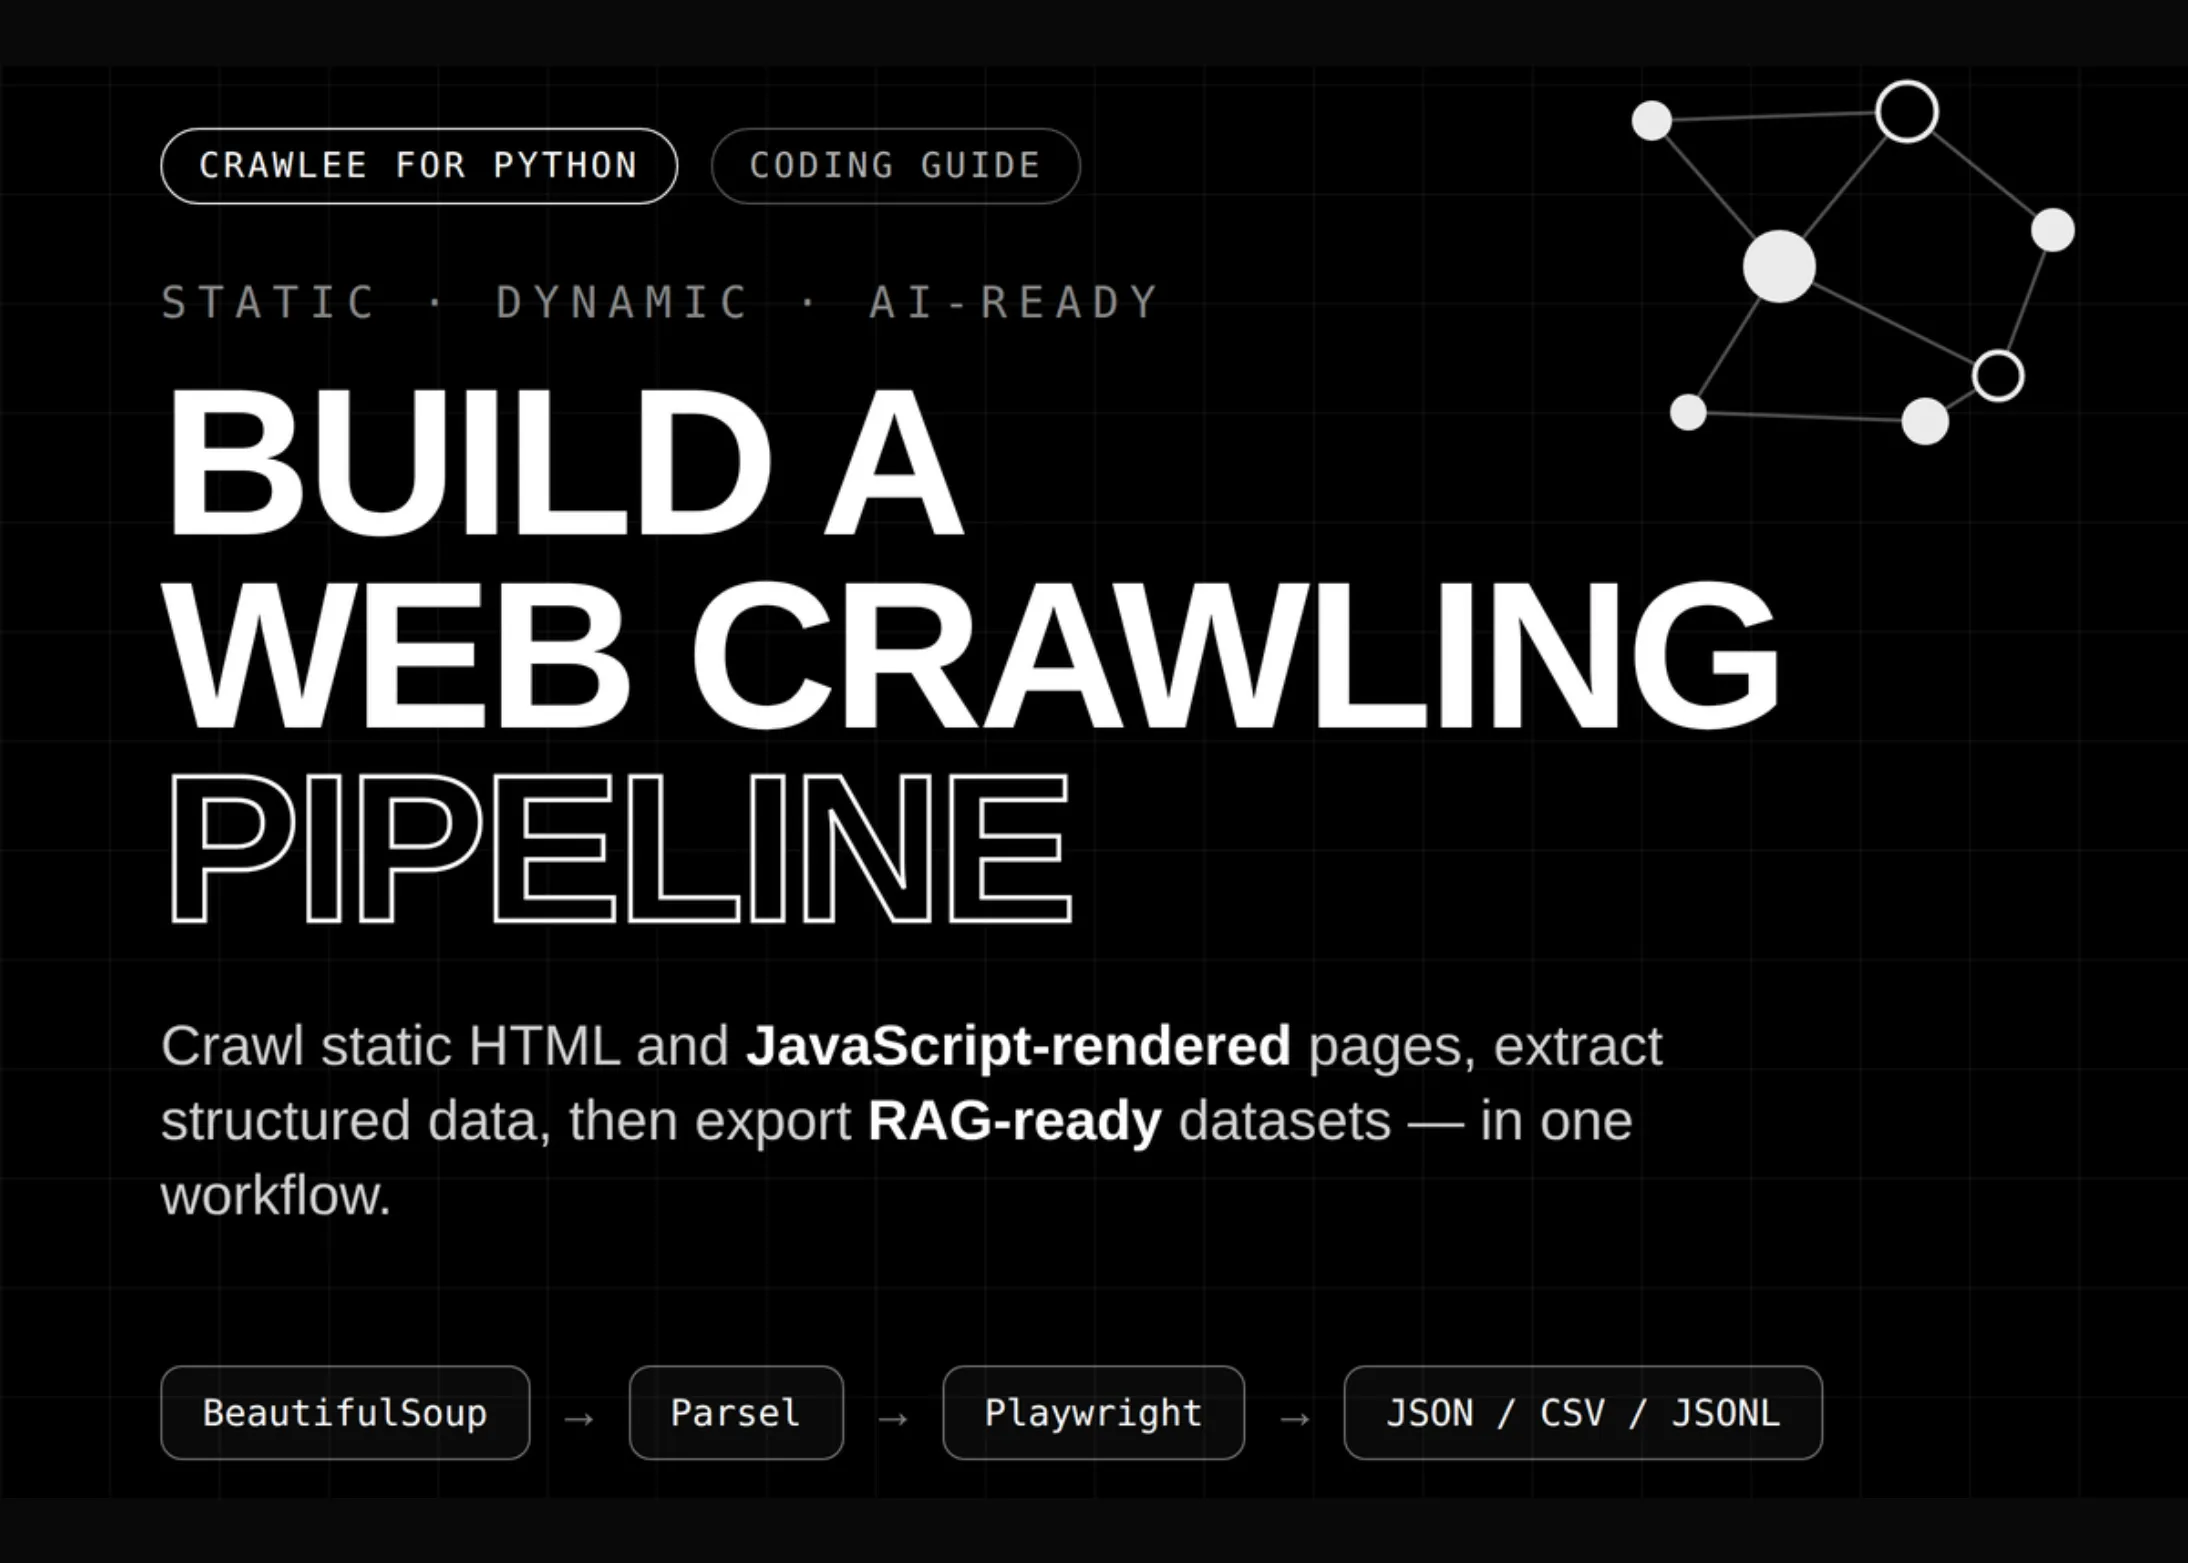
Crawlee pentru Python: Cum să construiești un pipeline de web crawling cu gestionarea roboților, grafuri de linkuri și export RAG
Crawlee este un framework open-source pentru Python care simplifică web crawling-ul prin gestionarea automată a robots.txt, construirea de grafuri de linkuri și exportul în chunk-uri pentru RAG. Articolul explică cum funcționează și de ce este util în era LLM-urilor.
Revoluția în Inteligența Artificială: Startup-ul Subquadratic susține că a spart blocajul care ținea LLM-urile pe loc
Startup-ul Subquadratic susține că a inventat un LLM bazat pe atenție rară, de 56 de ori mai rapid și mult mai ieftin decât modelele actuale. Teste independente confirmă performanțe competitive, dar scepticismul persistă din cauza accesului limitat și a folosirii ponderilor dintr-un model preexistent.
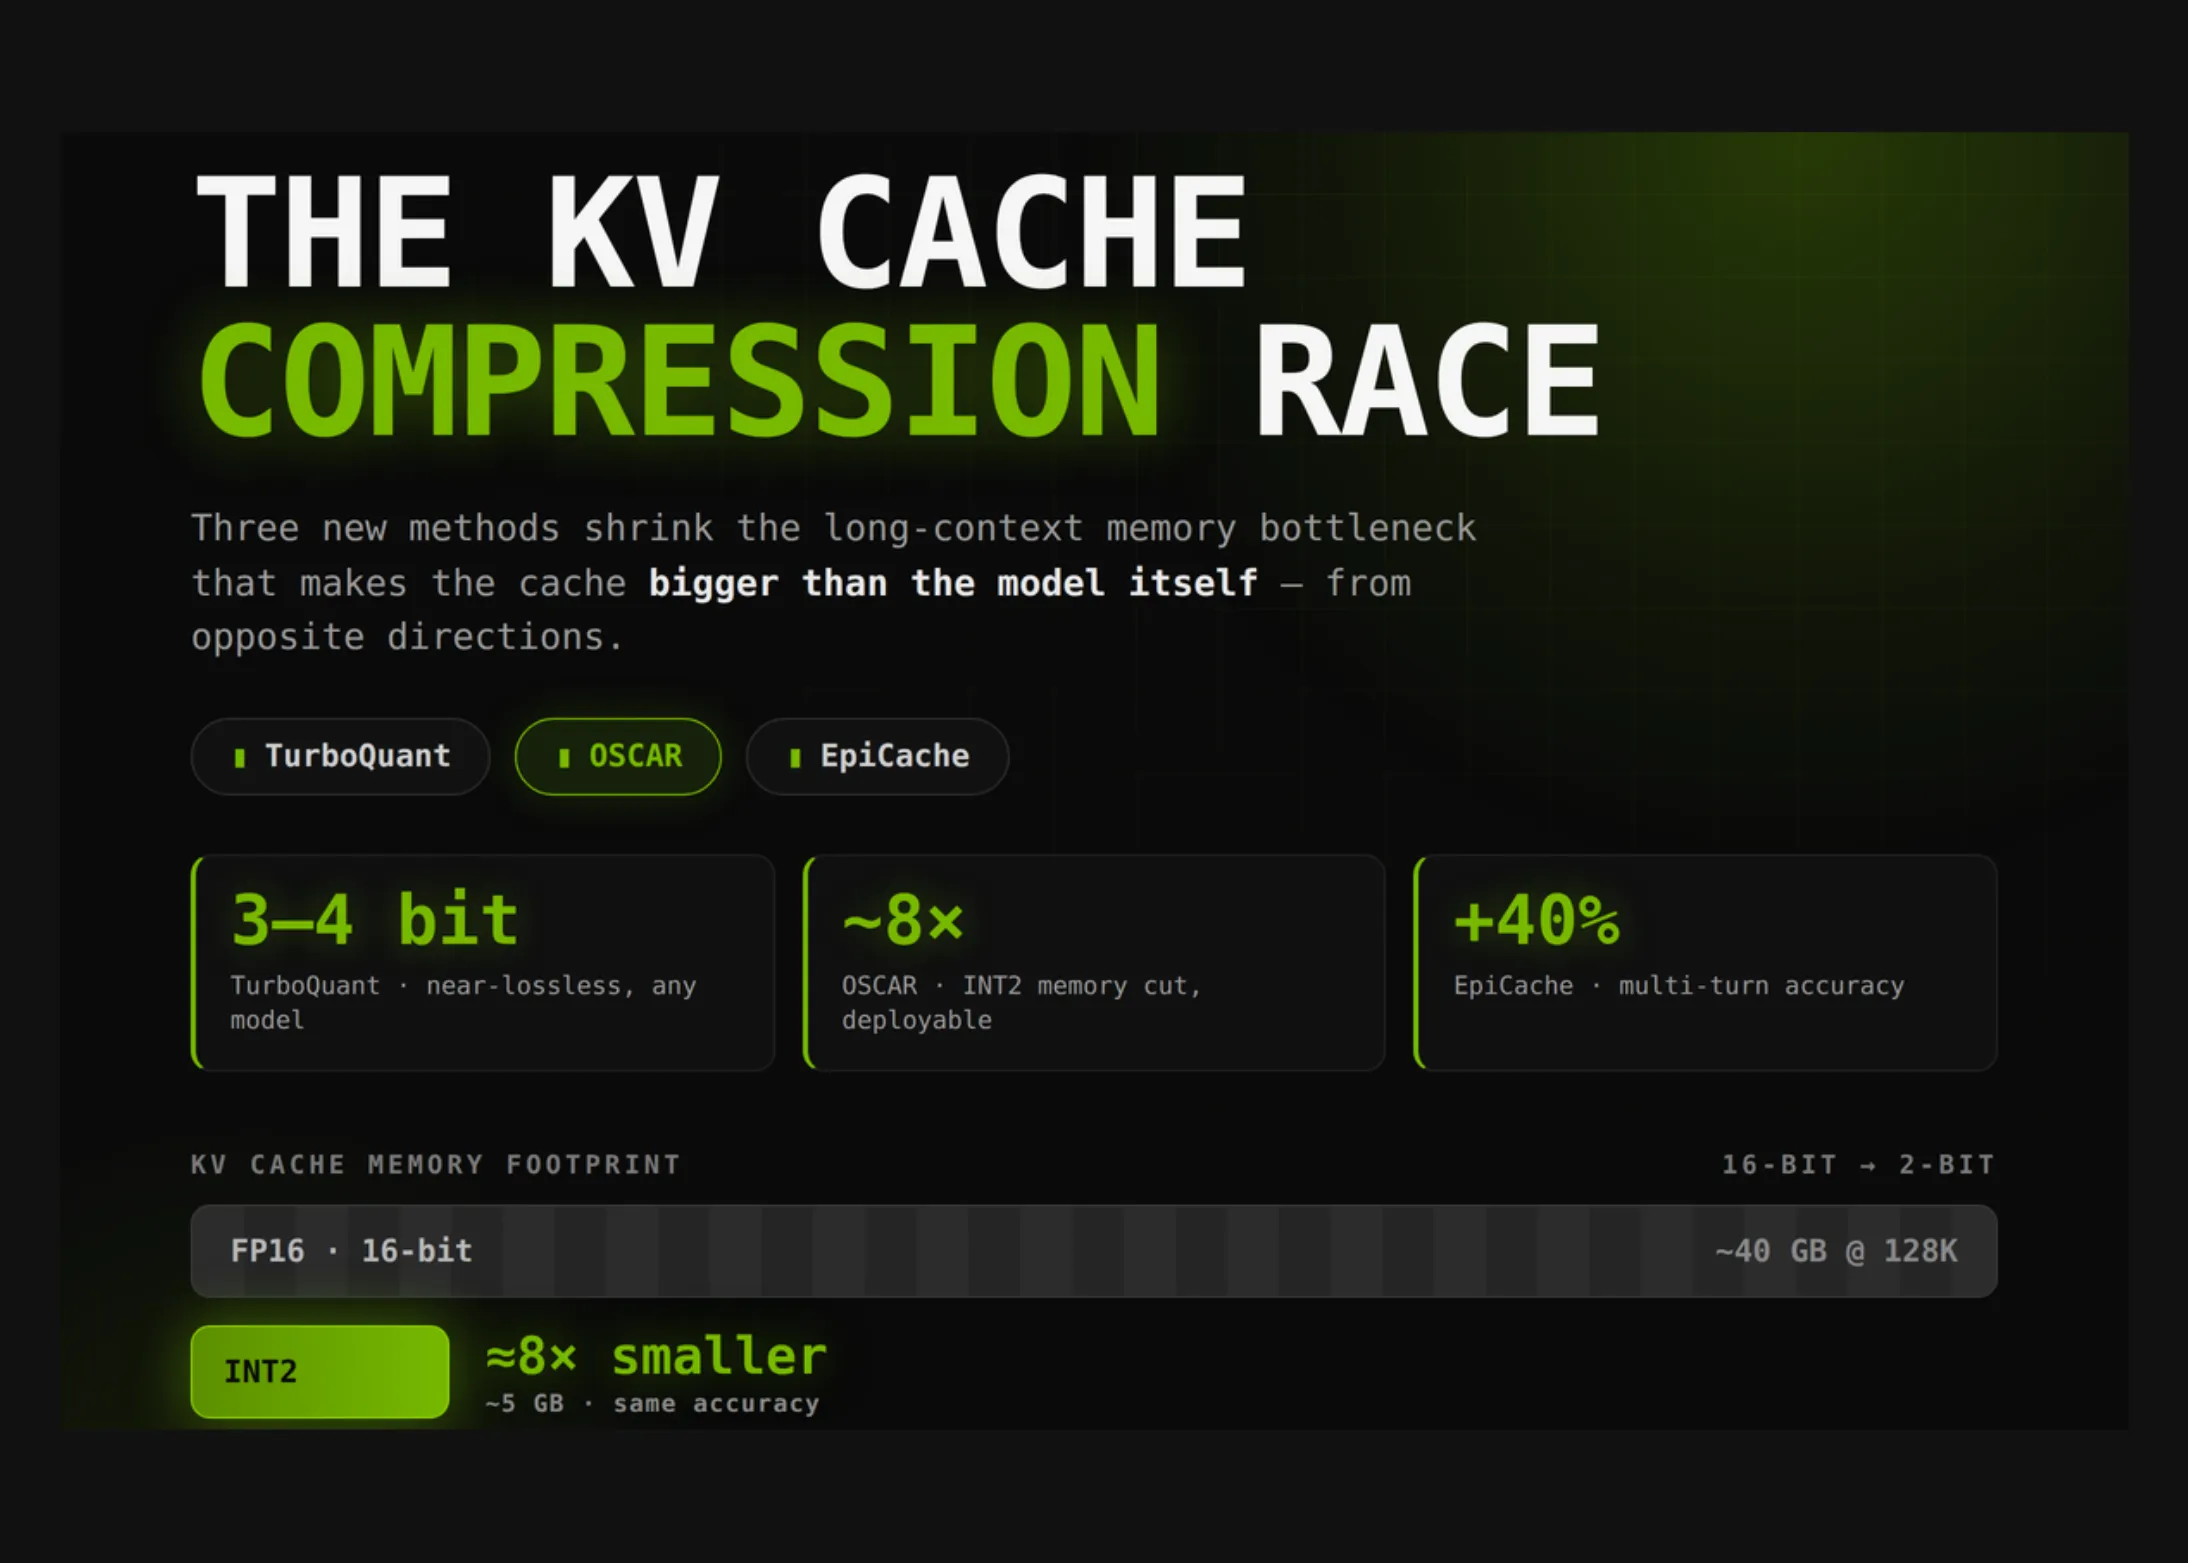
Cursa pentru compresia cache-ului KV: TurboQuant vs OSCAR vs EpiCache
TurboQuant, OSCAR și EpiCache sunt trei tehnologii de compresie a cache-ului KV care revoluționează modul în care rulează modelele de limbaj mari. Fiecare oferă un echilibru diferit între viteză, acuratețe și memorie, deschizând calea către un AI mai accesibil și mai eficient.
Ghid NVIDIA SkillSpector: Scanarea competențelor AI pentru riscuri de securitate cu analiză statică și rapoarte SARIF
Ghid complet pentru utilizarea NVIDIA SkillSpector în scanarea competențelor AI pentru riscuri de securitate. Include construirea unui corpus, analiză statică, organizare cu pandas, vizualizare, export SARIF și integrare CI/CD.
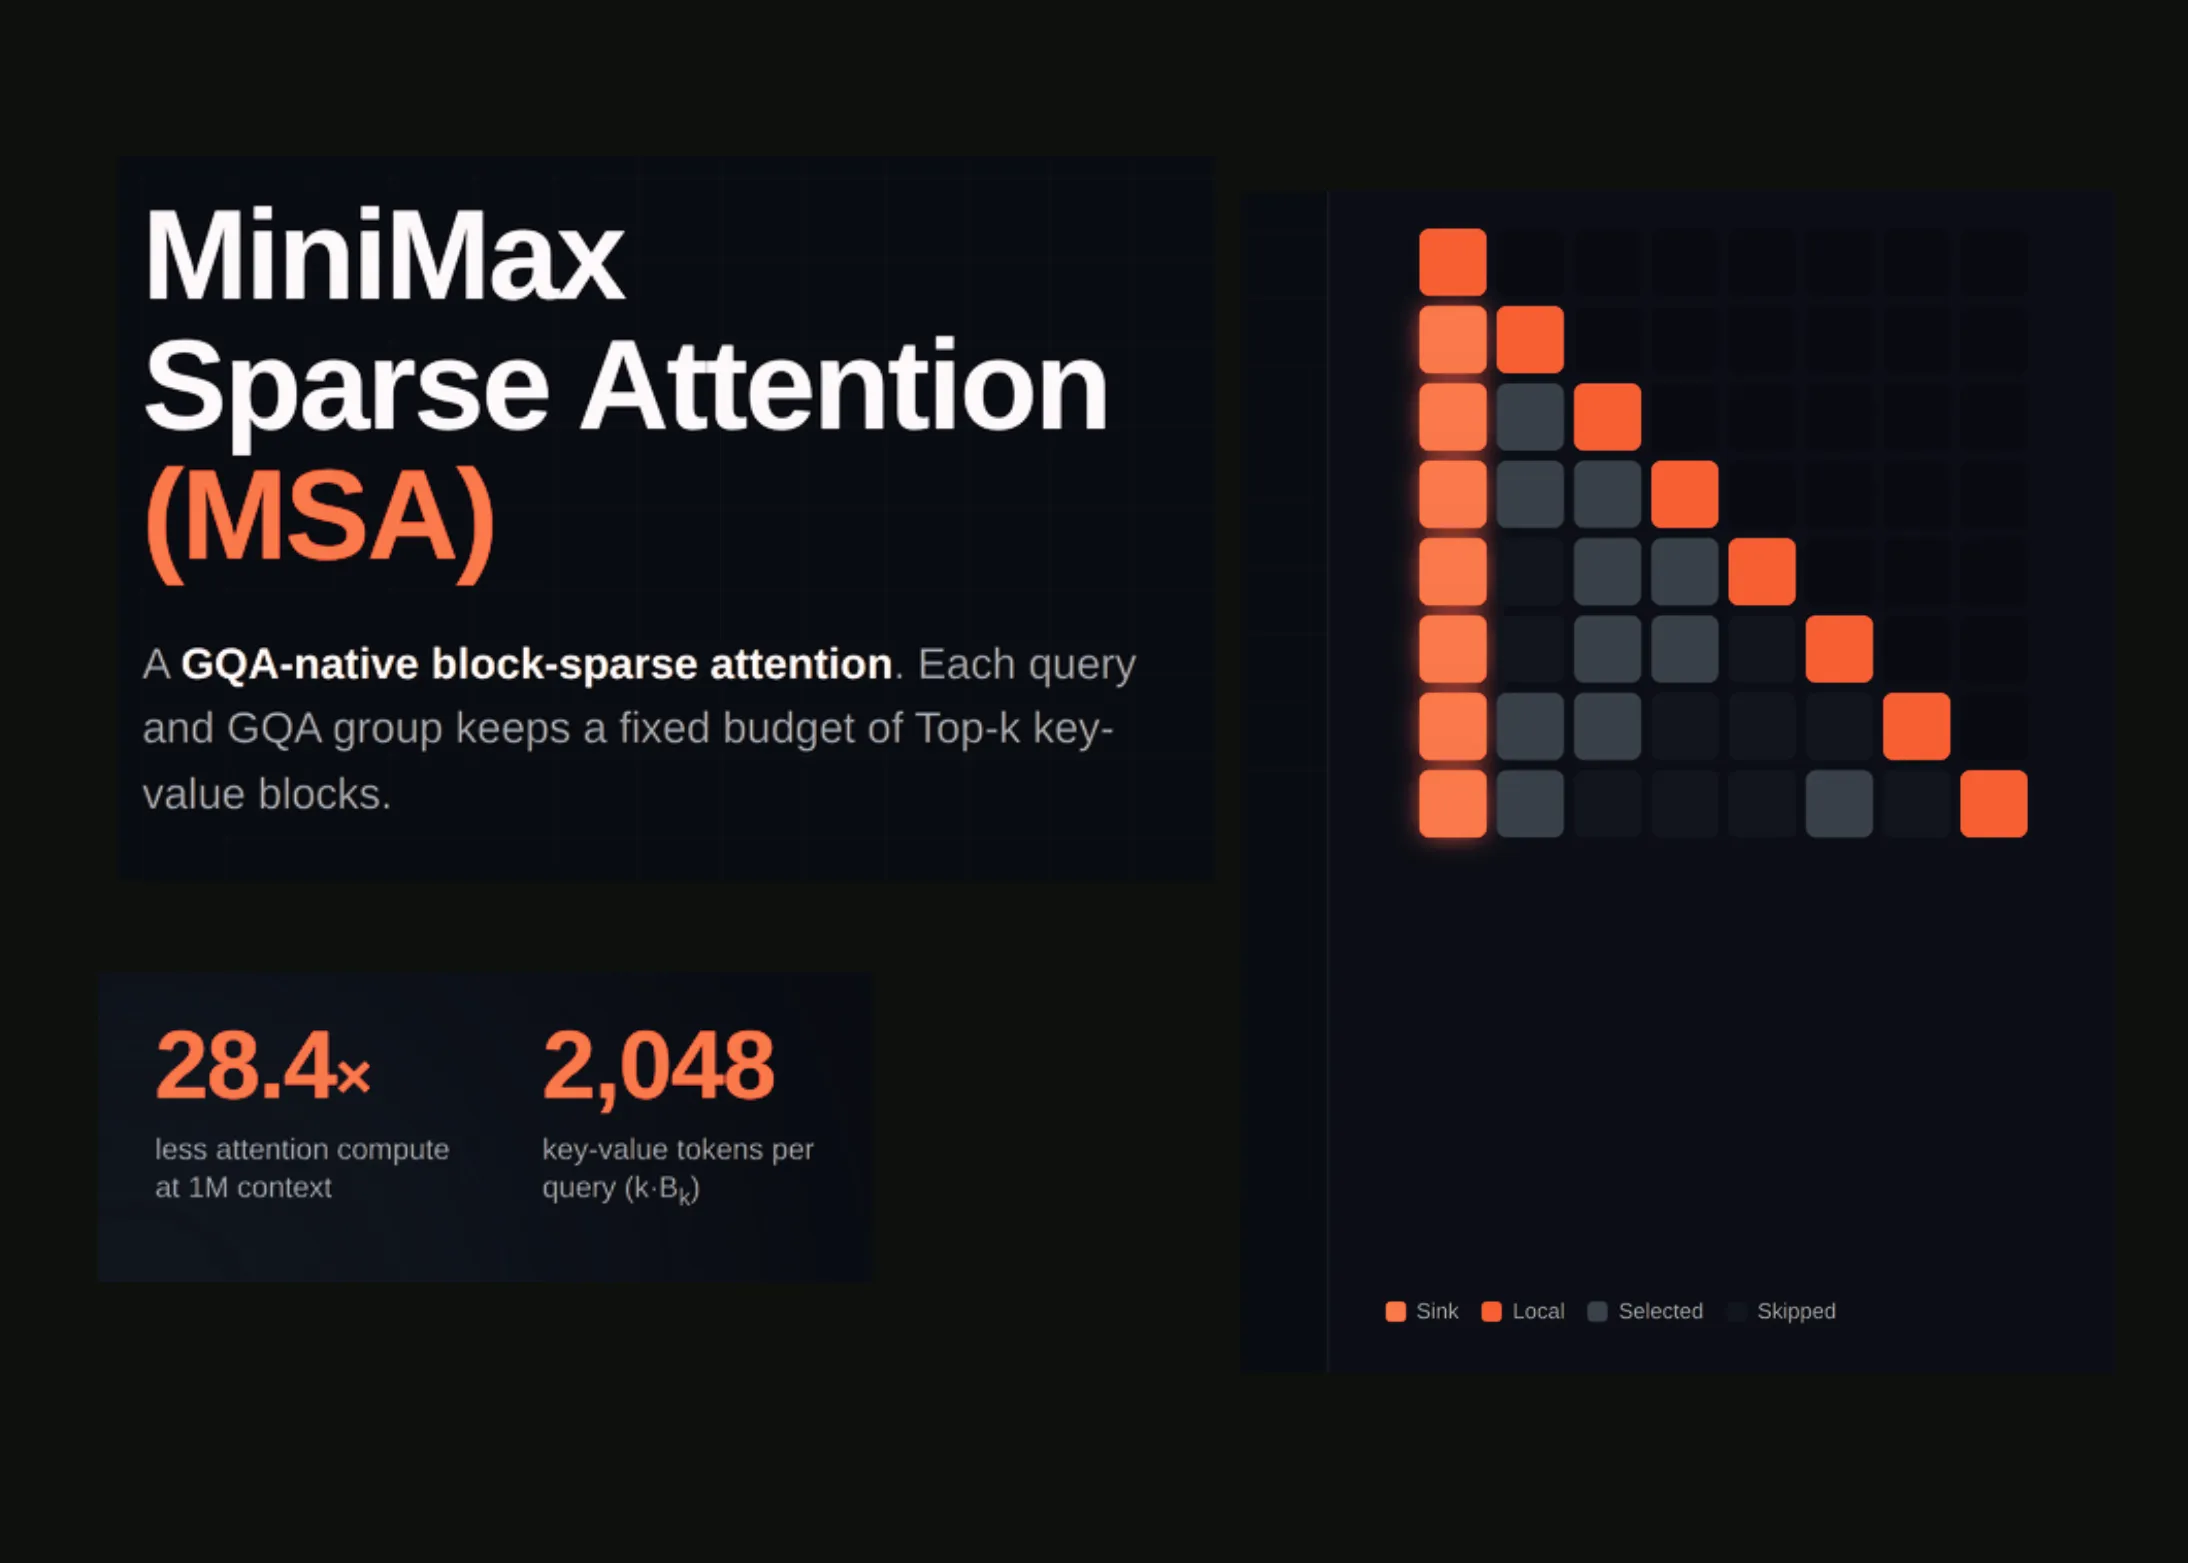
MiniMax Sparse Attention (MSA): O Revoluție în Atenția Dispersată cu Două Ramuri, Antrenată pe un Model MoE de 109 Miliarde de Parametri cu un Buget de 3 Tiloane de Token-uri
MiniMax Sparse Attention (MSA) este o arhitectură inovatoare de atenție dispersată cu două ramuri, antrenată pe un model MoE de 109 miliarde de parametri cu un buget de 3 trilioane de token-uri. MSA combină atenția locală și globală pentru a reduce costul computațional, permițând modelelor să gestioneze contexte mai lungi eficient. Această tehnologie ar putea democratiza accesul la AI și permite aplicații noi.