Subiect: #LLM
Implementare Cod pentru Microsoft SkillOpt: Optimizare Prompt Instrumentată, Analiză Evoluție Skill și Comparație cu Linia de Bază
Implementare practică a Microsoft SkillOpt pentru optimizarea prompturilor, incluzând configurarea, evaluarea liniei de bază, bucla de optimizare cu rollout, reflecție, agregare, selecție, actualizare și validare, plus analiza rezultatelor și comparația cu skill-ul original.
NVIDIA garak: Cum să construiești un flux complet de red-teaming defensiv pentru LLM-uri cu sonde și detectoare personalizate
Descoperă cum să folosești NVIDIA garak pentru a construi un workflow complet de red-teaming defensiv pentru LLM-uri, cu sonde și detectoare personalizate. Tutorial pas cu pas, de la instalare la analiza rezultatelor.
Revoluția prețurilor la GitHub Copilot: de ce plătesc acum dezvoltatorii mai mult pentru asistența AI
GitHub Copilot a trecut la facturarea pe bază de tokeni, ceea ce a dus la creșteri semnificative de costuri pentru dezvoltatori. Abonamentele au rămas la același preț, dar acum oferă un număr limitat de credite, consumate rapid în funcție de modelul AI utilizat. Reacțiile utilizatorilor variază de la șoc la resemnare, iar companiile trebuie să își regândească strategiile de adoptare a AI-ului.
Perplexity AI lansează open-source un tokenizer Unigram care reduce latența p50 de 5 ori față de crate-ul Hugging Face
Perplexity AI a lansat open-source un tokenizer Unigram care oferă o latență p50 de cinci ori mai mică decât Hugging Face tokenizers, promițând să accelereze procesarea textului în modelele de limbaj.
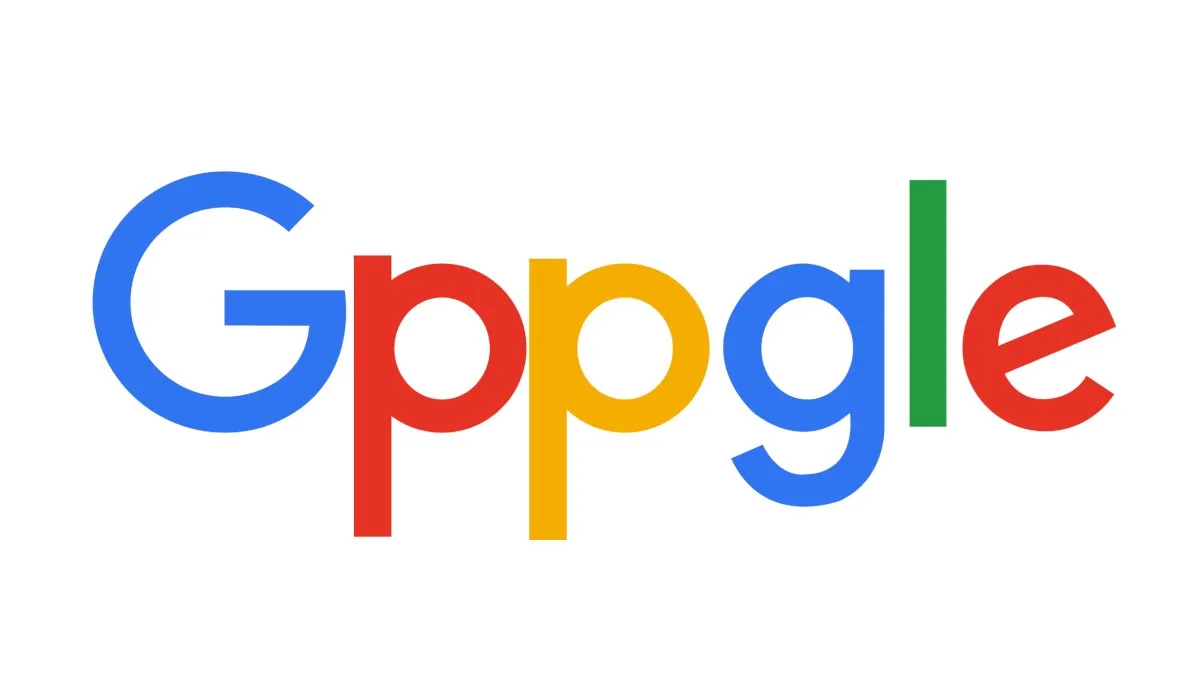
De ce inteligența artificială a Google nu poate scrie corect „Google” (sau orice alt cuvânt)
Google's AI Overview face greșeli de ortografie jenante, de la scrierea incorectă a propriului nume până la numărarea greșită a literelor. Articolul explică de ce modelele de limbaj mari nu pot ortografia corect, din cauza arhitecturii bazate pe tokeni, și subliniază importanța de a nu avea încredere oarbă în rezultatele AI.
EAGLE 3.1: Algoritmul de decodare speculativă care repară deriva atenției în inferența modelelor de limbaj
EAGLE 3.1 este un algoritm de decodare speculativă care corectează deriva atenției în inferența modelelor de limbaj, reducând latența cu până la 60% și menținând calitatea textului generat.
MEMO: Un cadru modular pentru antrenarea unui model de memorie dedicat pe cunoștințe noi, fără a modifica parametrii LLM
MEMO este un cadru modular care permite antrenarea unui model de memorie separat de LLM, facilitând actualizarea cunoștințelor fără a modifica parametrii originali. Aceasta reduce costurile, previne pierderea cunoștințelor și permite personalizarea, având potențialul de a revoluționa domeniul AI.
OpenRouter își dublează evaluarea la 1,3 miliarde de dolari într-un singur an
OpenRouter, un startup care oferă un gateway unificat pentru modele AI, a strâns 113 milioane de dolari într-o rundă Seria B, ajungând la o evaluare de 1,3 miliarde de dolari. Creșterea reflectă adoptarea tot mai mare a unei abordări multi-model în industrie.
Together AI lansează open-source OSCAR: un sistem de cuantizare a cache-ului KV pe 2 biți, conștient de atenție, pentru servirea LLM-urilor cu context lung
Together AI a lansat open-source OSCAR, un sistem de cuantizare a cache-ului KV pe 2 biți, care reduce memoria de 8 ori și accelerează decodarea de 3 ori pentru LLM-uri cu contexte lungi, menținând o acuratețe ridicată.
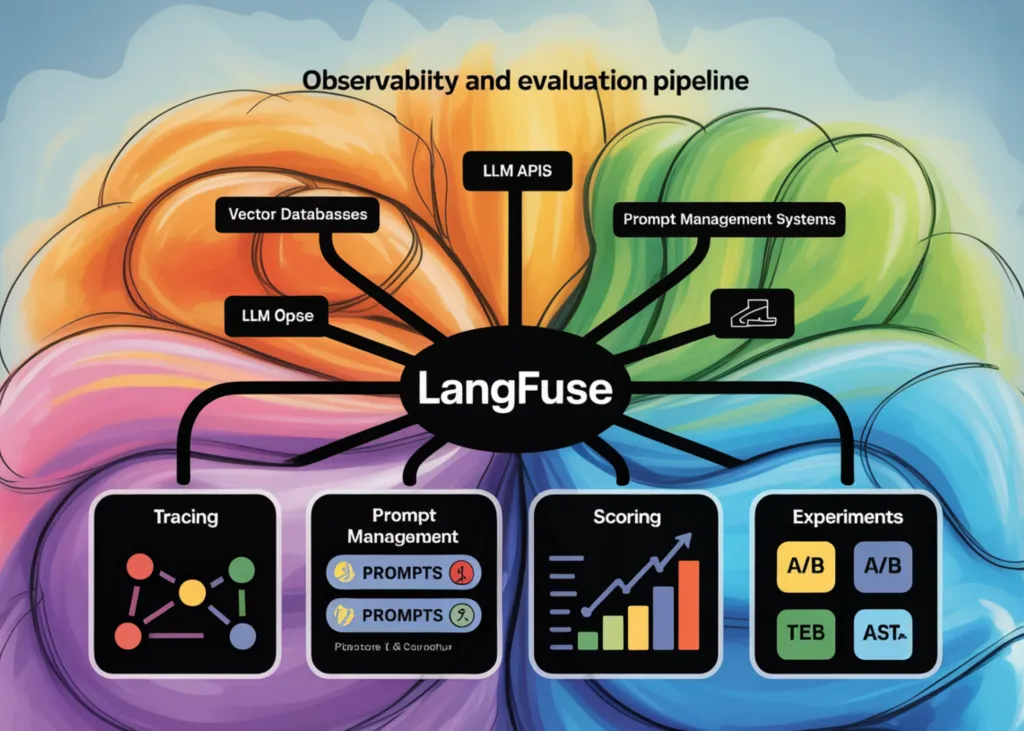
Construiește un Pipeline Complet de Observabilitate și Evaluare cu Langfuse: Urmărire, Gestionarea Prompturilor, Scoruri și Experimente
Descoperă cum să construiești un pipeline complet de observabilitate și evaluare cu Langfuse, incluzând urmărirea, gestionarea prompturilor, scoruri și experimente, pentru a optimiza aplicațiile bazate pe LLM-uri.

Cum redefinește CopilotKit stiva AI agentică în 2026
CopilotKit, un framework open-source pentru agenți AI, revoluționează stiva tehnologică în 2026 prin integrarea seamless cu React, suport pentru multiple LLM-uri și acțiuni personalizabile. Descoperă cum democratizează AI-ul și ce impact are asupra industriei.
Cohere lansează Command A+: Un model MoE de 218B parametri pentru fluxuri de lucru agentice, care rulează pe doar două GPU-uri H100
Cohere lansează Command A+, un model de 218 miliarde de parametri cu arhitectură Mixture of Experts, capabil să ruleze pe doar două GPU-uri H100. Modelul este optimizat pentru fluxuri de lucru agentice, stabilind noi recorduri de performanță și democratizând accesul la AI avansat.