Subiect: #Inferență AI
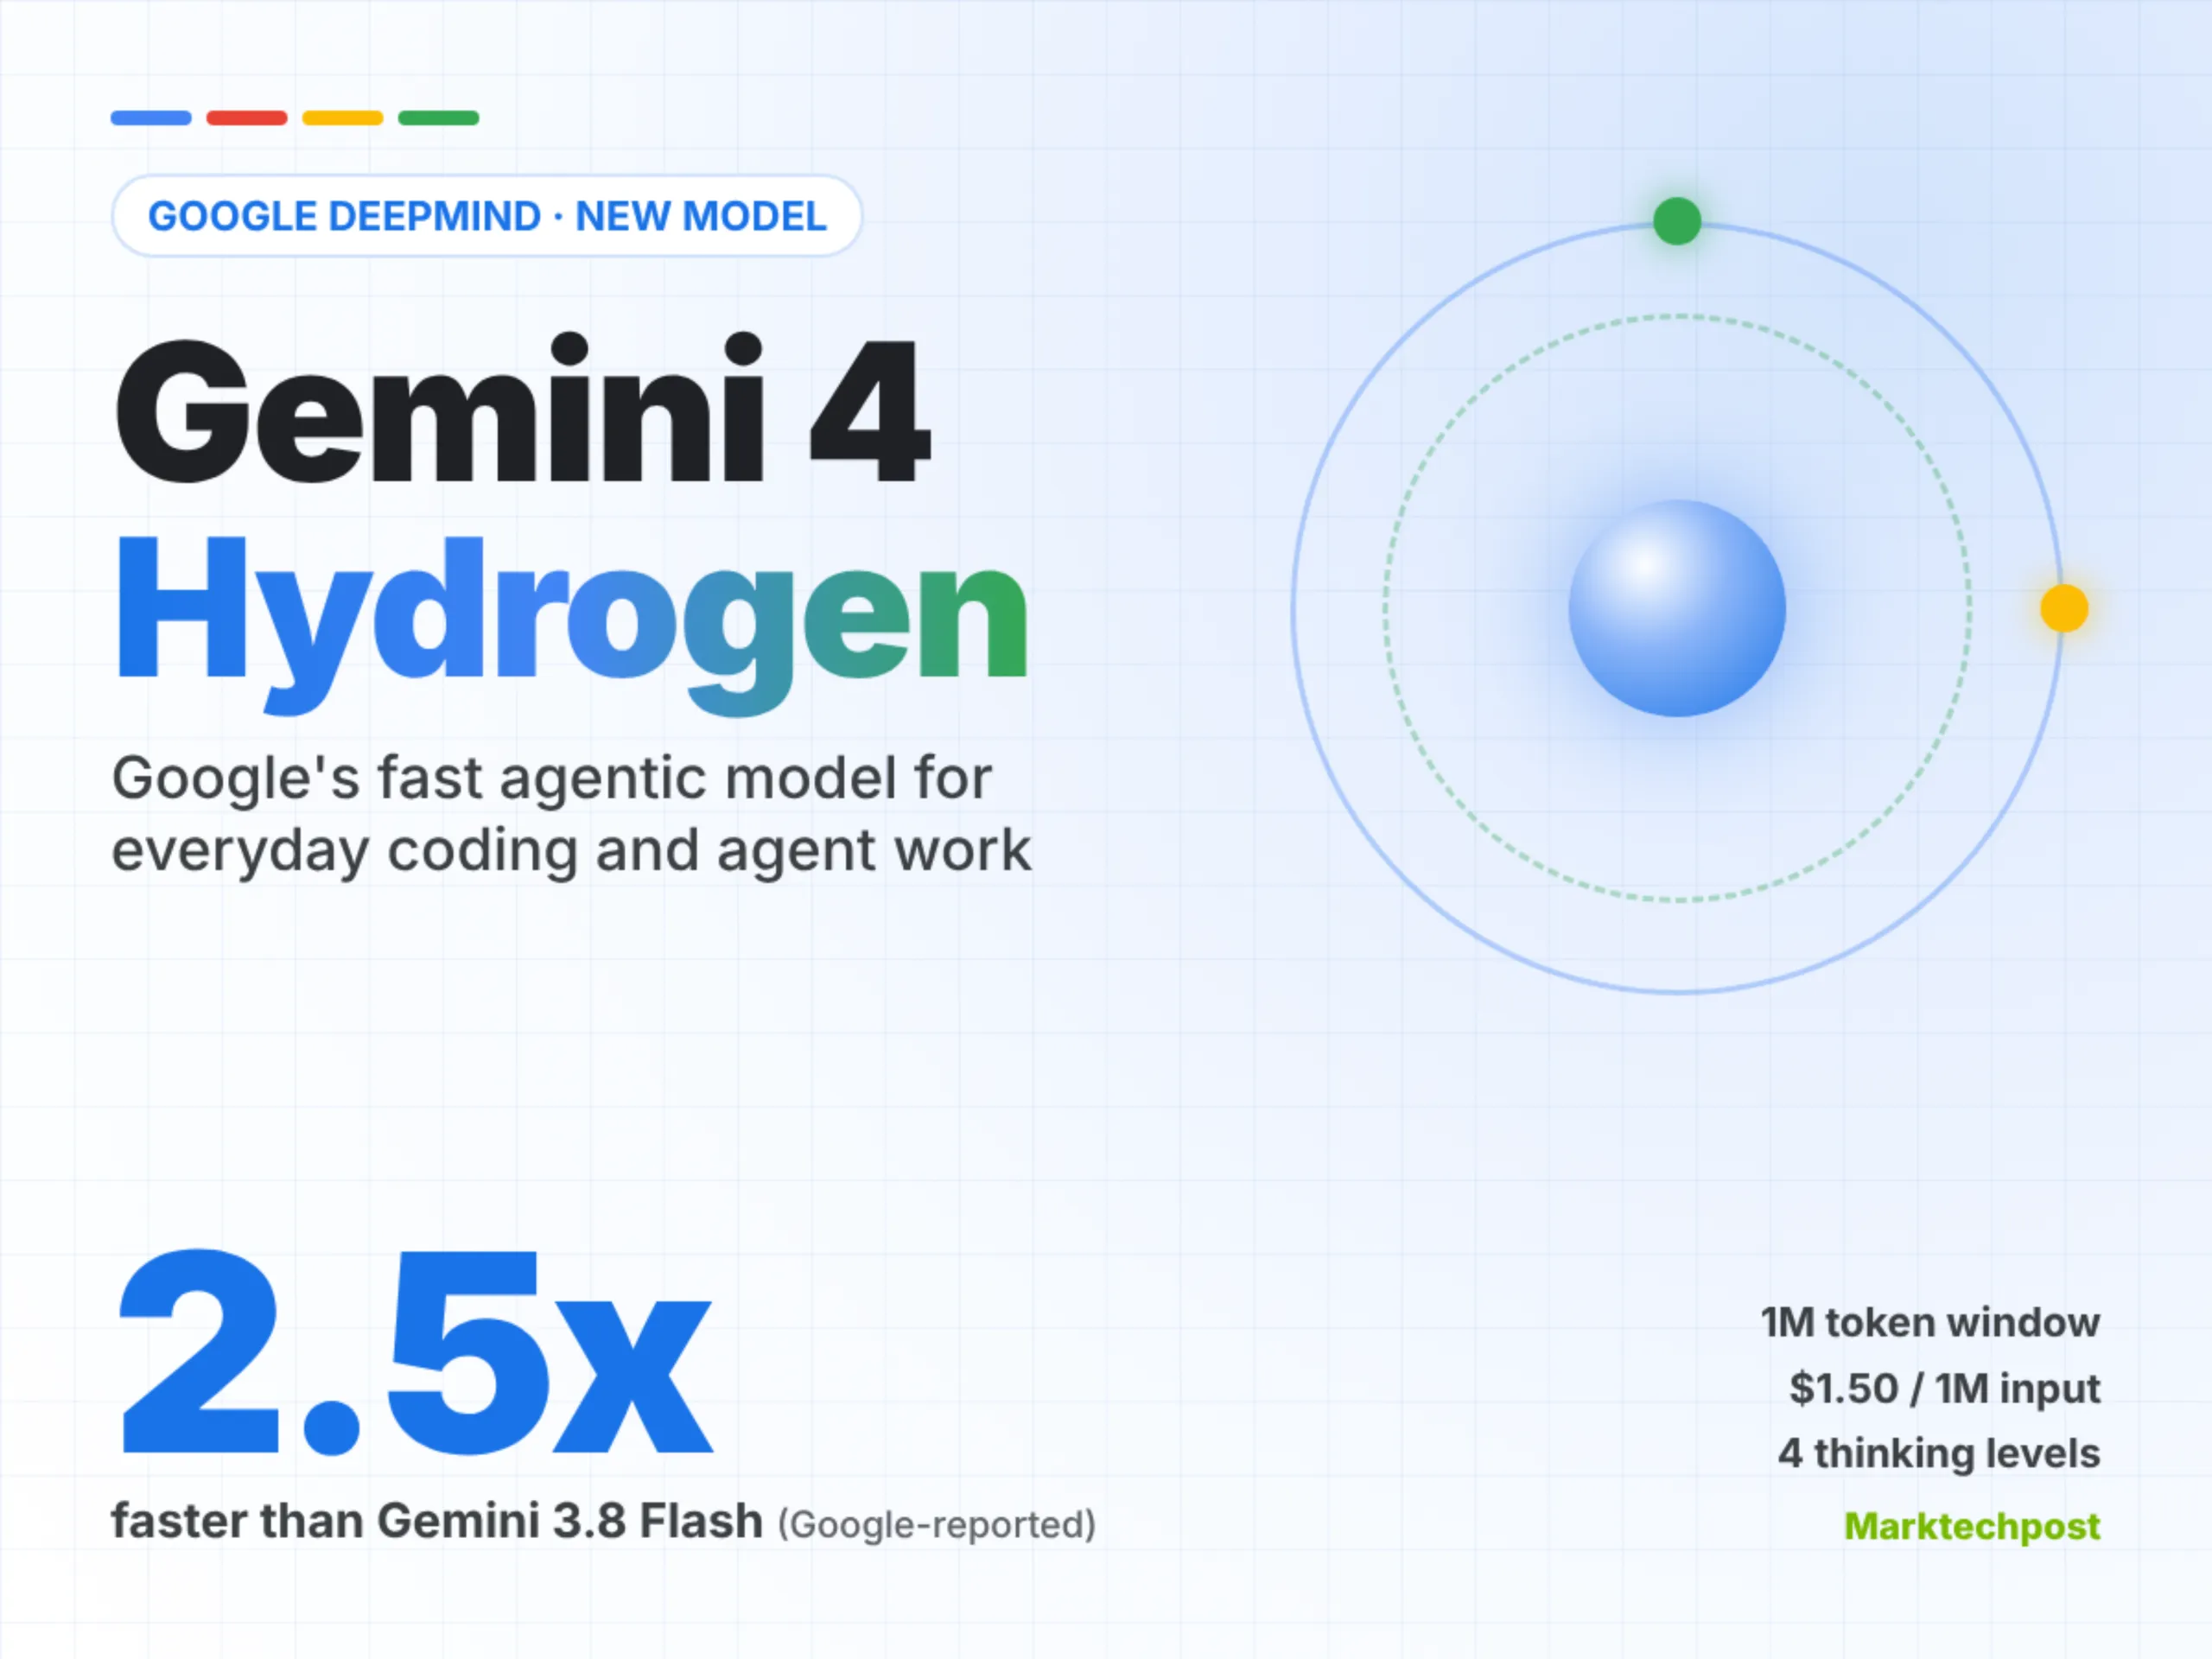
Google lansează Gemini 4 Hydrogen: O sărită uriașă în viteză, lăsând în urmă Gemini 3.8 Flash cu 2,5 ori
Google lansează Gemini 4 Hydrogen, un model care oferă o viteză de 2,5 ori superioară față de Gemini 3.8 Flash. Analizăm arhitectura MoE optimizată, impactul economic devastător pe costul inferenței, avantajul strategic al TPU-urilor Trillium și ce înseamnă asta pentru viitorul agentilor AI și competiția cu OpenAI și Anthropic.
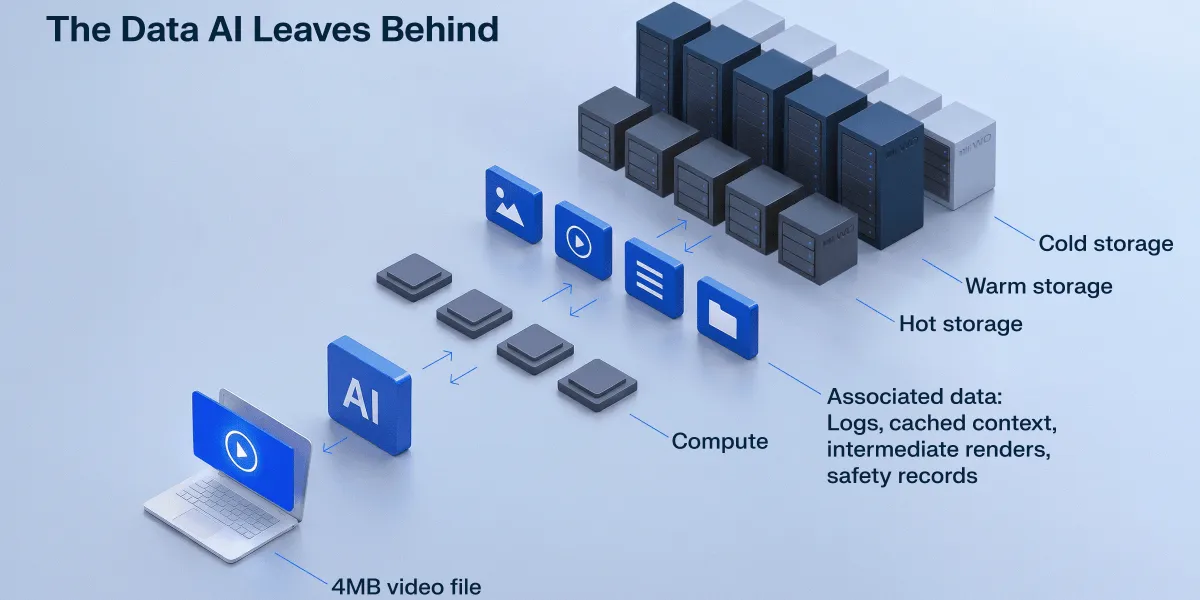
Factura ascunsă a stocării în AI: Ce rămâne după inferență și de ce costurile explodă tăcut
Articolul evidențiază costul ascuns al stocării datelor în infrastructura AI, demonstrând că inferența generează volume masive de date de back-end (până la 130x output-ul vizibil), care depășesc bugetele dacă nu sunt planificate pe tier-uri (HDD pentru arhivă activă, SSD pentru cald). Ignorarea acestui aspect blochează GPU-urile și transformă stocarea din "eroare de rotunjire" în cheltuie majoră neprevăzută.
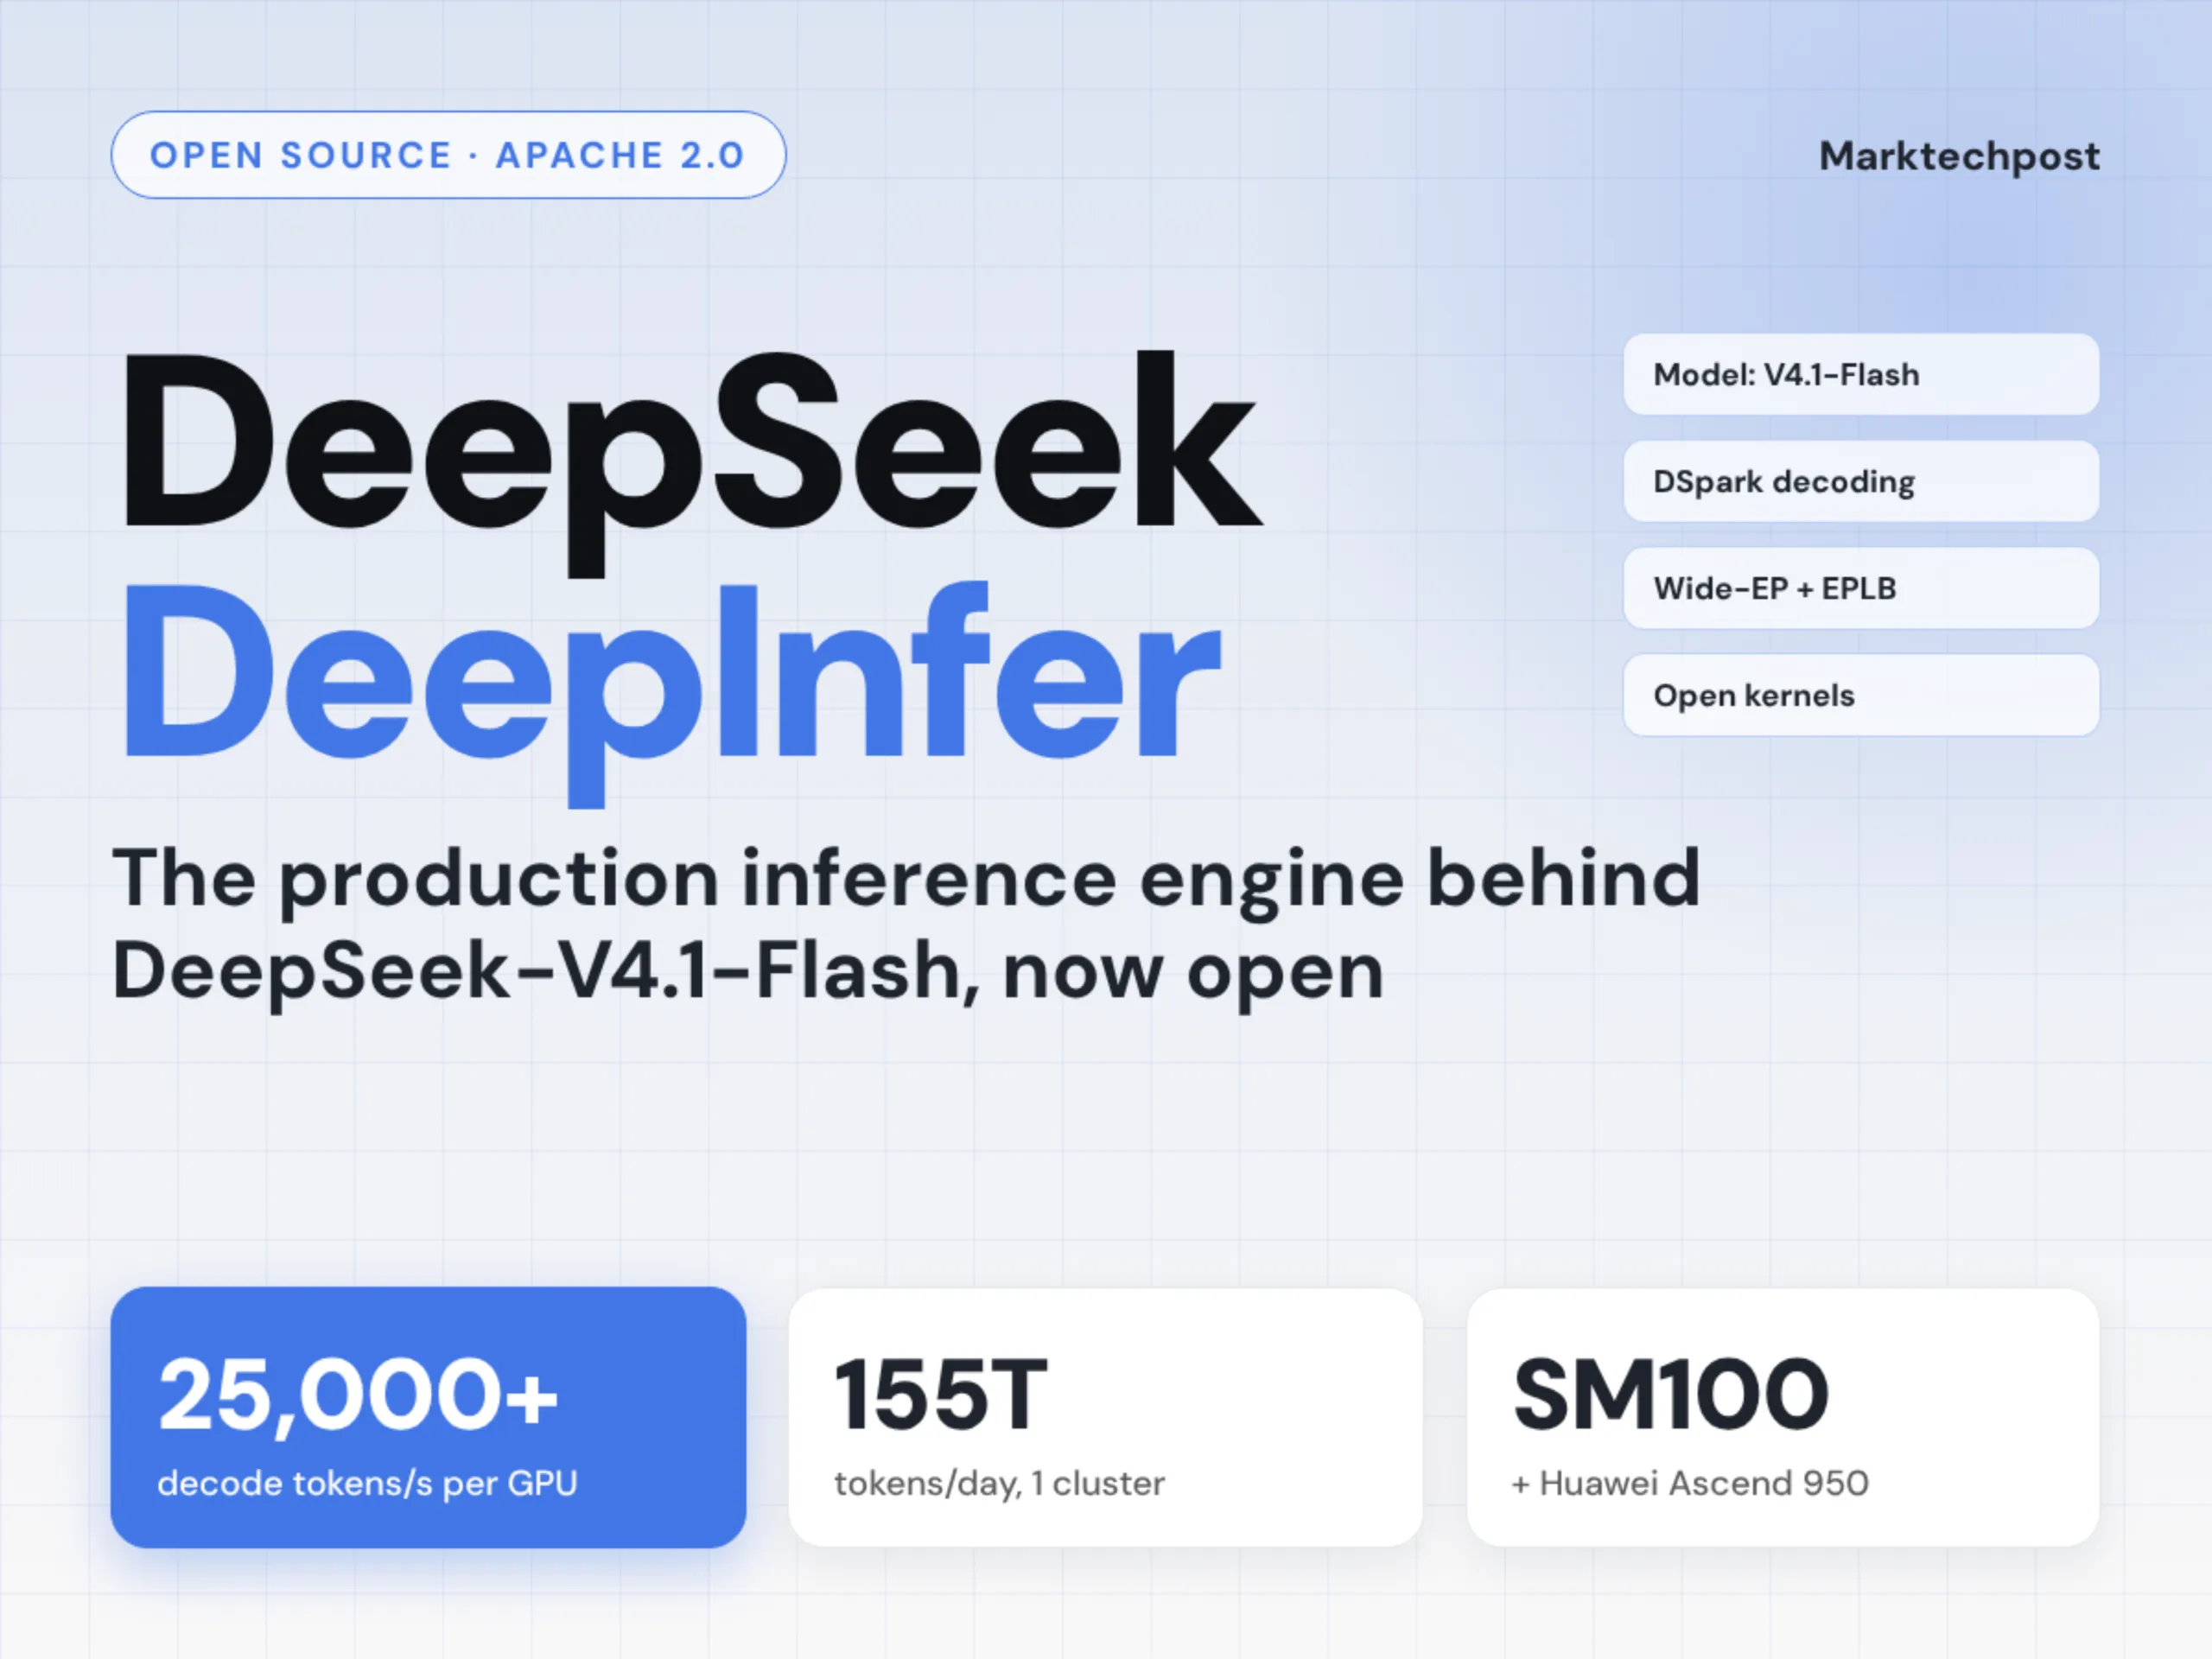
DeepSeek deschide codul sursă al framework-ului DeepInfer: motorul invizibil care alimentează V4.1-Flash și schimbă regulile jocului în inferența AI
DeepSeek lansează DeepInfer open-source: framework-ul de inferență care alimentează V4.1-Flash și reduce costurile de 3-5x pe hardware commoditizat. O analiză profundă a arhitecturii, a implicațiilor geopolitice și a oportunităților pentru dezvoltatorii europeni.
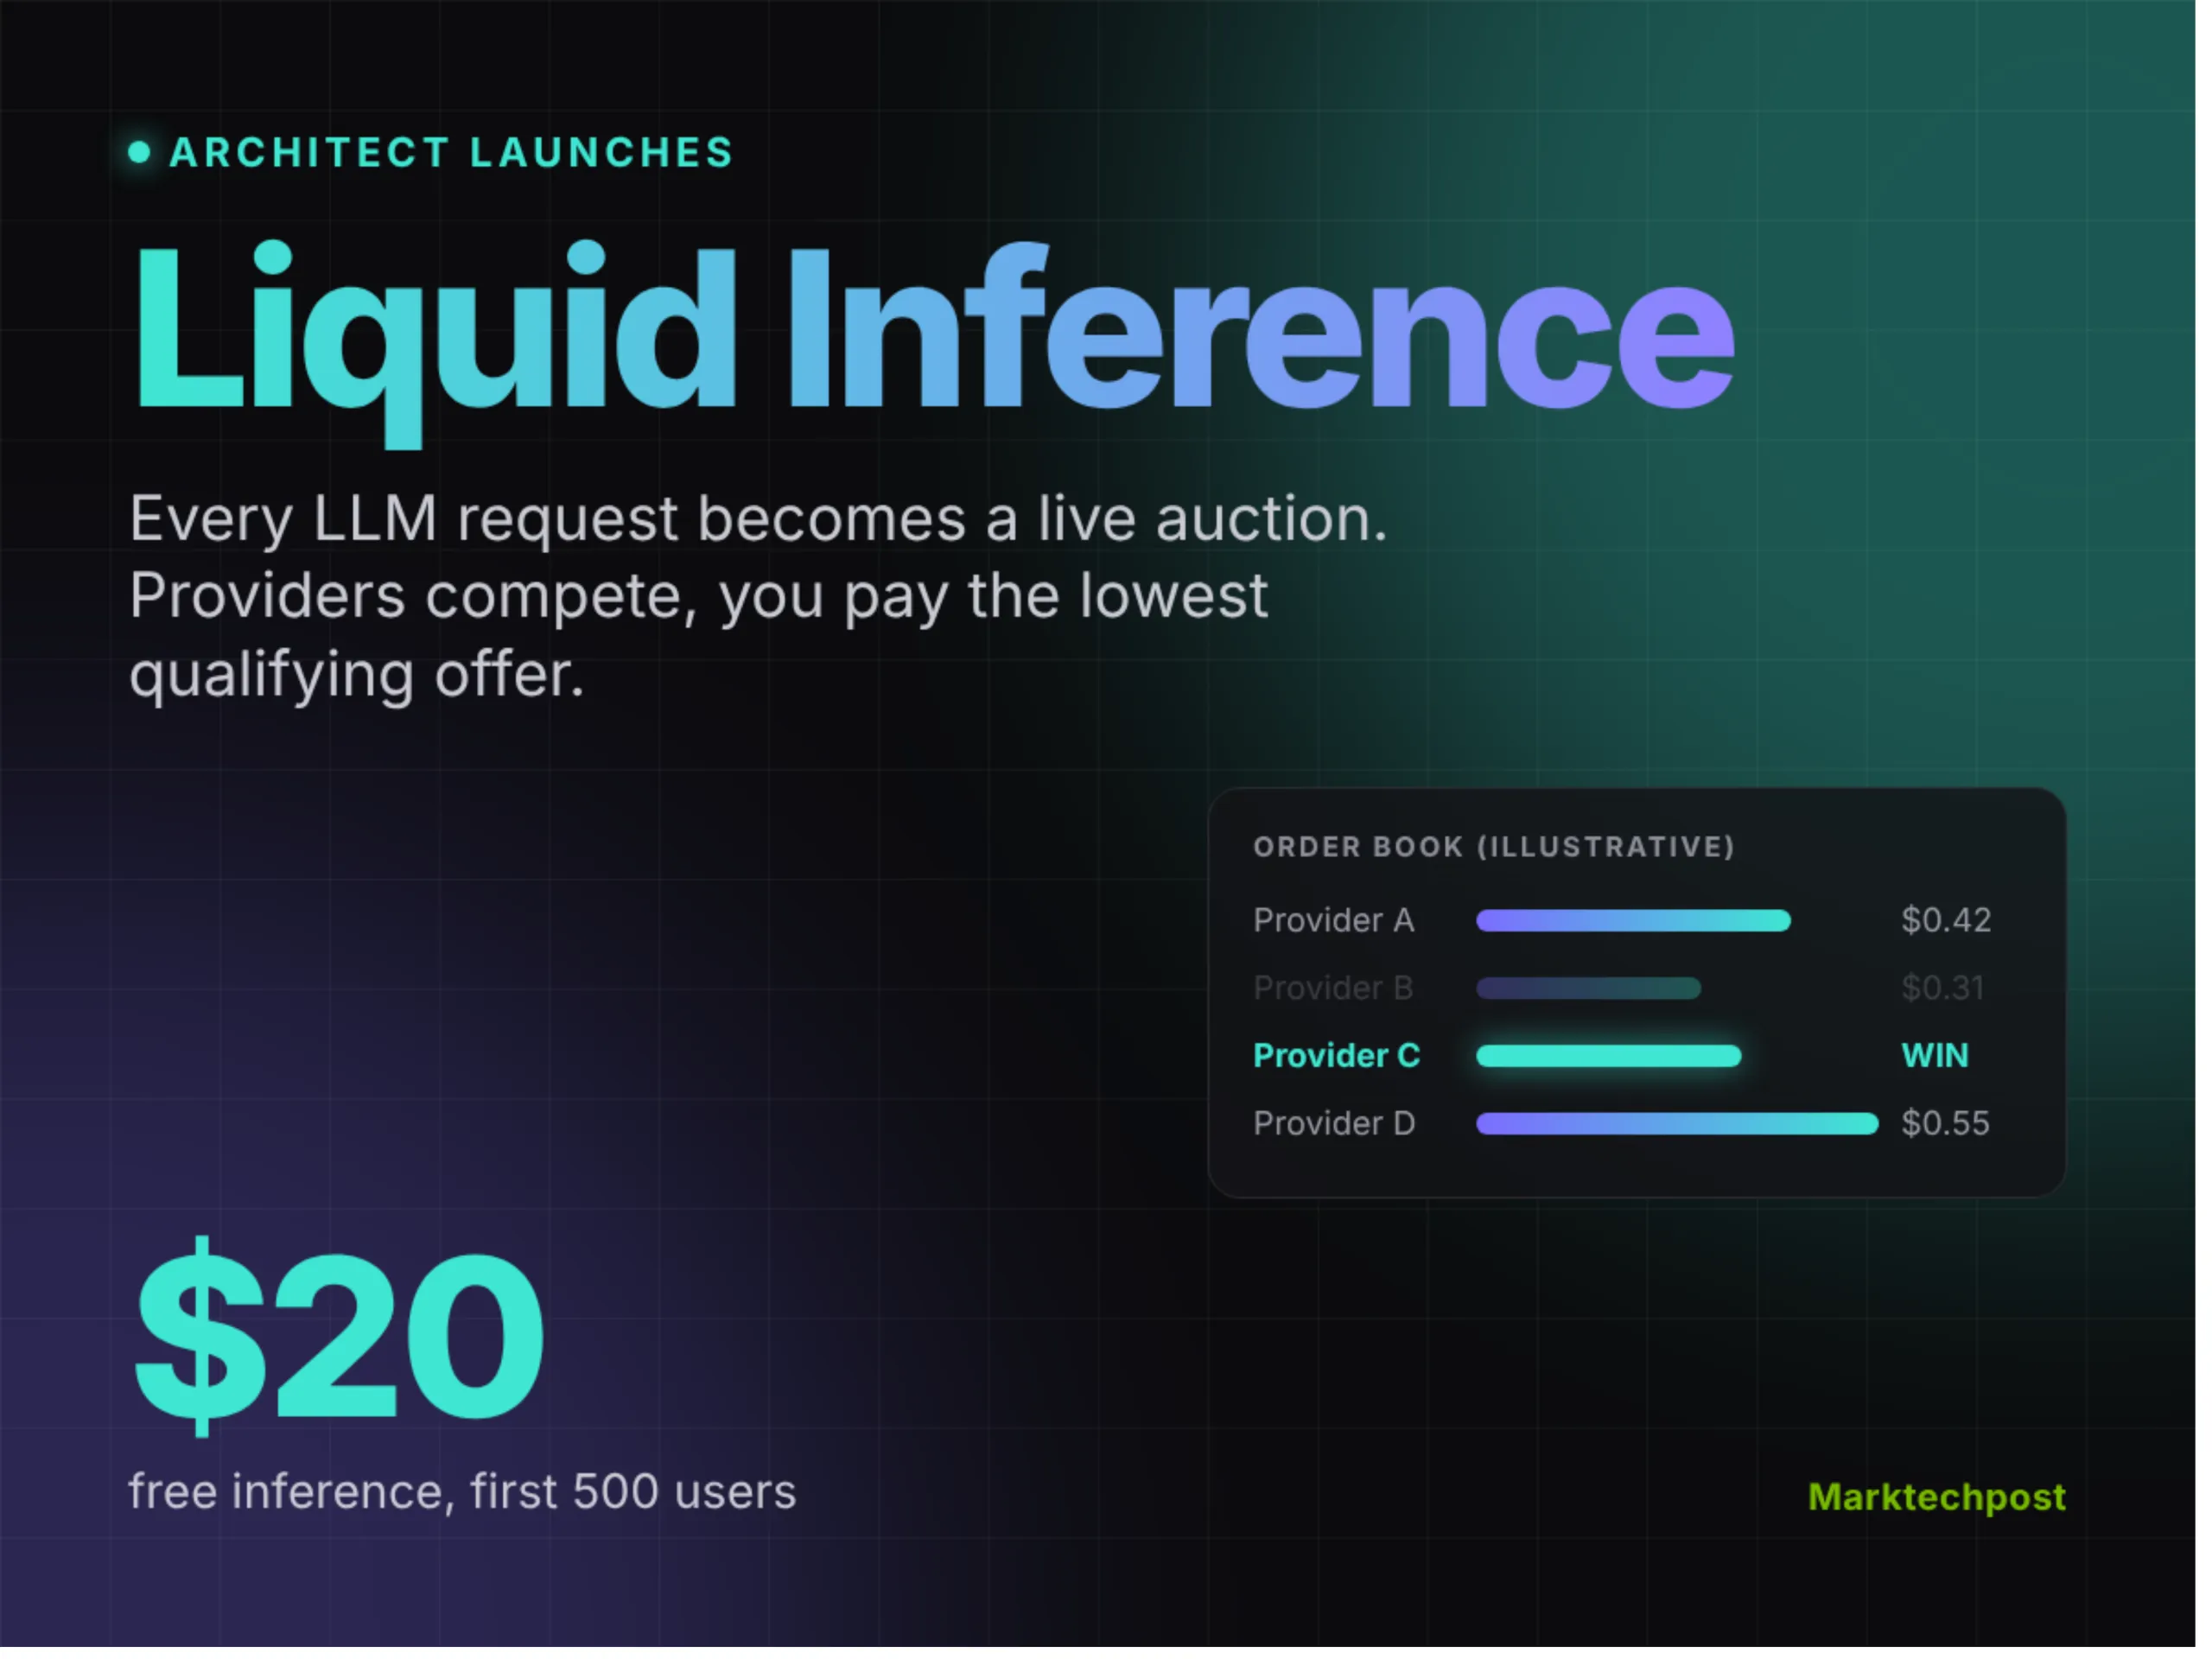
Architect lansează Liquid Inference: licitația în timp real care ar putea schimba economia inferenței pentru modelele lingvistice
Compania Architect lansează Liquid Inference, o piață în timp real unde capacitatea de calcul pentru modelele lingvistice mari este licitată la nivel de milisecundă. O idee care ar putea reduce risipa uriașă din centrele de date AI și ar putea democratiza accesul la inteligența artificială — dar care ridică și întrebări serioase despre guvernanță, securitate și echitate.
Arhitectarea memoriei și a stocării în era inferenței AI: De ce infrastructura devine avantaj competitiv
În era inferenței AI, infrastructura legacy devine un blocaj. Memoria, stocarea și rețeaua nu mai sunt hardware de suport, ci active strategice care dictează latența, costul și capacitatea de inovație. Articolul analizează de ce arhitectura pipeline-ului de date – nu mărimea clusterului GPU – este noul avantaj competitiv, bazându-se pe perspectivele expertului Jim McGregor (Tirias Research).
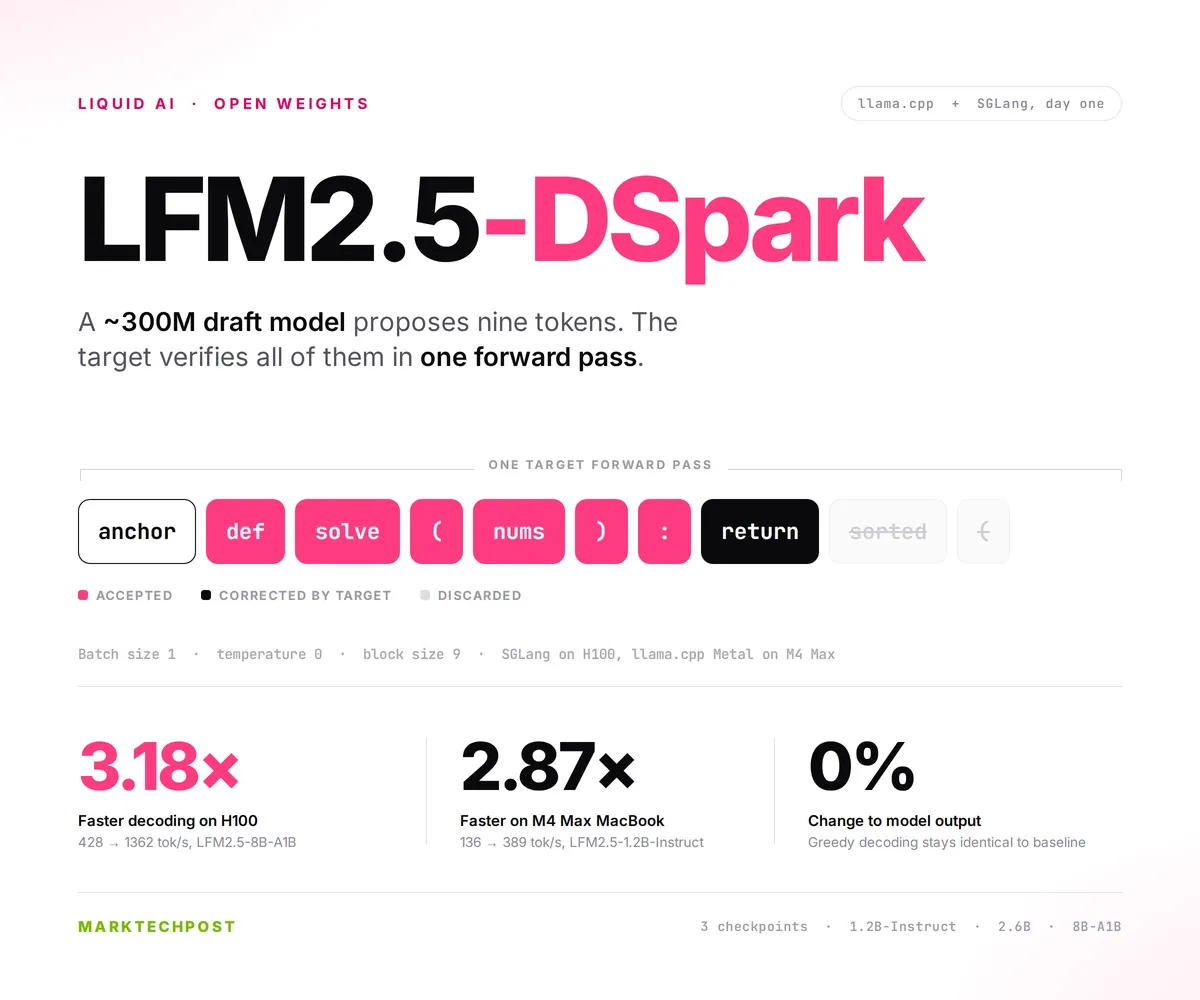
Liquid AI lansează modelele draft LFM2.5-DSpark: decodare de până la 3,18 ori mai rapidă, fără a schimba rezultatele
Liquid AI a lansat modelele draft LFM2.5-DSpark, care accelerează decodarea de până la 3,18 ori fără a modifica rezultatele. Această inovație promite inferență mai rapidă, costuri reduse și o experiență îmbunătățită pentru utilizatorii de aplicații AI.

Kog: Cum să obții inferență AI de 30 de ori mai rapidă pe GPU-urile pe care le ai deja
Startup-ul francez Kog promite o inferență AI de 30 de ori mai rapidă pe GPU-urile standard, printr-o optimizare software profundă. Cu o demonstrație de 3.000 de tokeni pe secundă și un fondator cu background în fizică și hacking, Kog atrage deja interesul pieței, vizând în special ingineria software.

Startupul de cipuri AI Etched sfidează scepticii și atinge o evaluare de 10,3 miliarde de dolari de la investitori de renume
Startupul Etched, fondat de trei foști studenți Harvard, a strâns 300 de milioane de dolari la o evaluare de 10,3 miliarde, sfidând scepticii cu cipuri AI specializate pentru inferență rapidă și eficientă.

De ce primii finanțatori de GPU-uri se orientează acum către cipuri de inferență, într-o tranzacție de 400 de milioane de dolari
General Compute, un startup de cloud AI, a obținut un împrumut de 400 de milioane de dolari de la Upper90, folosind cipuri de inferență ca garanție. Este prima tranzacție de acest gen și semnalează o schimbare majoră de la GPU-urile scumpe la soluții mai eficiente pentru rularea modelelor AI open-source.
NVIDIA lansează Nemotron-Labs-3-Puzzle-75B-A9B: un model lingvistic hibrid MoE comprimat care oferă o performanță de server de 2,03 ori mai mare la același debit per utilizator
NVIDIA a lansat Nemotron-Labs-3-Puzzle-75B-A9B, un model lingvistic hibrid MoE comprimat, care oferă o performanță de server de 2,03 ori mai mare decât predecesorul său, la același debit per utilizator. Modelul folosește o tehnică inovatoare de compresie structurală iterativă, reducând parametrii de la 120,7B la 75,3B, și permite o concurență de 8 ori mai mare pe un singur GPU H100.

SambaNova, producătorul de cipuri AI, atrage 1 miliard de dolari la o evaluare de 11 miliarde, la doar 5 luni după ultima rundă uriașă
SambaNova Systems a strâns 1 miliard de dolari la o evaluare de 11 miliarde, la doar cinci luni după ultima rundă majoră. Compania, specializată în cipuri AI pentru inferență, a atras atenția JPMorgan ca partener de infrastructură și colaborează strâns cu Intel. Runda subliniază creșterea explozivă a pieței de inferență AI și tendința marilor bănci de a-și construi propriile centre de date sigure.

Concurentul Nvidia, Etched, atinge o evaluare de 5 miliarde de dolari și vânzări de 1 miliard pentru cipul AI
Startup-ul Etched, rival al Nvidia, a atins o evaluare de 5 miliarde de dolari și a înregistrat comenzi de 1 miliard de dolari pentru cipurile sale AI specializate în inferență. Fondat de foști studenți Harvard, compania a strâns 800 de milioane de dolari de la investitori de top și promite să revoluționeze eficiența și costurile în domeniul inteligenței artificiale.